前置说明
GPU 程序的性能问题可能出在不同层级,简要概括如下
| 序号 | 层次 | 典型问题 |
|---|---|---|
| 1 | host 与 device 之间 | H2D/D2H 拷贝、pinned memory、stream 重叠 |
| 2 | kernel 之间 | launch 开销、kernel 融合、CUDA Graph |
| 3 | 单个 kernel 内部的访存 | 合并访存、内存事务粒度、bank conflict |
| 4 | 单个 kernel 内部的计算 | 指令吞吐、occupancy、Tensor Core 利用率 |
| 5 | device 之间 | NVLink、P2P、NCCL |
本次的所有内存优化实践,都是单个 kernel 内部的访存(memory access)行为,范围不超过一个 device。
理论知识参考:CUDA 中的内存组织 ,这里不再赘述,仅关注实验验证。
环境参数查询
| 参数 | 结果 | 命令 |
|---|---|---|
| GPU 型号 | NVIDIA H200 | nvidia-smi -q -i 0 |
| NVIDIA 驱动 | 550.127.08 | nvidia-smi -q -i 0 |
| 架构 / 计算能力 | Hopper / 9.0 | nvidia-smi -q -i 0 |
| CUDA 可见显存 | 143072 MB | {CUDA 安装路径}/extras/demo_suite/deviceQuery |
| L2 cache | 60 MiB | {CUDA 安装路径}/extras/demo_suite/deviceQuery |
| SM 数量 | 132 | {CUDA 安装路径}/extras/demo_suite/deviceQuery |
| Warp size | 32 | {CUDA 安装路径}/extras/demo_suite/deviceQuery |
| 每 block 最大线程数 | 1024 | {CUDA 安装路径}/extras/demo_suite/deviceQuery |
| 每 block 默认 shared memory 上限 | 48 KB | {CUDA 安装路径}/extras/demo_suite/deviceQuery |
| 操作系统 | Ubuntu 22.04.5 LTS | grep ‘^PRETTY_NAME=’ /etc/os-release |
| GCC / G++ | 11.4.0 | g++ –version |
| CUDA / NVCC | 12.4 / 12.4.131 | nvcc –version |
| Nsight Compute | 2024.1.1.0 | ncu –version |
| Compute Sanitizer | 2024.1.1.0 | compute-sanitizer –version |
H200 官方规格详见:https://www.nvidia.com/en-us/data-center/h200/
根据当前环境参数信息,我们可以计算出,理论上最多可同时驻留的 CUDA 线程数:2048 线程/SM × 132 SM = 270336,大约是 27 万。
实际驻留的 CUDA 线程数量取决于 kernel 的资源占用和启动配置,驻留线程不一定都在同一时刻执行指令。同时,一次 kernel 启动的总线程数可以远超过这个上限。
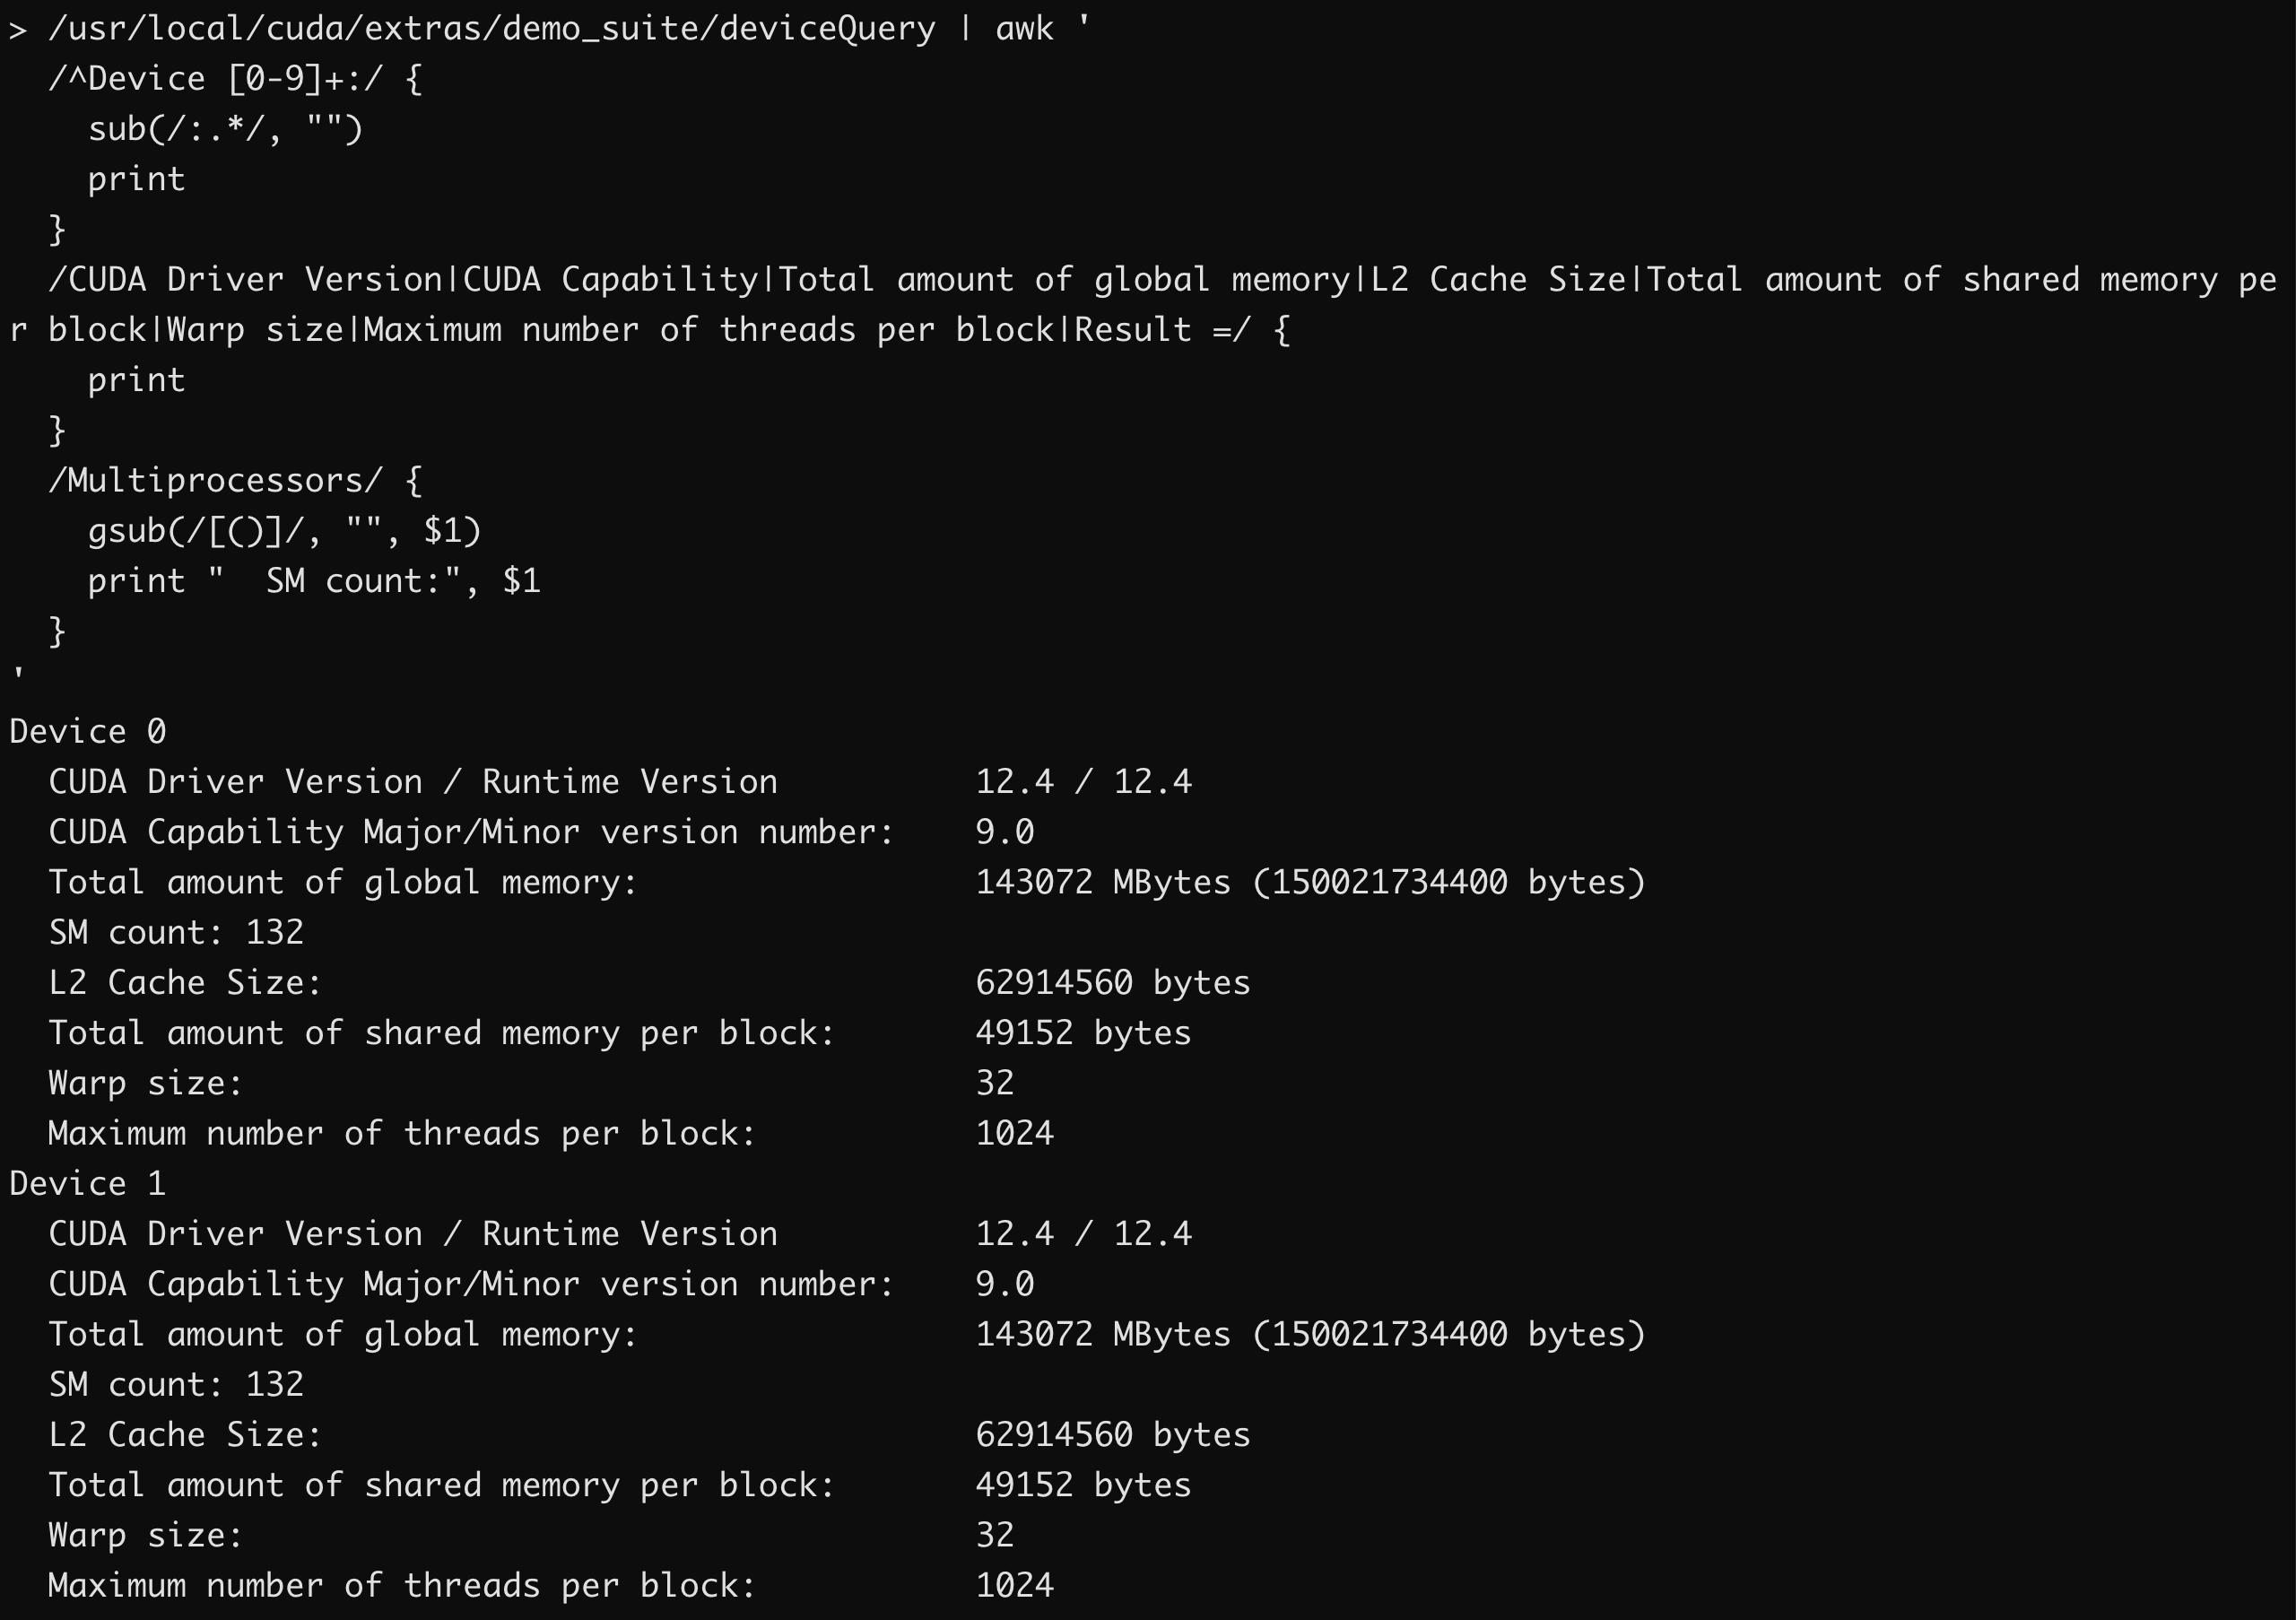
CUDA 设备参数查询
/usr/local/cuda/extras/demo_suite/deviceQuery | awk '
  /^Device [0-9]+:/ { print }
  /CUDA Driver Version|CUDA Capability|Total amount of global memory|L2 Cache Size|Total amount of shared memory per block|Warp size|Maximum number of threads per block|Result =/ {
    print
  }
  /Multiprocessors/ {
    gsub(/[()]/, "", $1)
    print "  SM count:", $1
  }
'
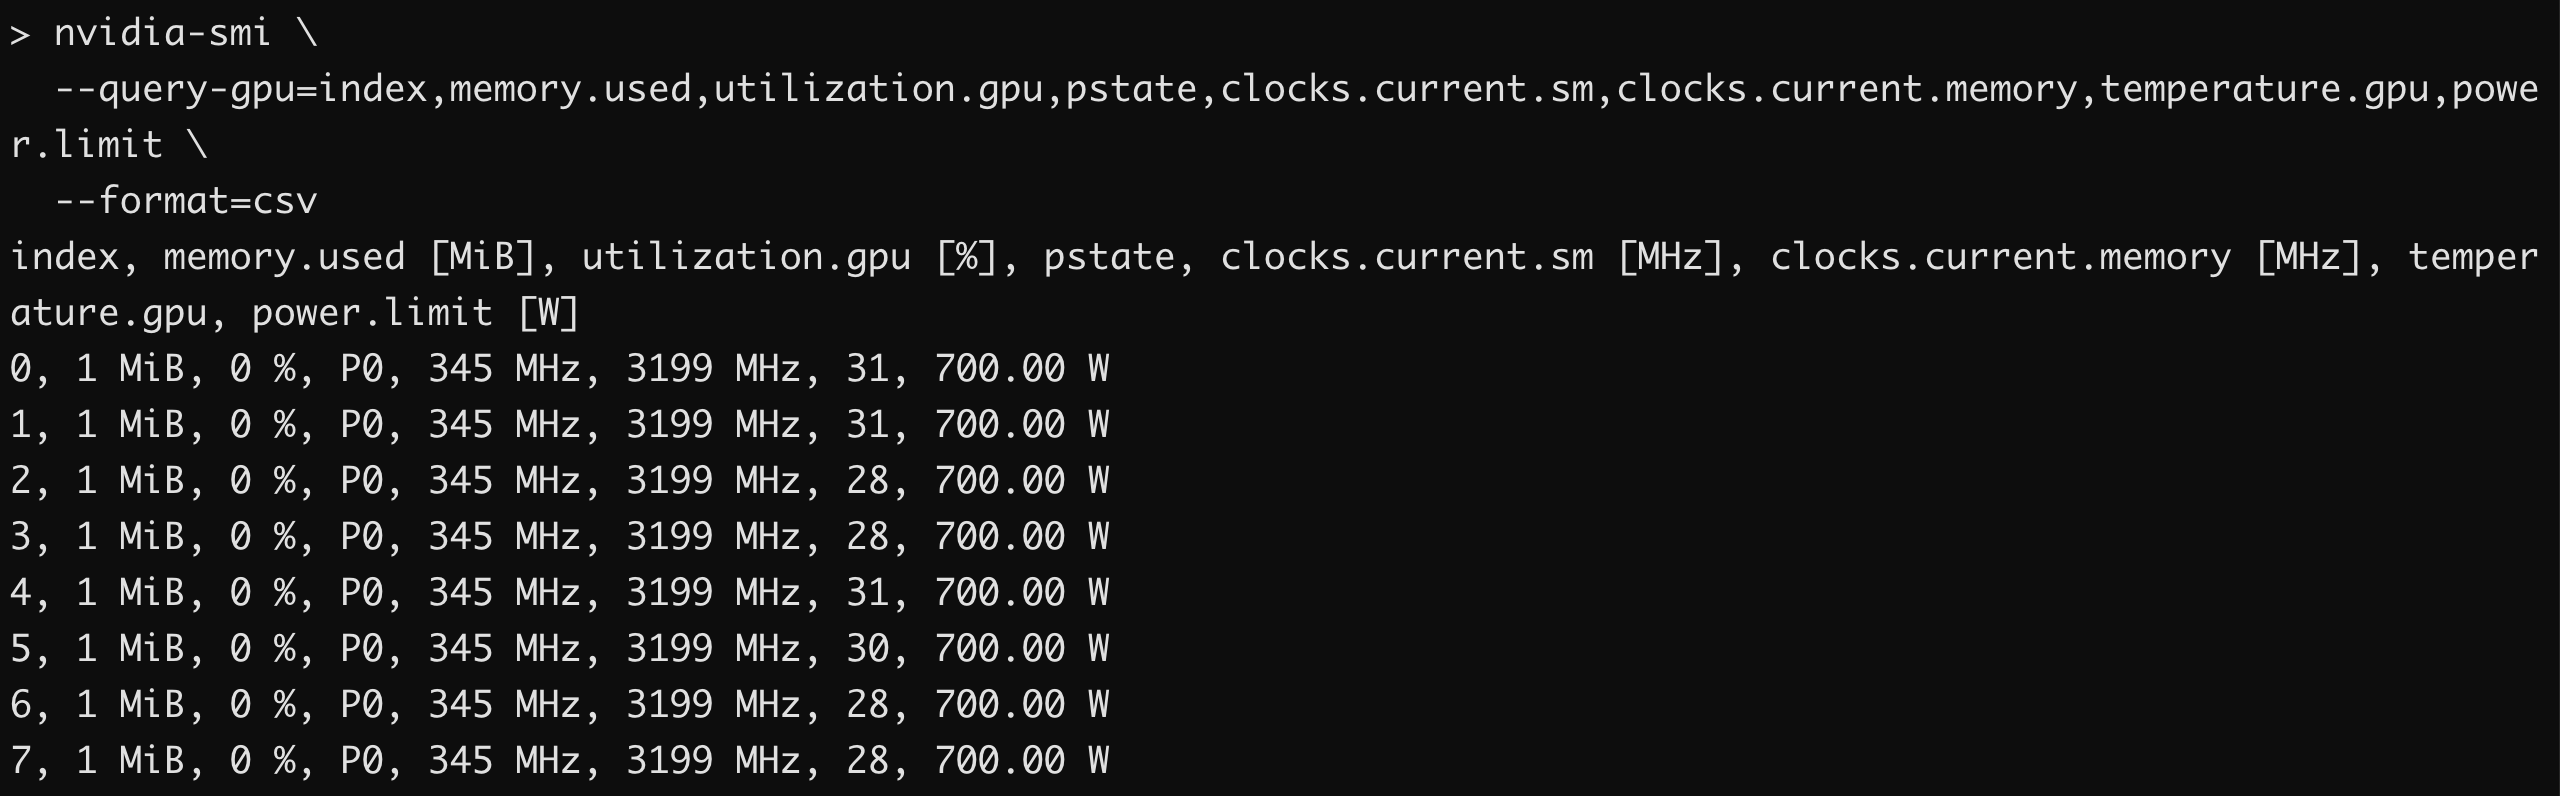
检查占用、时钟、温度和功率上限
nvidia-smi \
  --query-gpu=index,memory.used,utilization.gpu,pstate,clocks.current.sm,clocks.current.memory,temperature.gpu,power.limit \
  --format=csv
shared memory bank conflict 相关命令
查询可用指标
/usr/local/cuda/bin/ncu \
  --query-metrics \
  --query-metrics-mode suffix \
  --metrics l1tex__data_bank_conflicts_pipe_lsu_mem_shared_op_ld,l1tex__data_bank_conflicts_pipe_lsu_mem_shared_op_st \
  | awk '/^l1tex__.*\.sum[[:space:]]/ { print $1 }'
数据采集
/usr/local/cuda/bin/ncu \
  --section MemoryWorkloadAnalysis_Tables \
  --metrics l1tex__data_bank_conflicts_pipe_lsu_mem_shared_op_ld.sum \
  --page raw \
  -o bank-conflicts \
  ./cuda_program
计时方式
由于 kernel launch 相对 host 线程是异步的,若 host 侧的计时器不加同步,那么计算得出的时间是启动调用的返回时间,而不是真正设备完成的时间。但若在 host 侧加 cudaDeviceSynchronize 同步后计时,则会阻碍当前 host 线程,计算得出的时间混进了 host 侧的启动与同步开销。
好在 CUDA 提供了事件(CUDA event)。CUDA events 使用设备侧时间戳测量同一 stream 中两个事件之间的经过时间,避免把 host 等待同步返回的额外耗时直接计入结果。在没有明显提交空档及其他工作干扰时,这个间隔可用于近似测量被包围 kernel 的执行耗时。
因此,在后续的实验当中的时间测算,均采用 CUDA event 方式计算。伪代码如下
cudaEventRecord(evStart);
launchKernel<<<grid, block>>>(g, b, n);
cudaEventRecord(evStop);
cudaEventSynchronize(evStop);
cudaEventElapsedTime(&evTime, evStart, evStop);
实验简介
| 实验 | 内存空间 | 核心 | 测试 |
|---|---|---|---|
| l0_copy | 全局内存 | - | 基线有效带宽 |
| l0_copy_vec | 全局内存 | - | 每线程访存宽度(float/float2/float4) |
| l1_stride | 全局内存 | 合并访存 | 跨步访问 |
| l2_offset | 全局内存 | 合并访存 | 起始地址非对齐访问 |
| l3_layout | 全局内存 | 合并访存 | AoS vs SoA |
| l4_transpose | 全局内存 + 共享内存 | bank conflict | 矩阵转置 |
| l5_bank | 共享内存 | bank conflict | bank 冲突 |
合并访存省的是字节:一个 warp 的 32 个地址尽可能挤进少数 sector,让搬运的每个字节都有用。bank conflict 省的是周期:一个 warp 的 32 个地址尽可能散在不同 bank,让 32 个访问一个周期就服务完。
基线数据:连续访存
连续访存是访问最快的方式,因此将纯拷贝 kernel 的有效带宽作为基线数据,与后续的实验做对比。
在测算有效带宽前,需要先知道理论带宽,以及他们的计算方式
- 理论带宽 = 显存时钟 * 2(DDR) * 位宽 / 8。https://docs.nvidia.com/cuda/cuda-c-best-practices-guide/index.html#theoretical-bandwidth-calculation
- 有效带宽 = (每 kernel 读的字节数 + 每 kernel 写的字节数) / 10^9 / 时间(秒)。 https://docs.nvidia.com/cuda/cuda-c-best-practices-guide/index.html#effective-bandwidth-calculation
核心代码就是拷贝赋值,如下所示,完整代码参见:https://github.com/boxtsecond/ai-infra-learn/blob/main/cuda/memory-lab-code/src/l0_copy.cu
__global__ void copyKernel(const float* a, float* b, size_t n) {
    size_t i = (size_t)blockIdx.x * blockDim.x + threadIdx.x;
    if (i < n) b[i] = a[i];
}
固定实验所使用参数,与后续实验需保持一致
| 配置 | 数值 |
|---|---|
| GPU | 当前机器的 GPU 0 |
| 每 block 线程数 | 256 |
| 数据类型 | float,4 bytes |
| 数据量 | 1 GB |
| 计时方式 | CUDA events |
| 预热次数(不计入统计) | 3 次 |
| 统计次数 | 10 次 |
执行结果如下
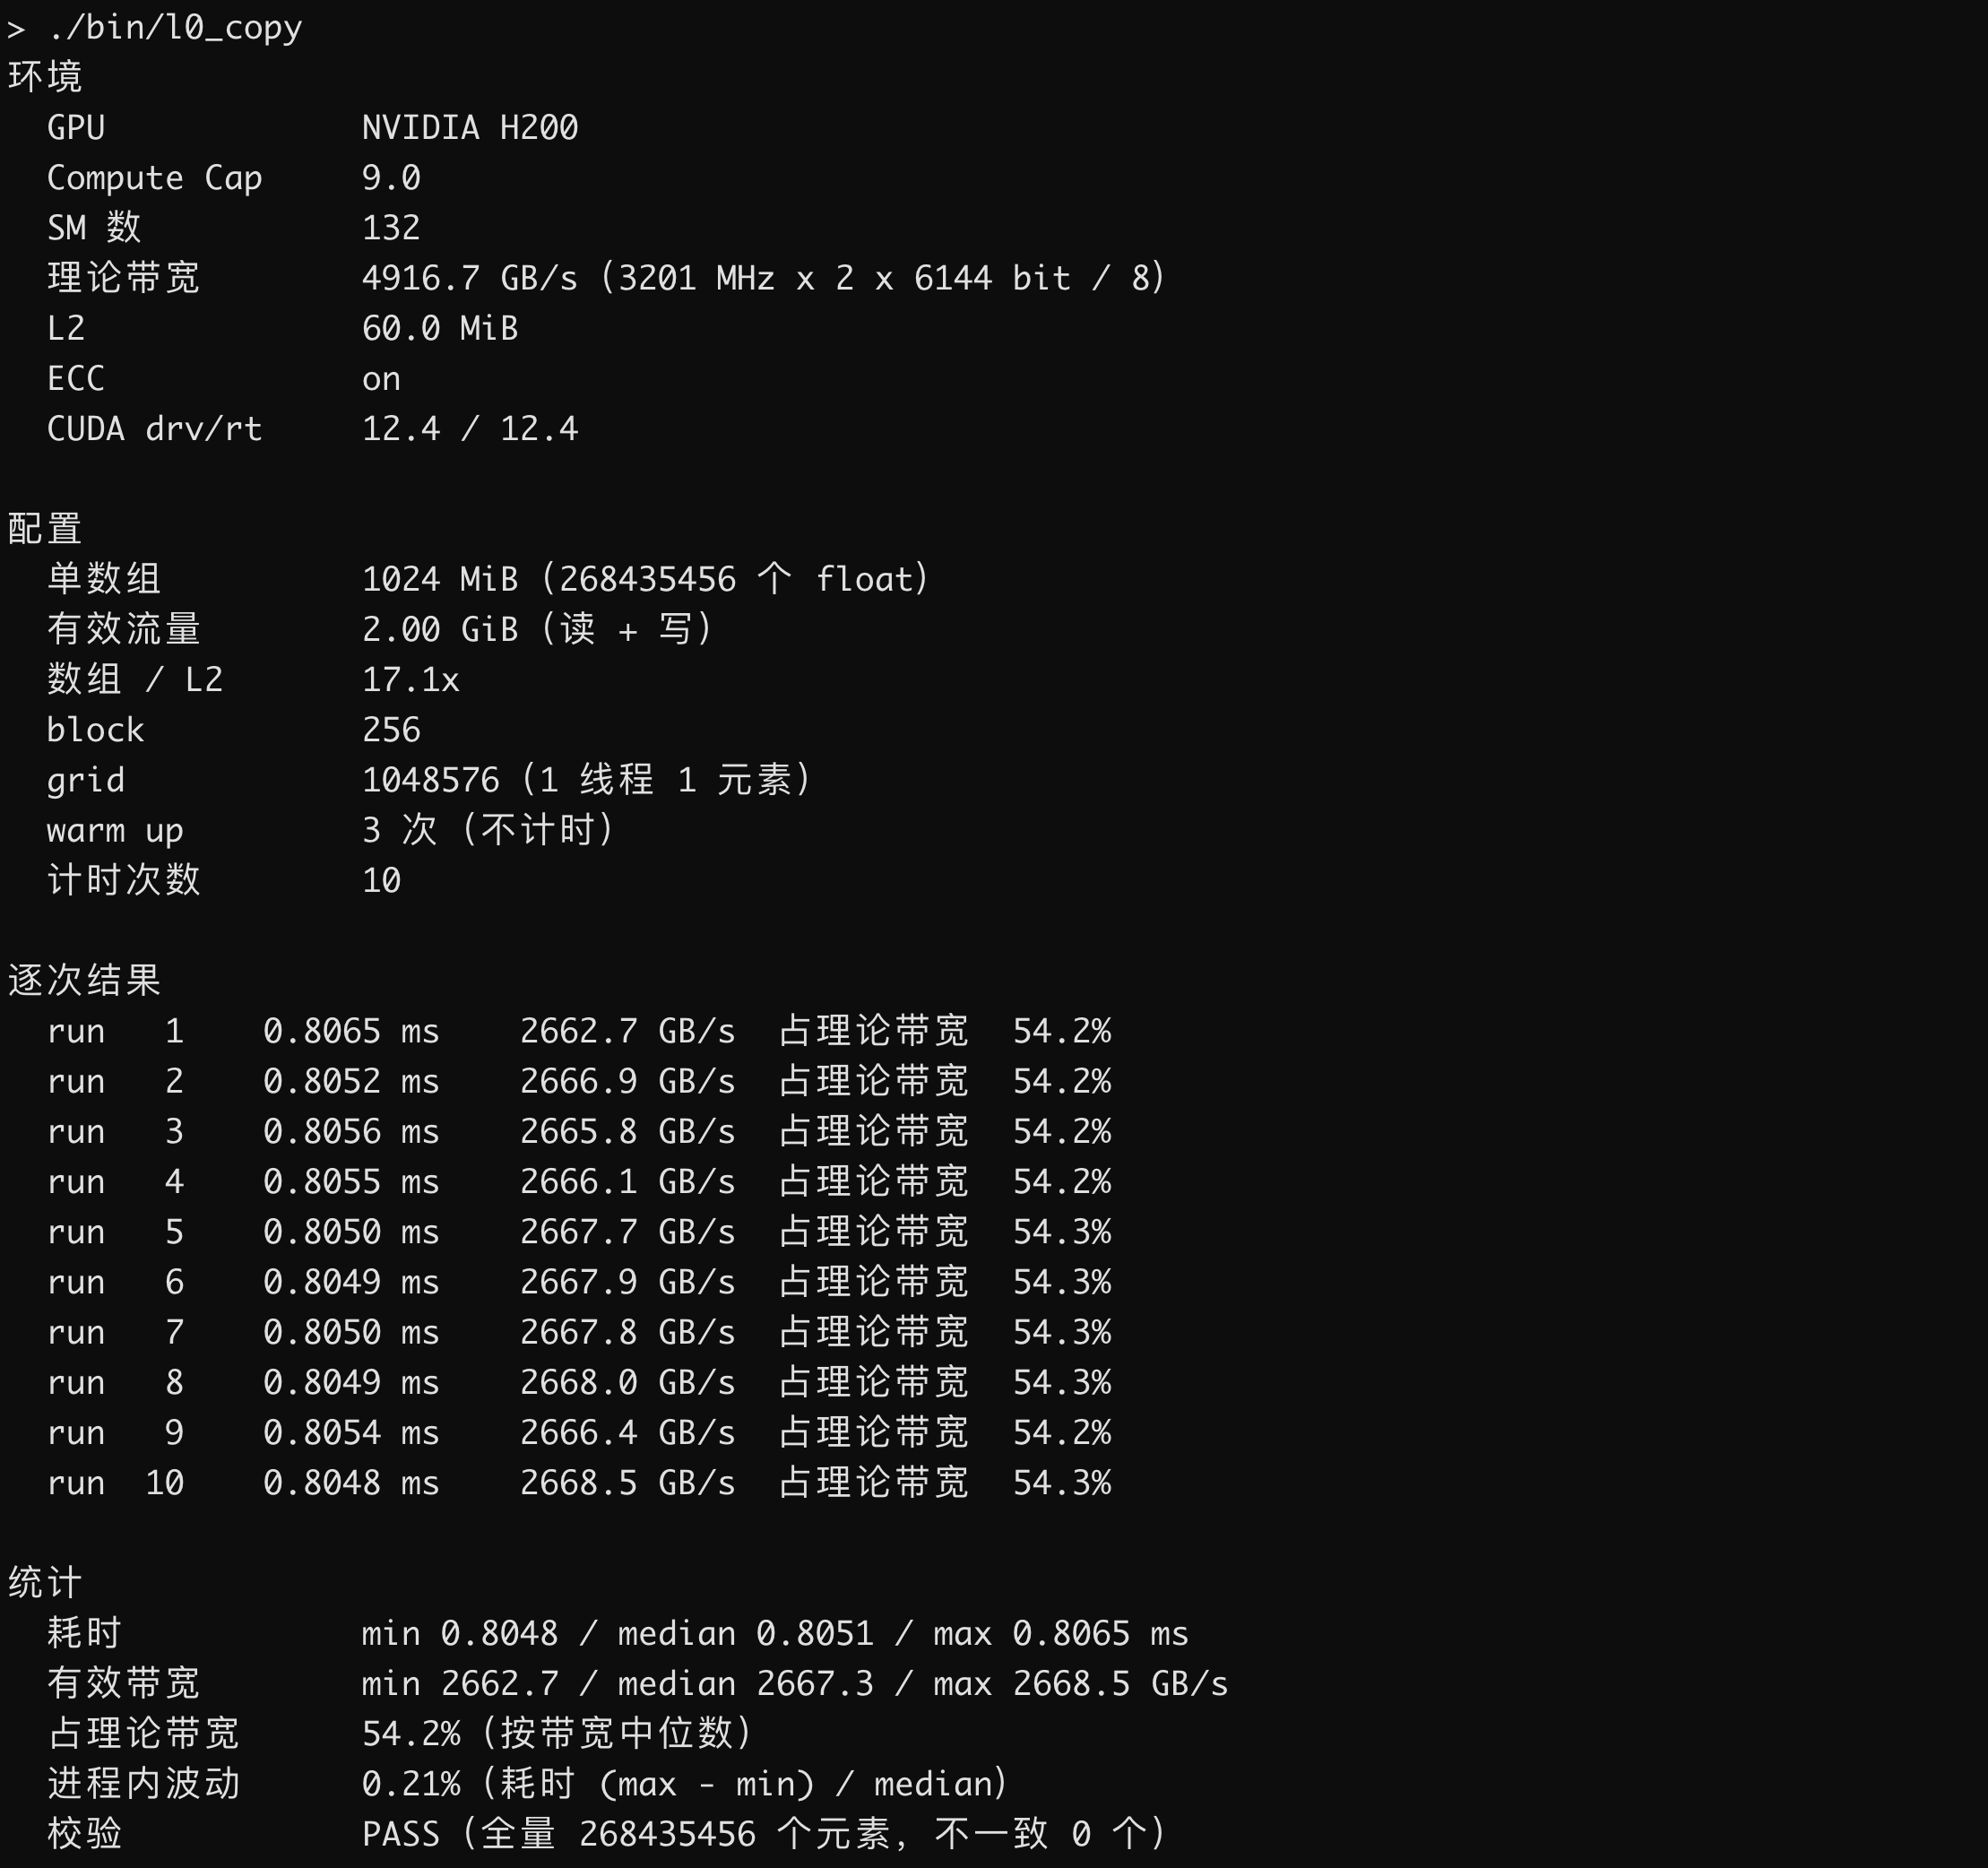
从实验执行和结果来看,有两点需要详细说明
- 数组 / L2 为什么需要 17.1 倍
- 理论带宽 4916.7 GB/s,为什么实测只能达到约 2667 GB/s,有效带宽仅为理论带宽的 54%
数组 / L2 为什么需要 17.1 倍
每次 kernel 虽然只读每个元素一次,但连续运行的多个 kernel,会反复读取同一批地址。 前一次访问留下的缓存数据,可能被后一次直接使用。
如果对应数据已经在 L2 中,数据直接由 L2 提供;如果未命中 L2,才需要继续向设备显存请求。假设把数组缩小到每个 16 MiB,输入和输出合计 32 MiB,小于这张卡的 60 MiB L2,那么可能发生以下情况
| 执行阶段 | 可能发生的情况 |
|---|---|
| 初始化、预热 | 数据进入缓存 |
| 后续计时拷贝 | 输入数据仍在 L2,大量读取可以命中缓存 |
| 连续重复运行 | 持续复用相同地址,缓存带来的收益可能一直存在 |
这为什么影响带宽解释?从有效带宽的计算公式看
有效带宽 =(逻辑读取字节数 + 逻辑写入字节数)/ 时间
无论读取由 HBM 还是 L2 提供,分子都照样计入。缓存命中可能缩短时间,而分子保持不变,因此有效带宽会提高。
写入也类似,缓存采用写回(write-back)机制时,执行一次全局内存写入,并不意味着对应数据当时就已经写到 HBM。所以“逻辑读写了多少字节”和“实际经过 HBM 多少字节”需要分别看。
因此,实验使用每数组 1 GB,两个数组合计 2 GB,明显超过 60 MiB L2。对当前全量扫描的拷贝而言,处理后续数据会不断替换此前的缓存行,下一轮再次读取数组时,大量数据需要重新从 HBM 获取。这样可以减少整个数据集留在缓存中、被后续样本反复利用的机会。
为什么有效带宽只有理论带宽的 54%
要回答这个问题,需要采集 GPU 运行 copyKernel 的实际指标并分析。
CUDA_VISIBLE_DEVICES=0 ncu --clock-control none --set full --import-source yes \
    -k copyKernel --launch-skip 3 -c 1 -f \
    -o ~/memory-lab-reports/L0_copy_full \
    ./bin/l0_copy 512 1
ncu 运行后,得到采集文件 L0_copy_full.ncu-rep,使用 Nsight Compute 打开分析。可以看到两个明显与预期不符的指标。
-
DRAM Throughput 占用 53.69%,显存占用只有一半。纯拷贝 kernel 只做访存,正常应该能够把显存跑满。
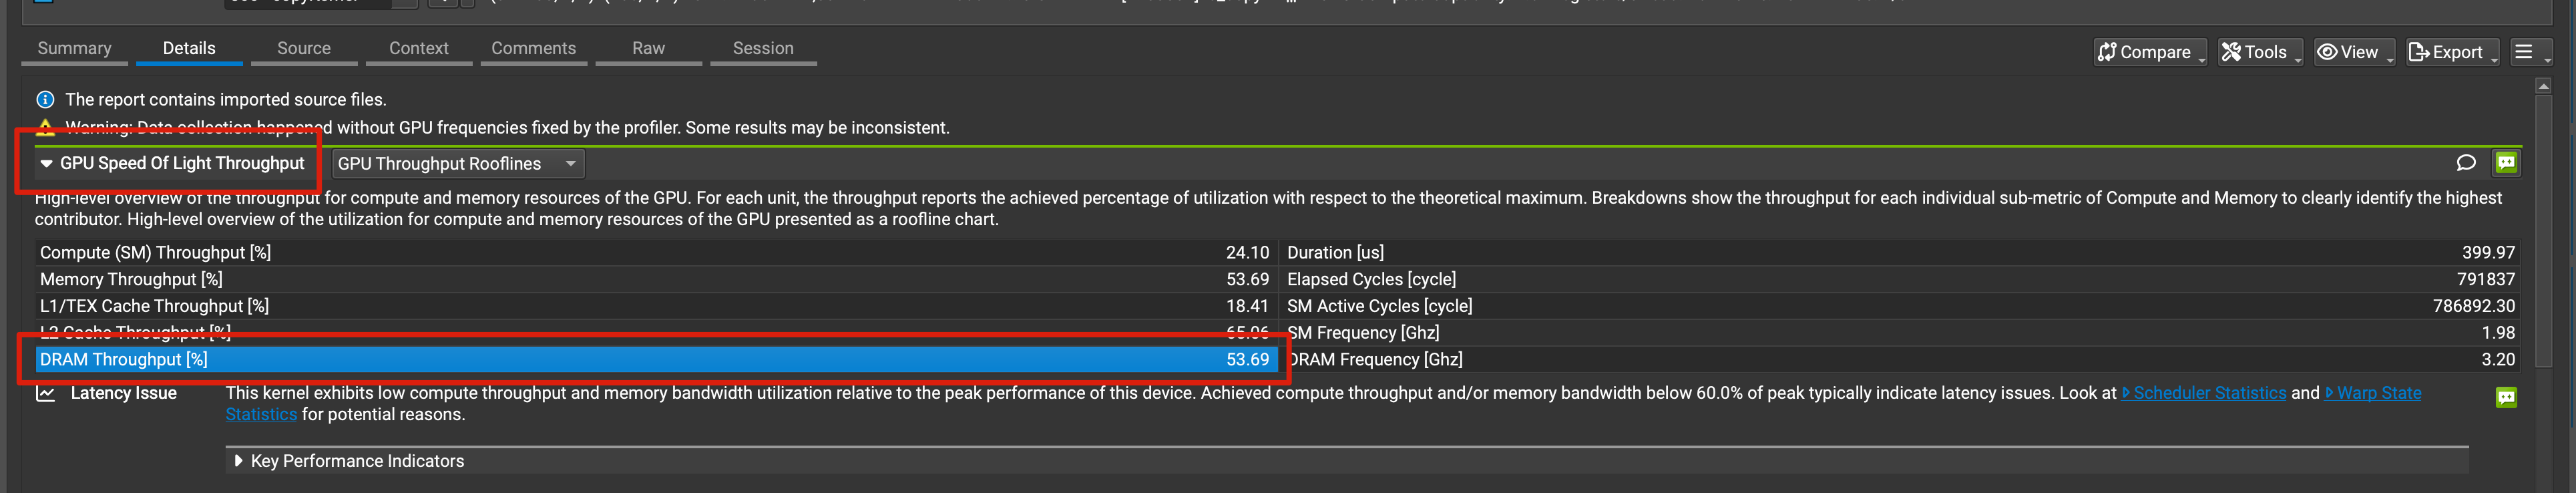
copyKernel 的 DRAM Throughput -
Stall Long Scoreboard 42.63 周期,Warp Cycles Per Issued Instruction 50.41 周期,等待从显存数据读取占比 84.6%
- Warp Cycles Per Issued Instruction,表示同一个 warp 连续两次发射指令之间,平均隔多少个周期
- Stall Long Scoreboard,warp 的下一条指令要用某个 L1TEX 访存操作(global、local、surface、texture)的结果,而结果还没返回,warp 处于等待状态。它表示平均每发射一条指令,warp 有多少个周期处在这种状态。
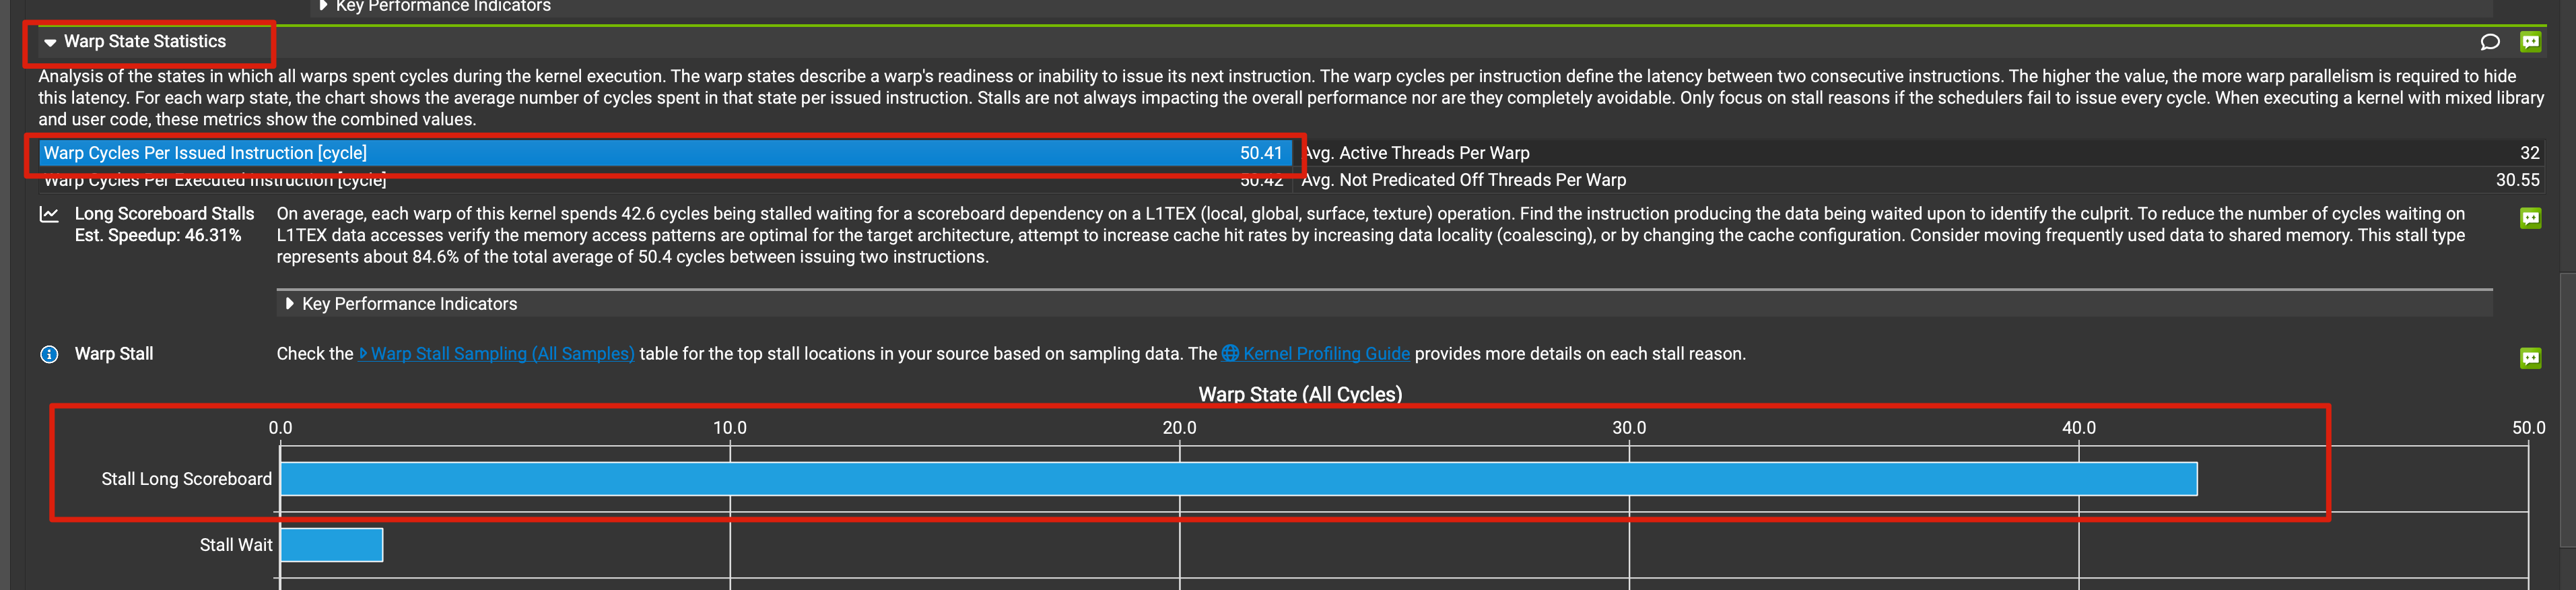
copyKernel 的 Stall Long Scoreboard
以上两个指标,再加上 L1/TEX、L2、SM 都没有饱和(18.41%、65.06%、24.10%),说明在同一时刻已经发出、数据还没返回的读请求字节(bytes in flight)太少,显存约有一半时间没有请求可处理,所以带宽只有 54%。
想要提高实际的有效带宽,核心在于发送给显存的读写请求字节数变高,可以通过提高 warp 数量或者增大每个 warp 读取的字节数。而 warp 数量收到硬件的约束,每个 SM 最多 64 个。
下面用实验验证每个 warp 读取的字节数,对带宽的影响。参考:https://developer.nvidia.com/blog/cuda-pro-tip-increase-performance-with-vectorized-memory-access/
每线程访存宽度对带宽的影响
拷贝同样多的数据,只改变每个线程一次读写的字节数,对应数据类型为 float、float2、float4,每个 warp 一次读的量分别为 128 B、256 B、512 B。完整代码参见:https://github.com/boxtsecond/ai-infra-learn/blob/main/cuda/memory-lab-code/src/l0_copy_vec.cu
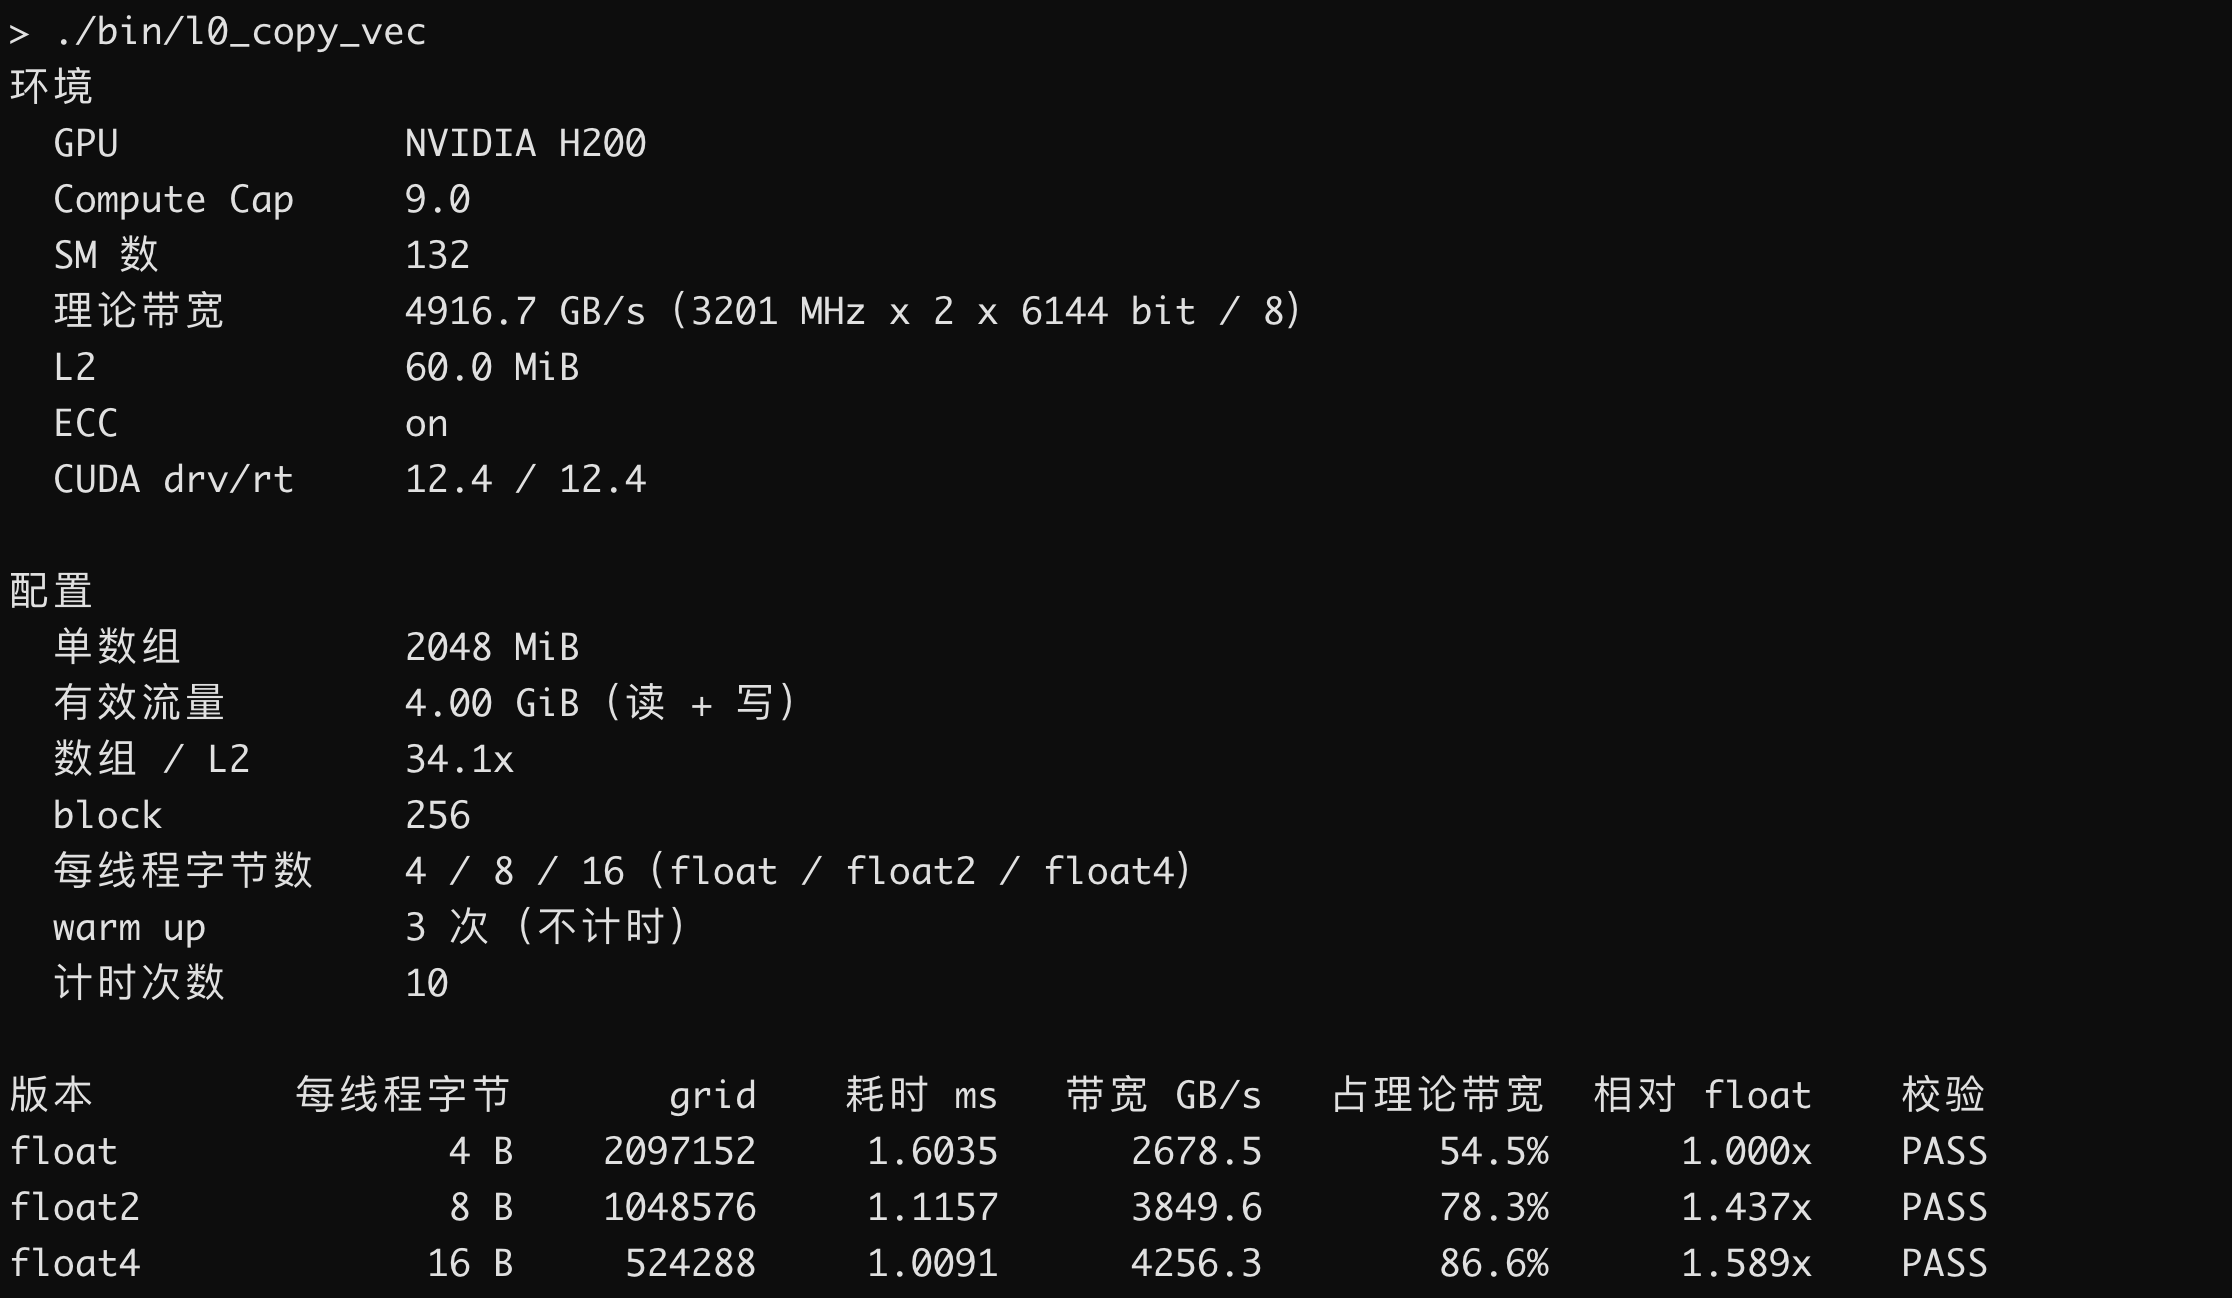
实验测量结果和预测一致,float、float2、float4 的有效带宽分别为理论带宽的 54.5%、78.3%、86.6%。在当前场景下,验证了有效带宽随着每线程访存宽度的增大而增大。
跨步访问:相邻线程的地址间距对带宽的影响
跨步访问会降低有效带宽,分别测试 stride 1、2、3、4、8、16、32,验证并回答以下两个问题。
- sector、cache line 在当前环境的字节数为 32 字节、128 字节,此数值参考 https://docs.nvidia.com/nsight-compute/ProfilingGuide/index.html#quantities
- sector:访存路径上搬运的最小单位,32 字节。一个 warp 的一条访存指令,L1TEX 先算出 32 条 lane 的地址覆盖了哪些 sector,再按 sector 整块搬运。不管一条 lane 要的是 1 字节还是 16 字节,包含它的那 32 字节都得整块搬过来。
- cache line:缓存登记和查找的单位,L1/L2 cache line = 4 * sector
- stride ≤ 8 时,有效带宽约等于 1/stride
- 实验使用的数据类型是 float 4 字节,sector 是 32 字节,因此当 stride > 8 时,再加大 stride,sector 数无处可增。
完整代码参见:https://github.com/boxtsecond/ai-infra-learn/blob/main/cuda/memory-lab-code/src/l1_stride.cu
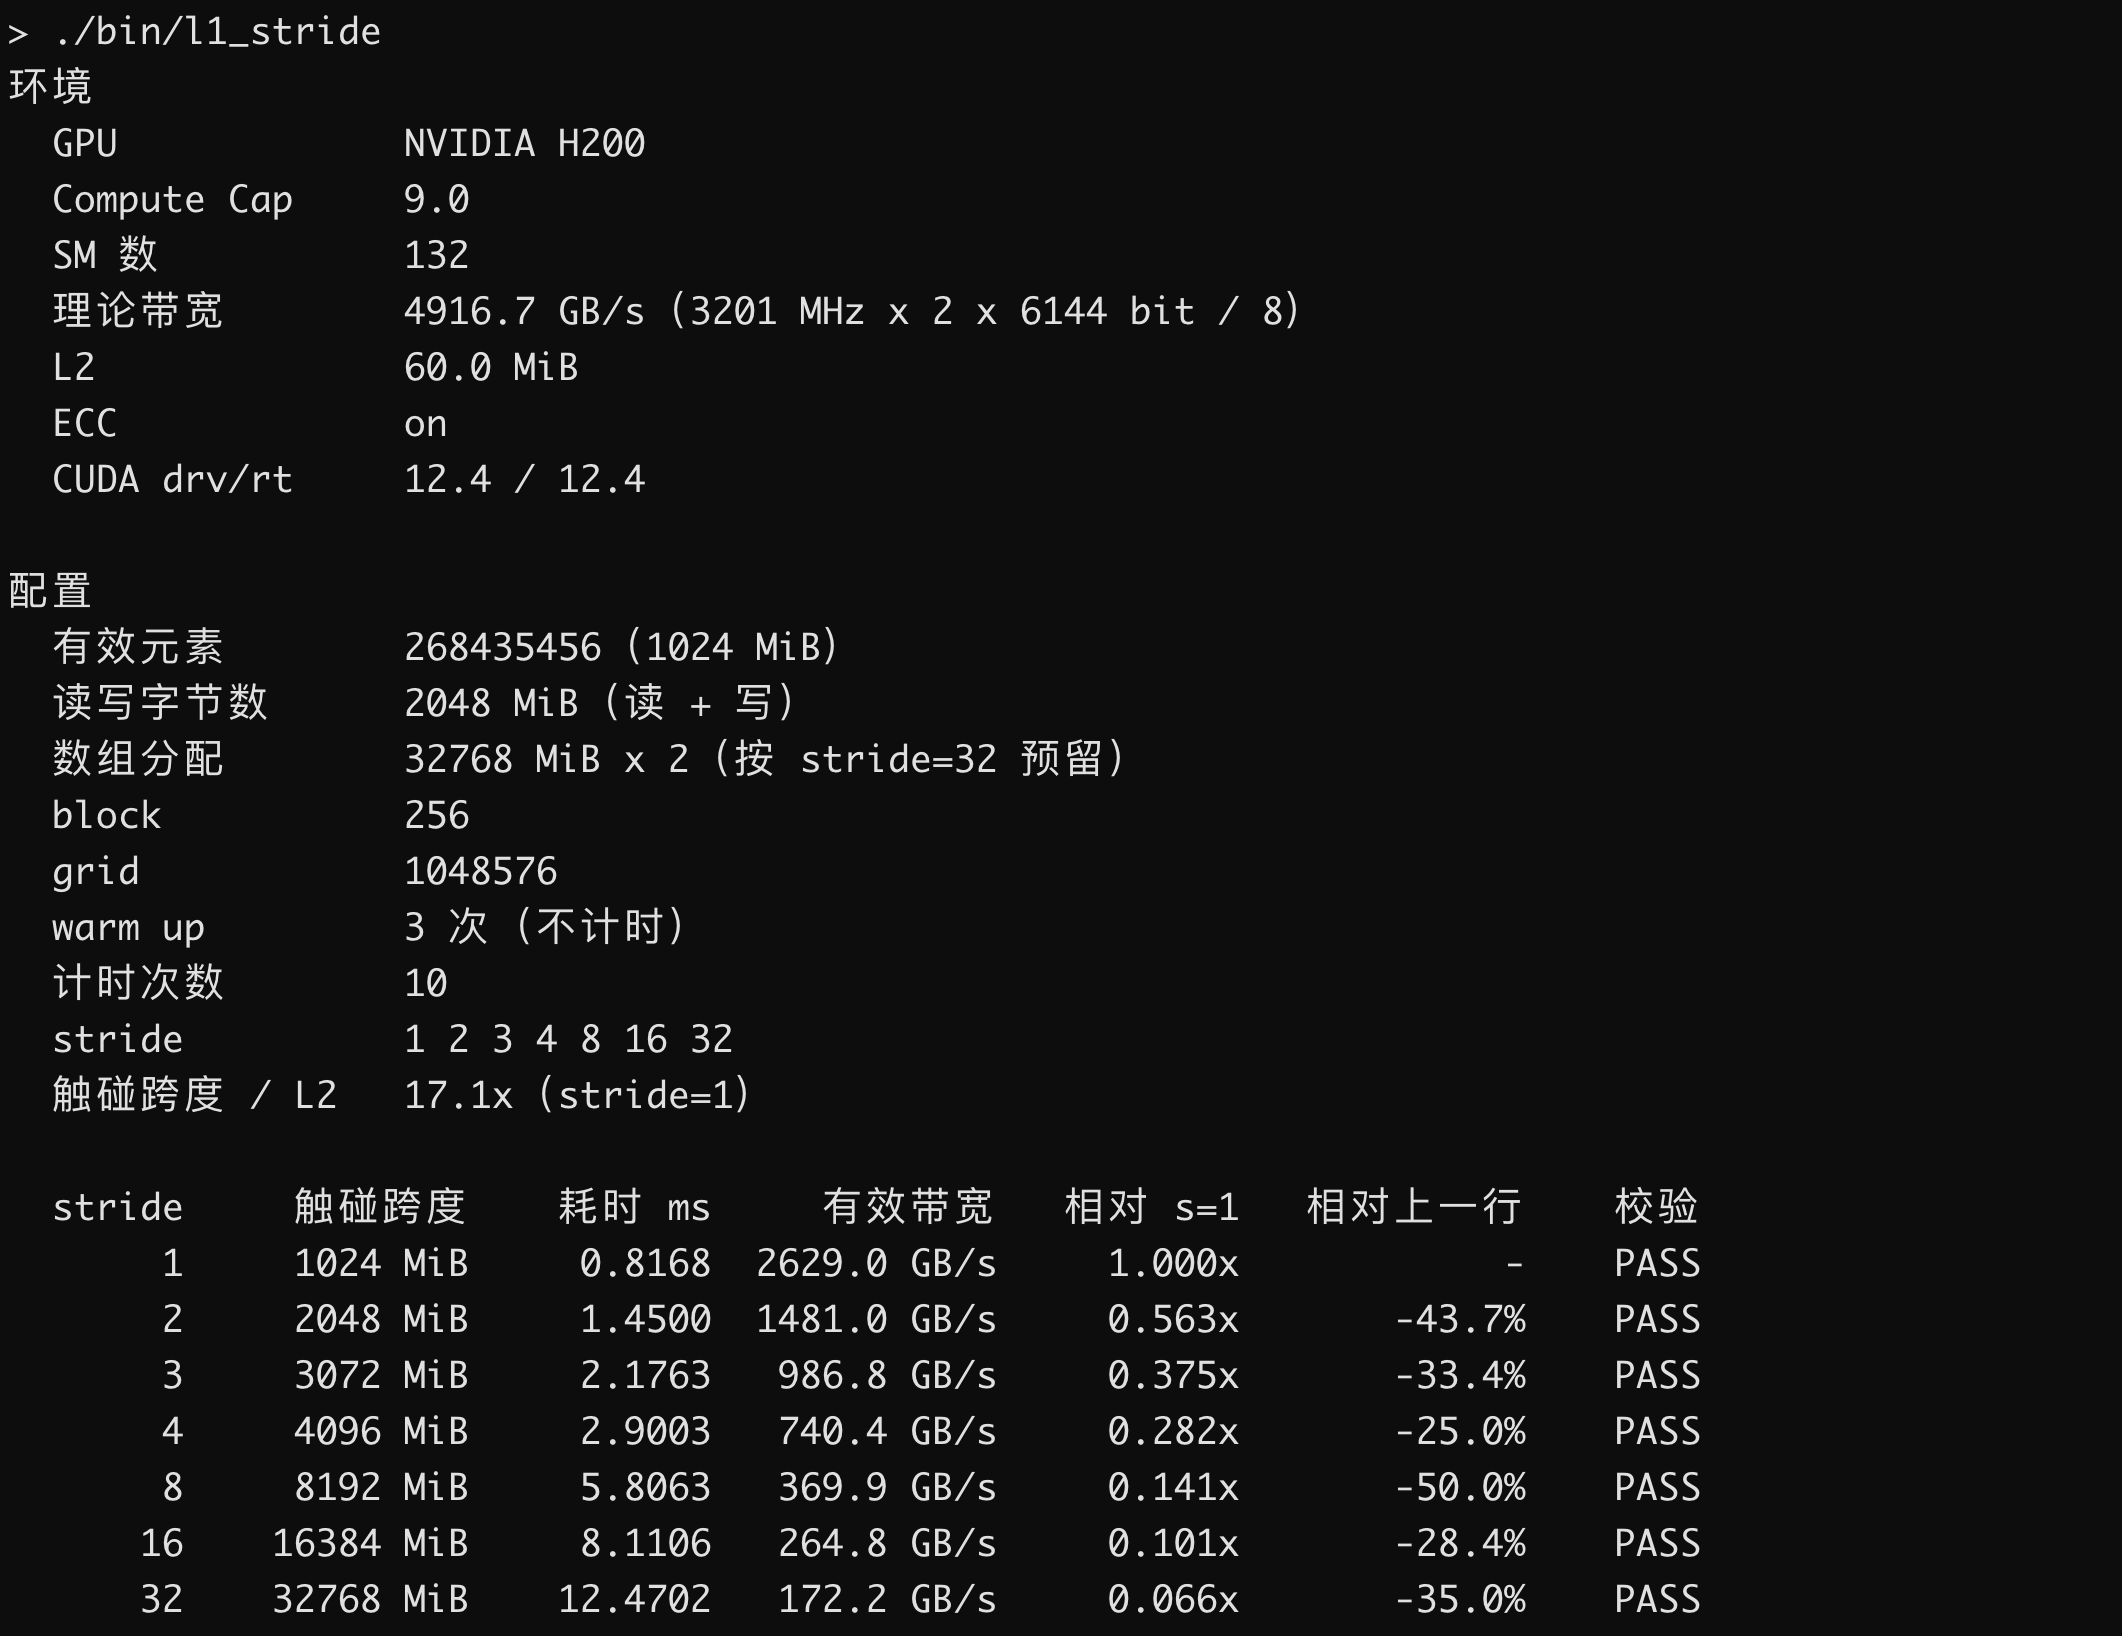
L1/TEX Cache 指标分析
-
stride = 1
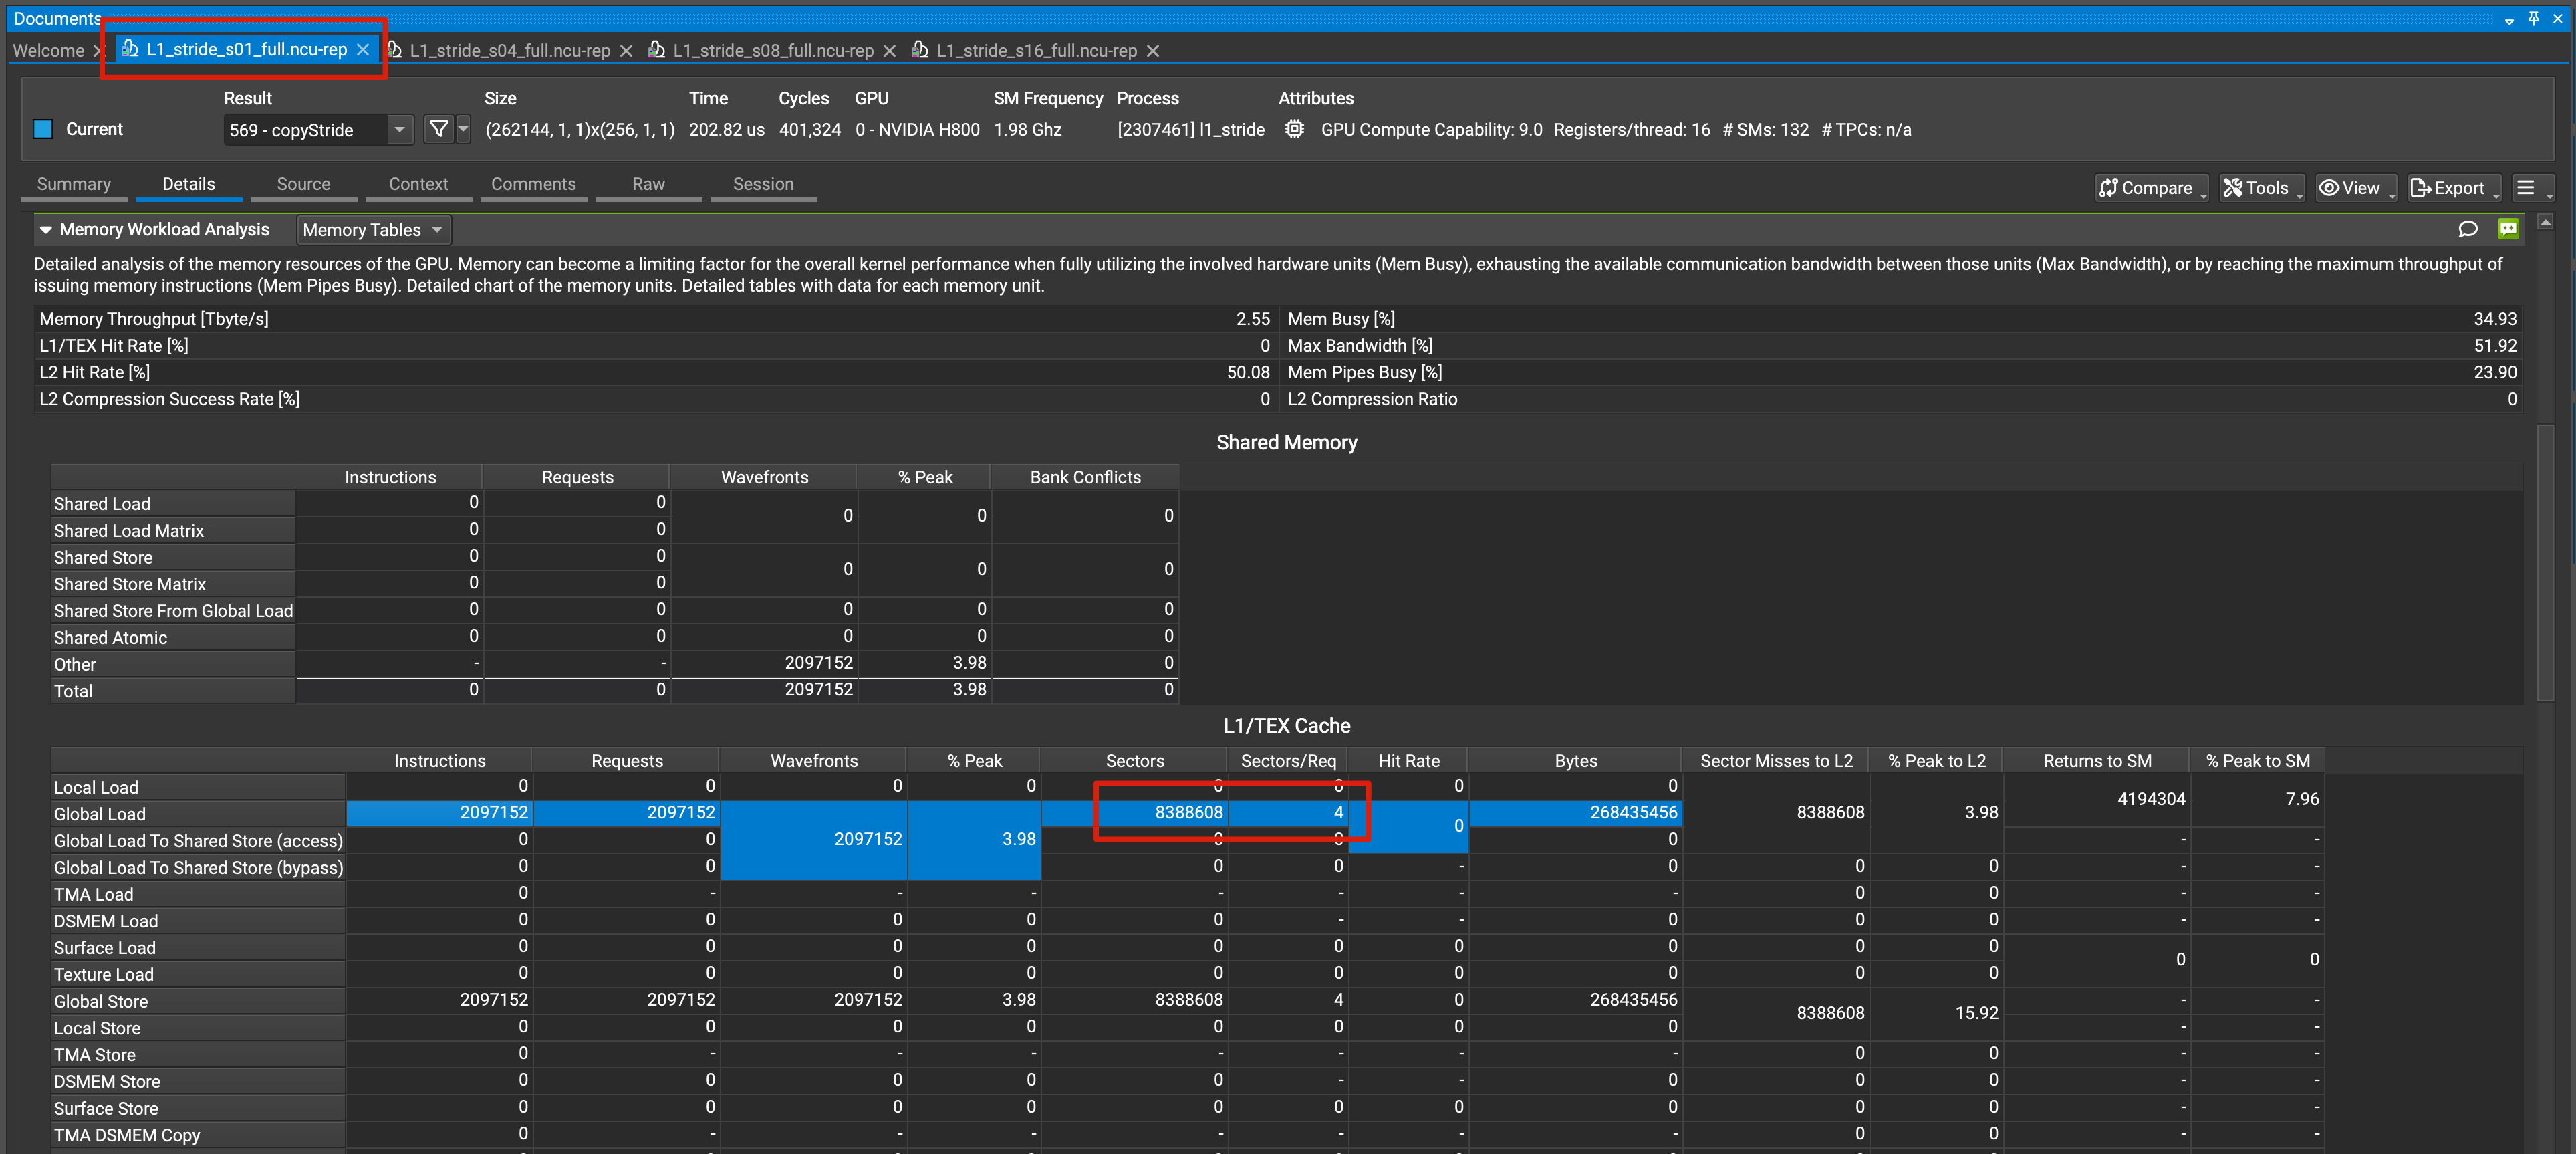
stride = 1 的 L1/TEX Cache 指标 -
stride = 4
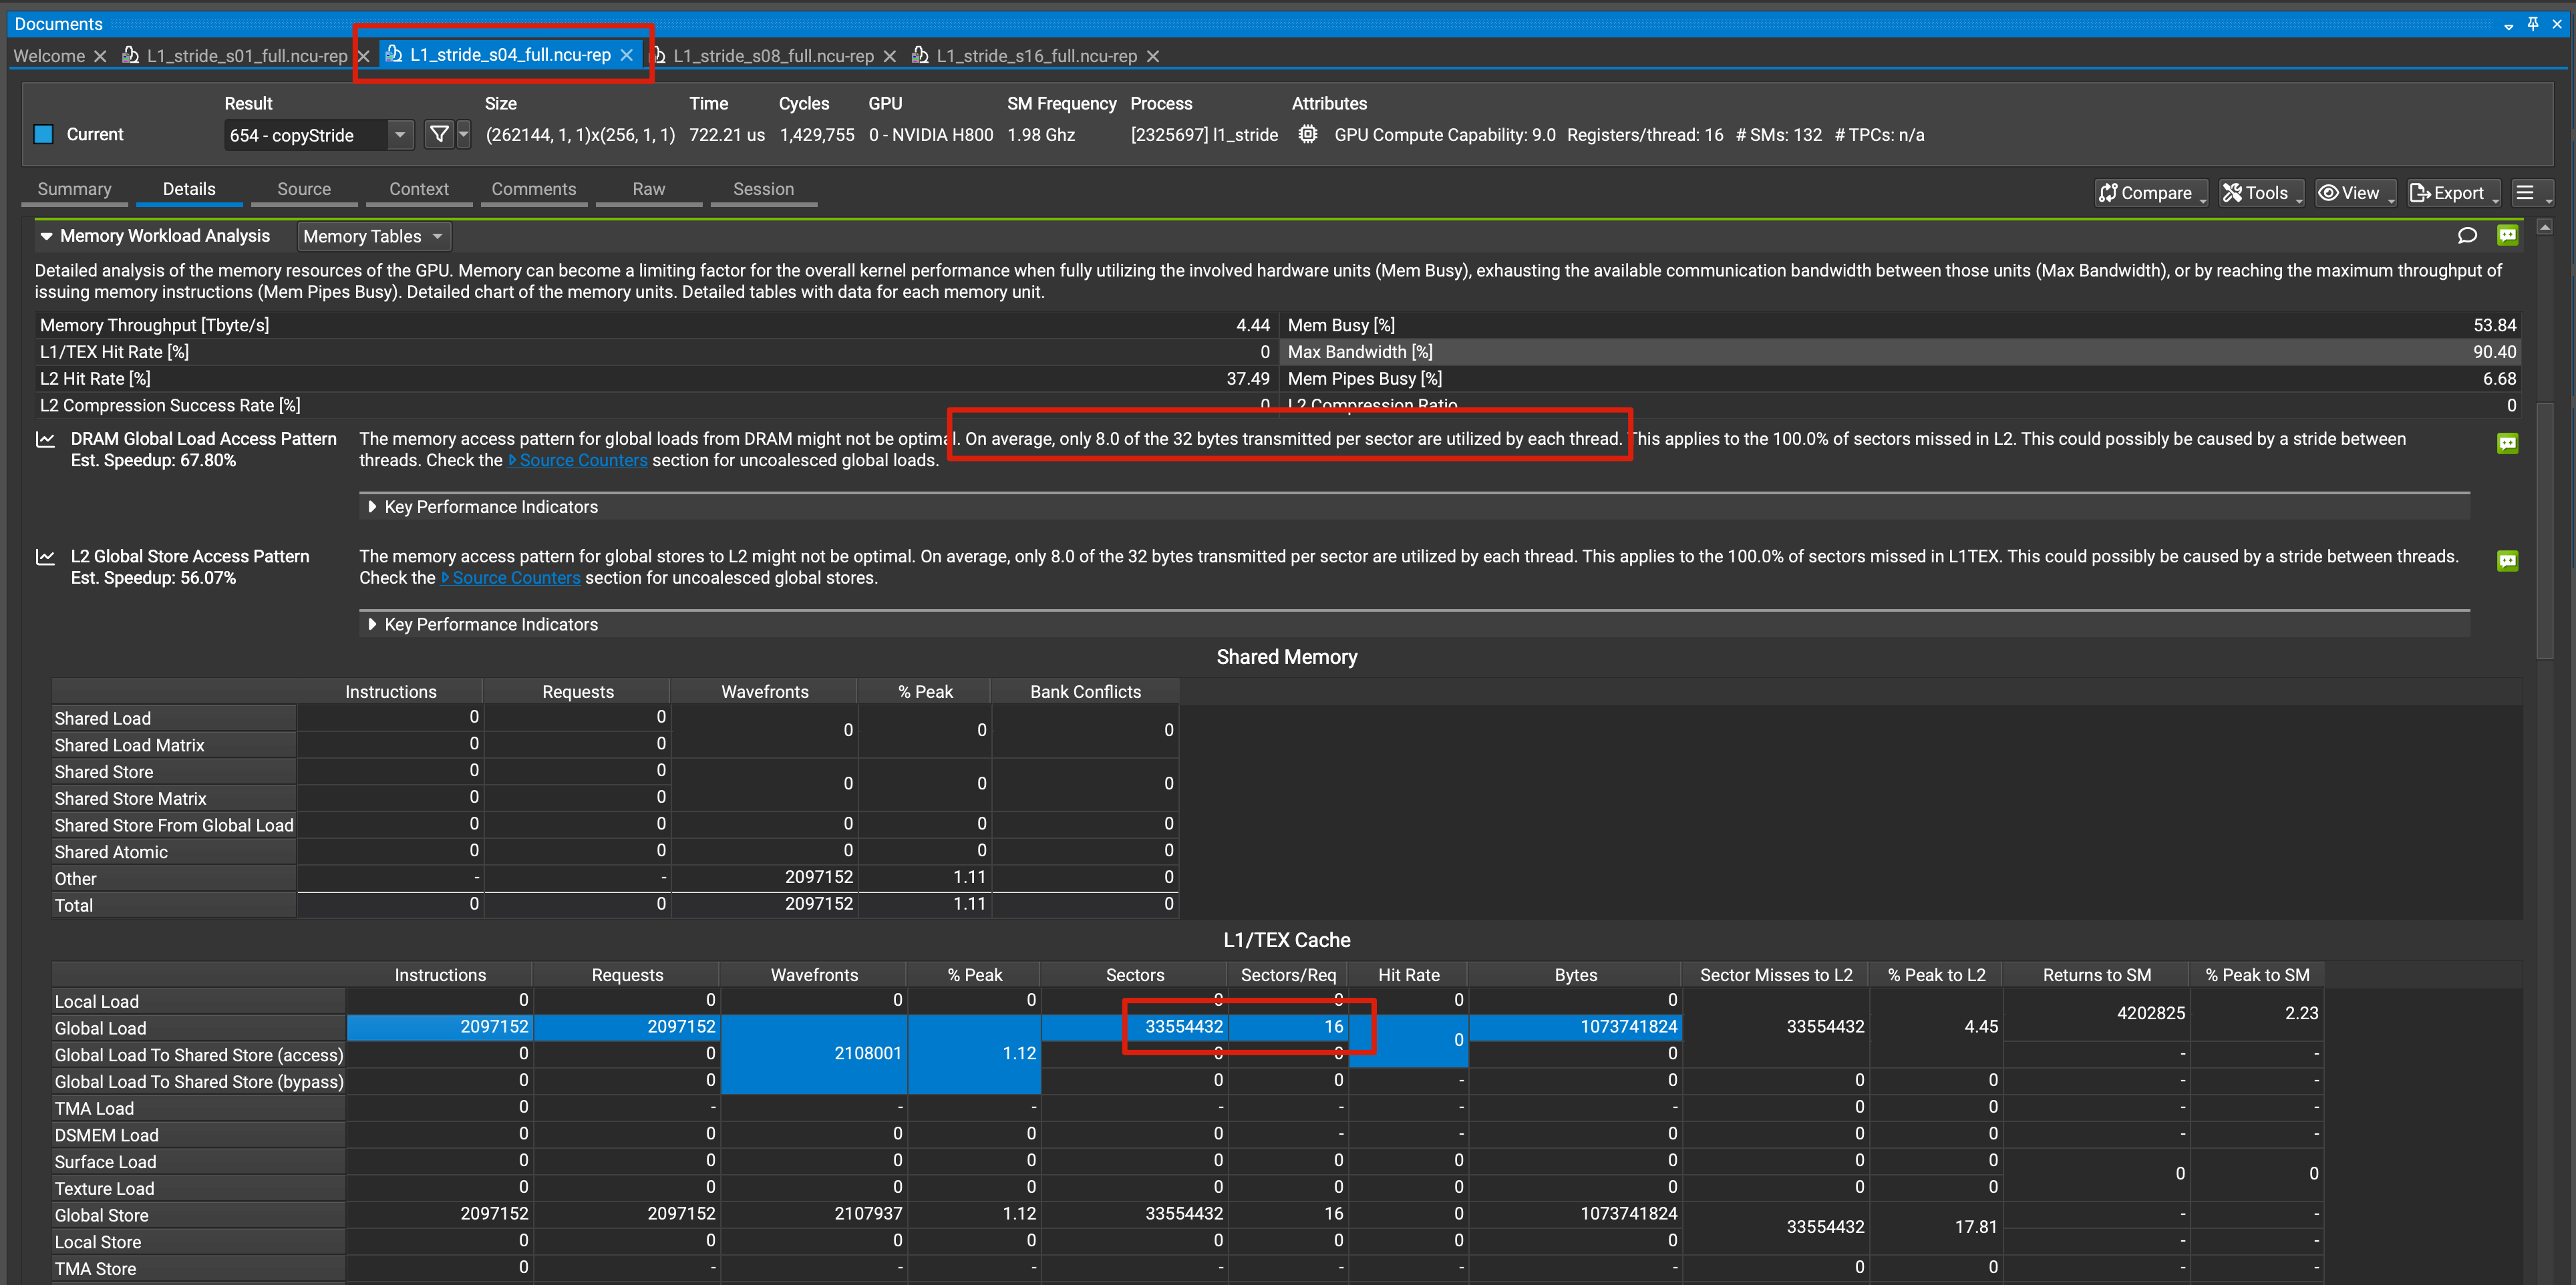
stride = 4 的 L1/TEX Cache 指标 -
stride = 8
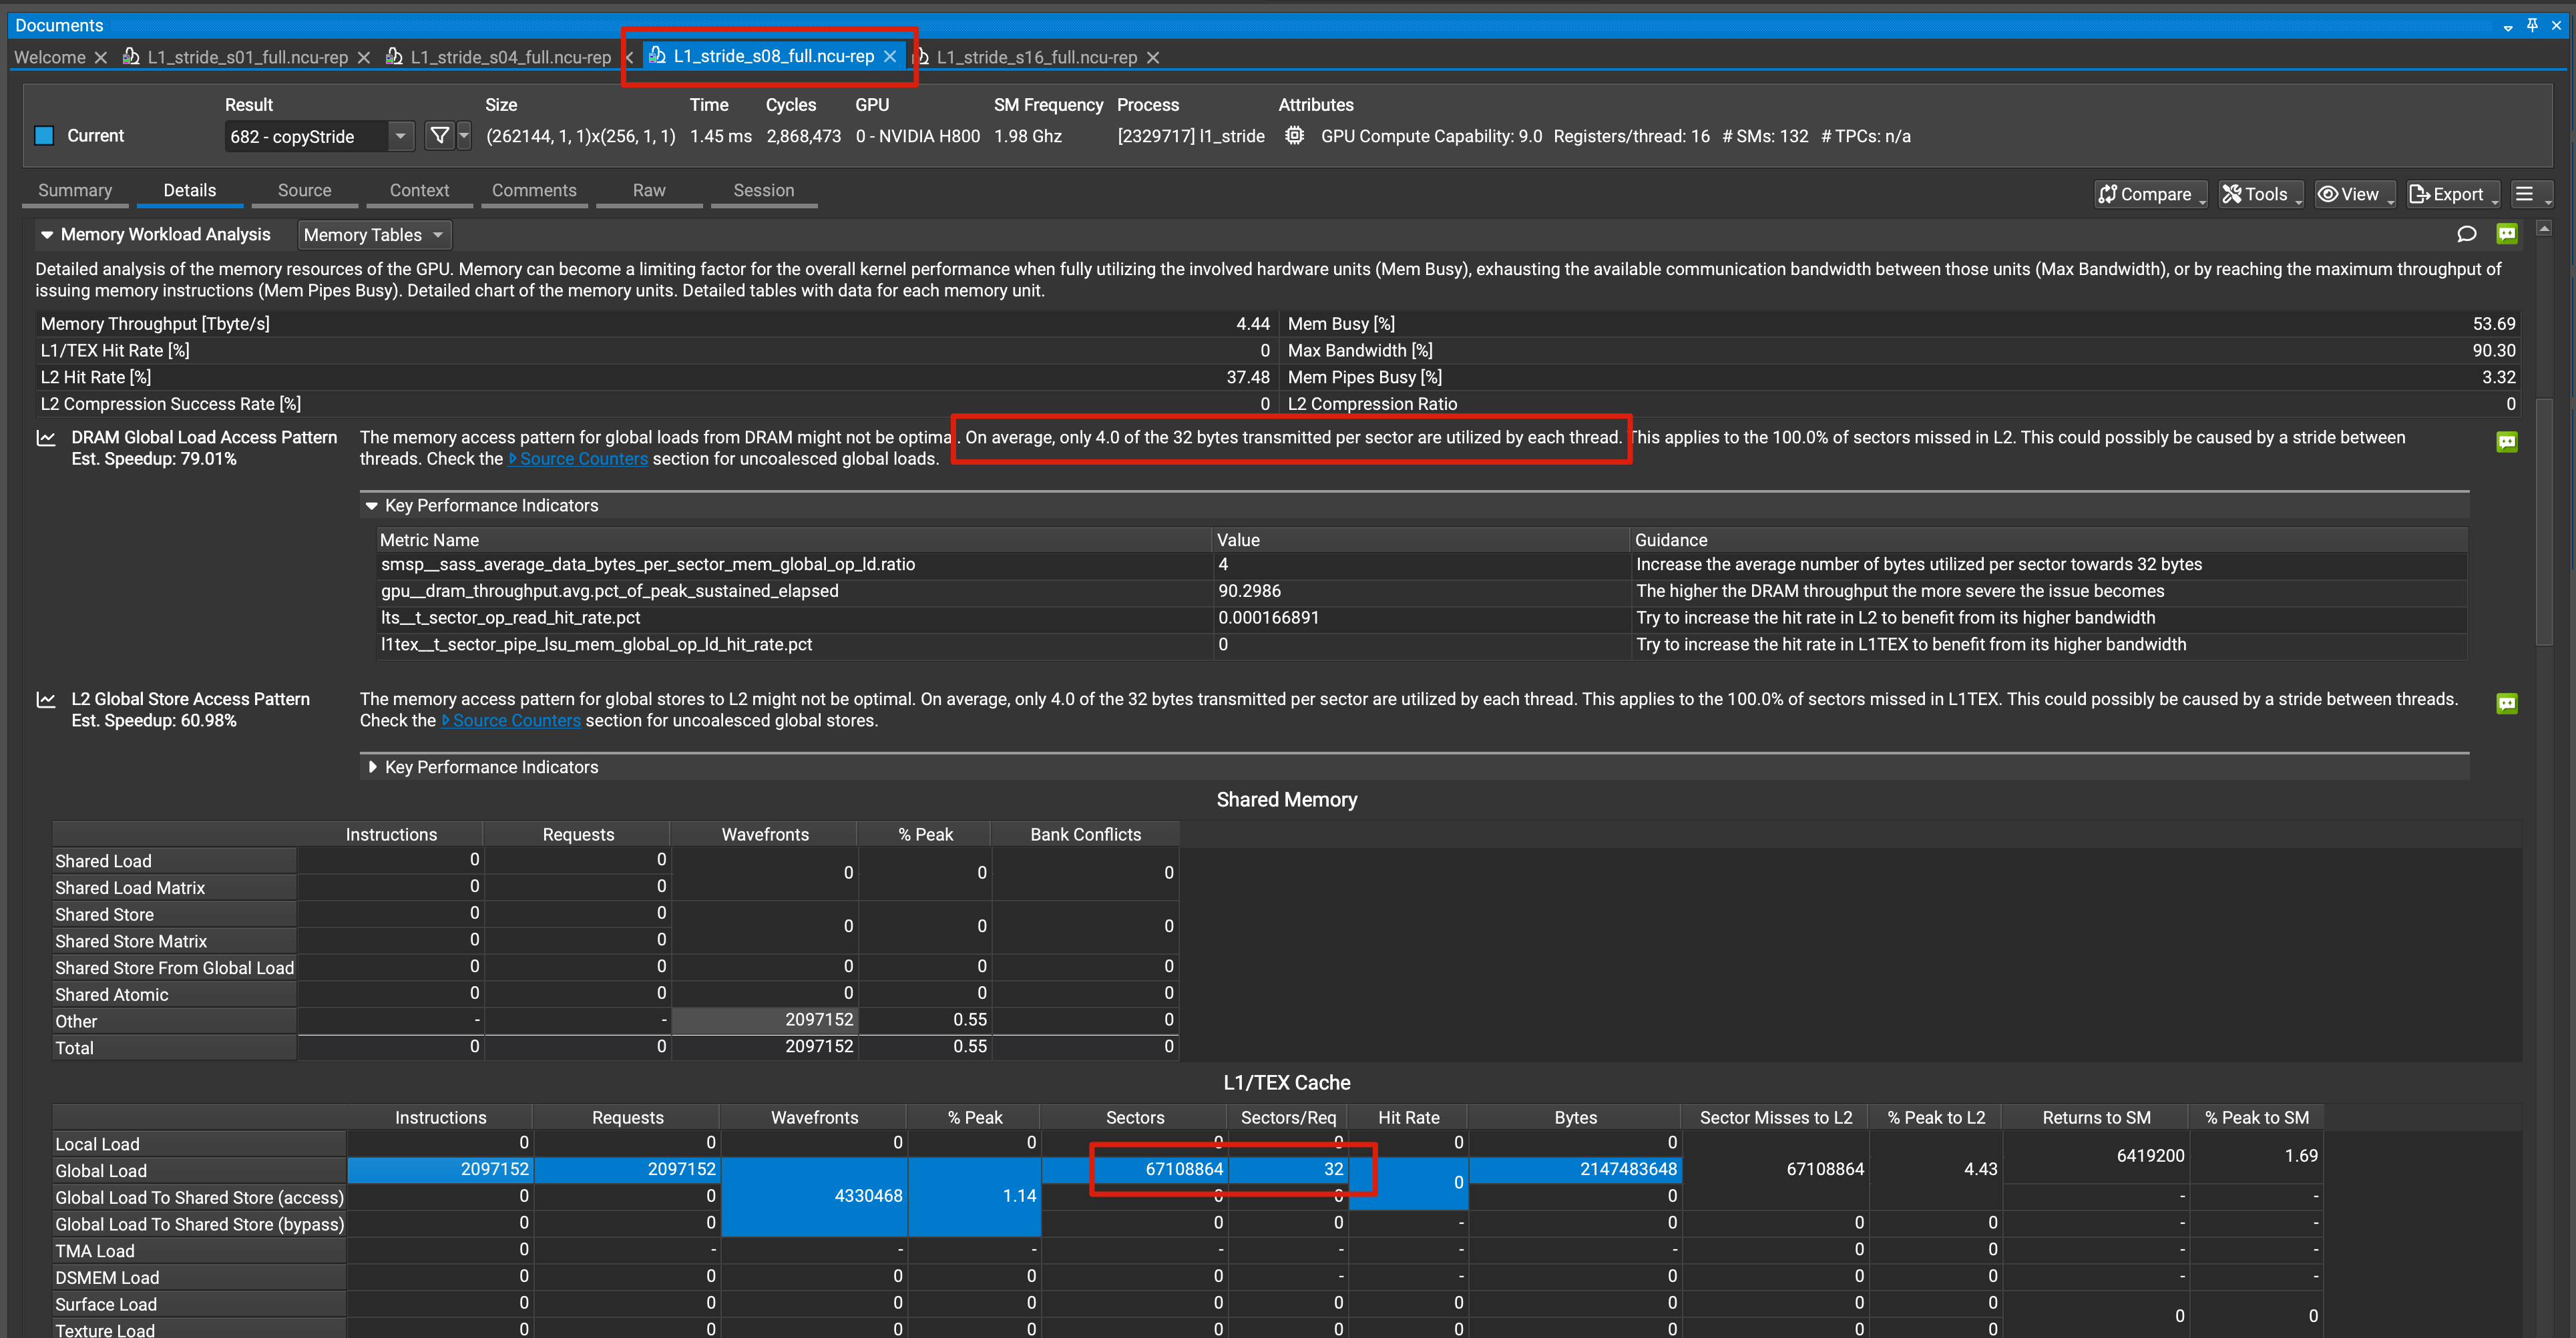
stride = 8 的 L1/TEX Cache 指标 -
stride = 16
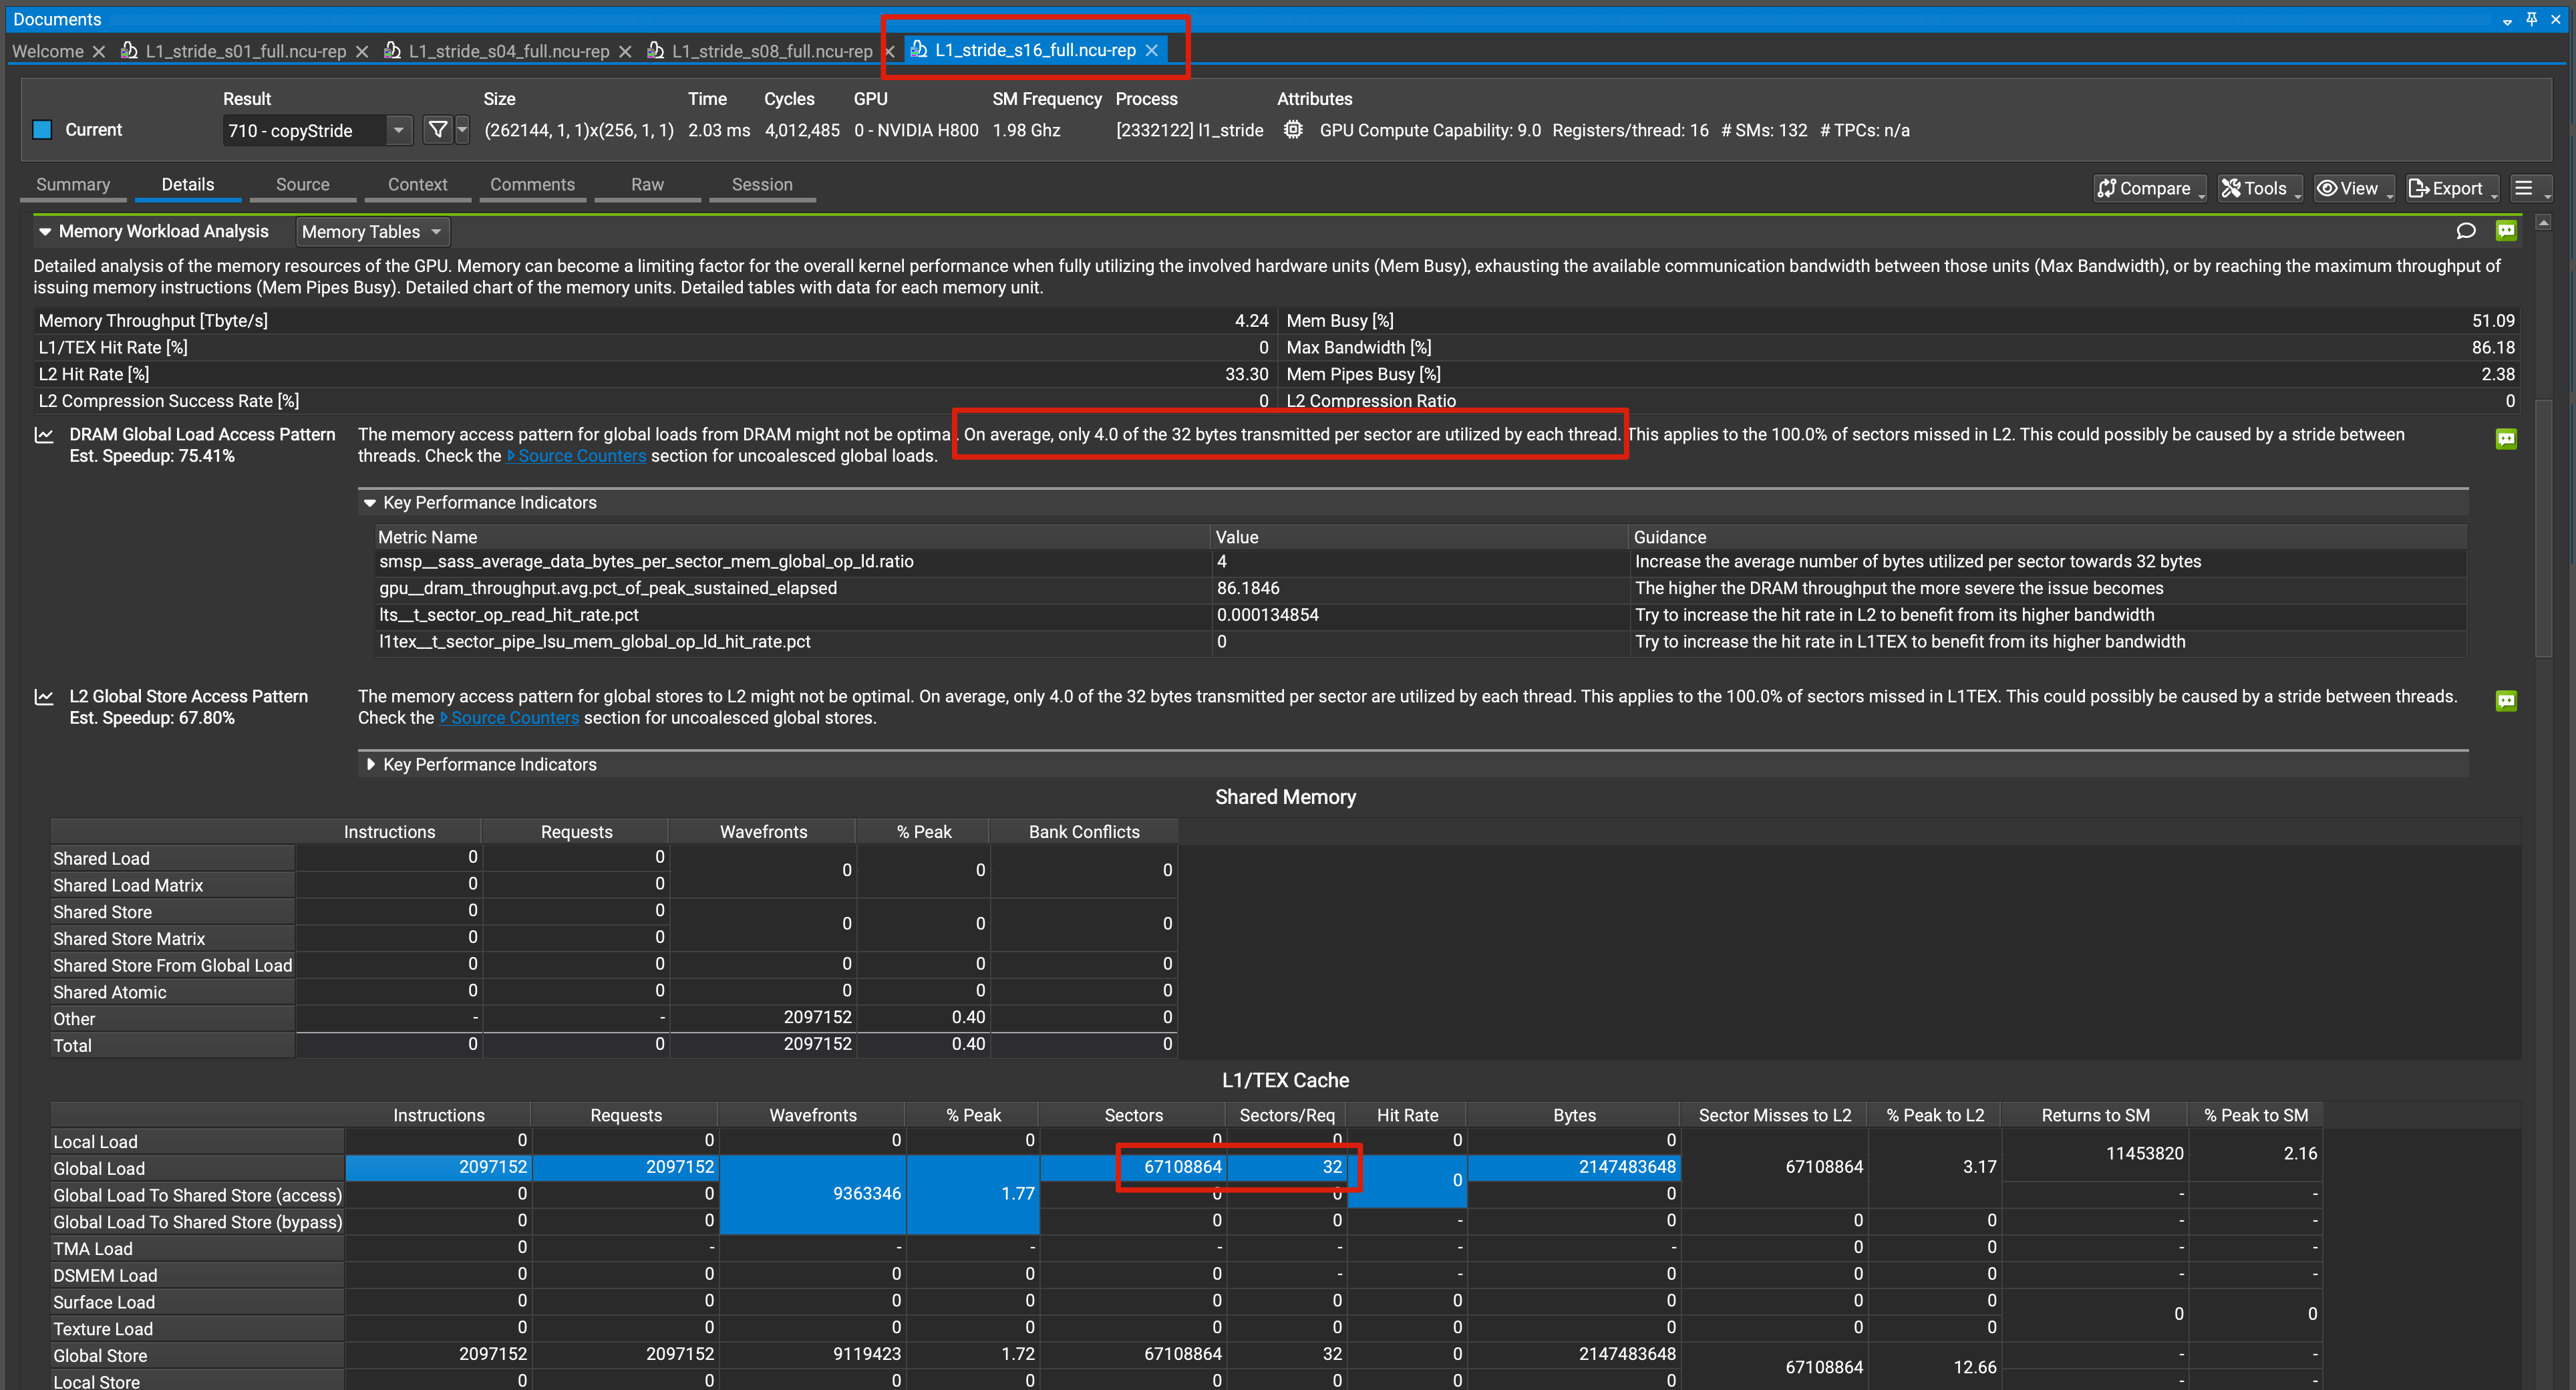
stride = 16 的 L1/TEX Cache 指标
从当前实验的数据,可以得到以下结论
-
stride = 1 时,Sectors/Req 指标 = 4,说明一个 warp 的 32 线程在连续访存时,每个线程读取 4B(float) 数据,一次读取 4B * 32 = 128B 数据,占用的 sector 为4,因此每个 sector 的大小为 32B,cache line = 4 * 32B = 128B
-
stride = 1、2、3、4、8、16 时,Sectors/Req 指标 = 4、8、12、16、32、32
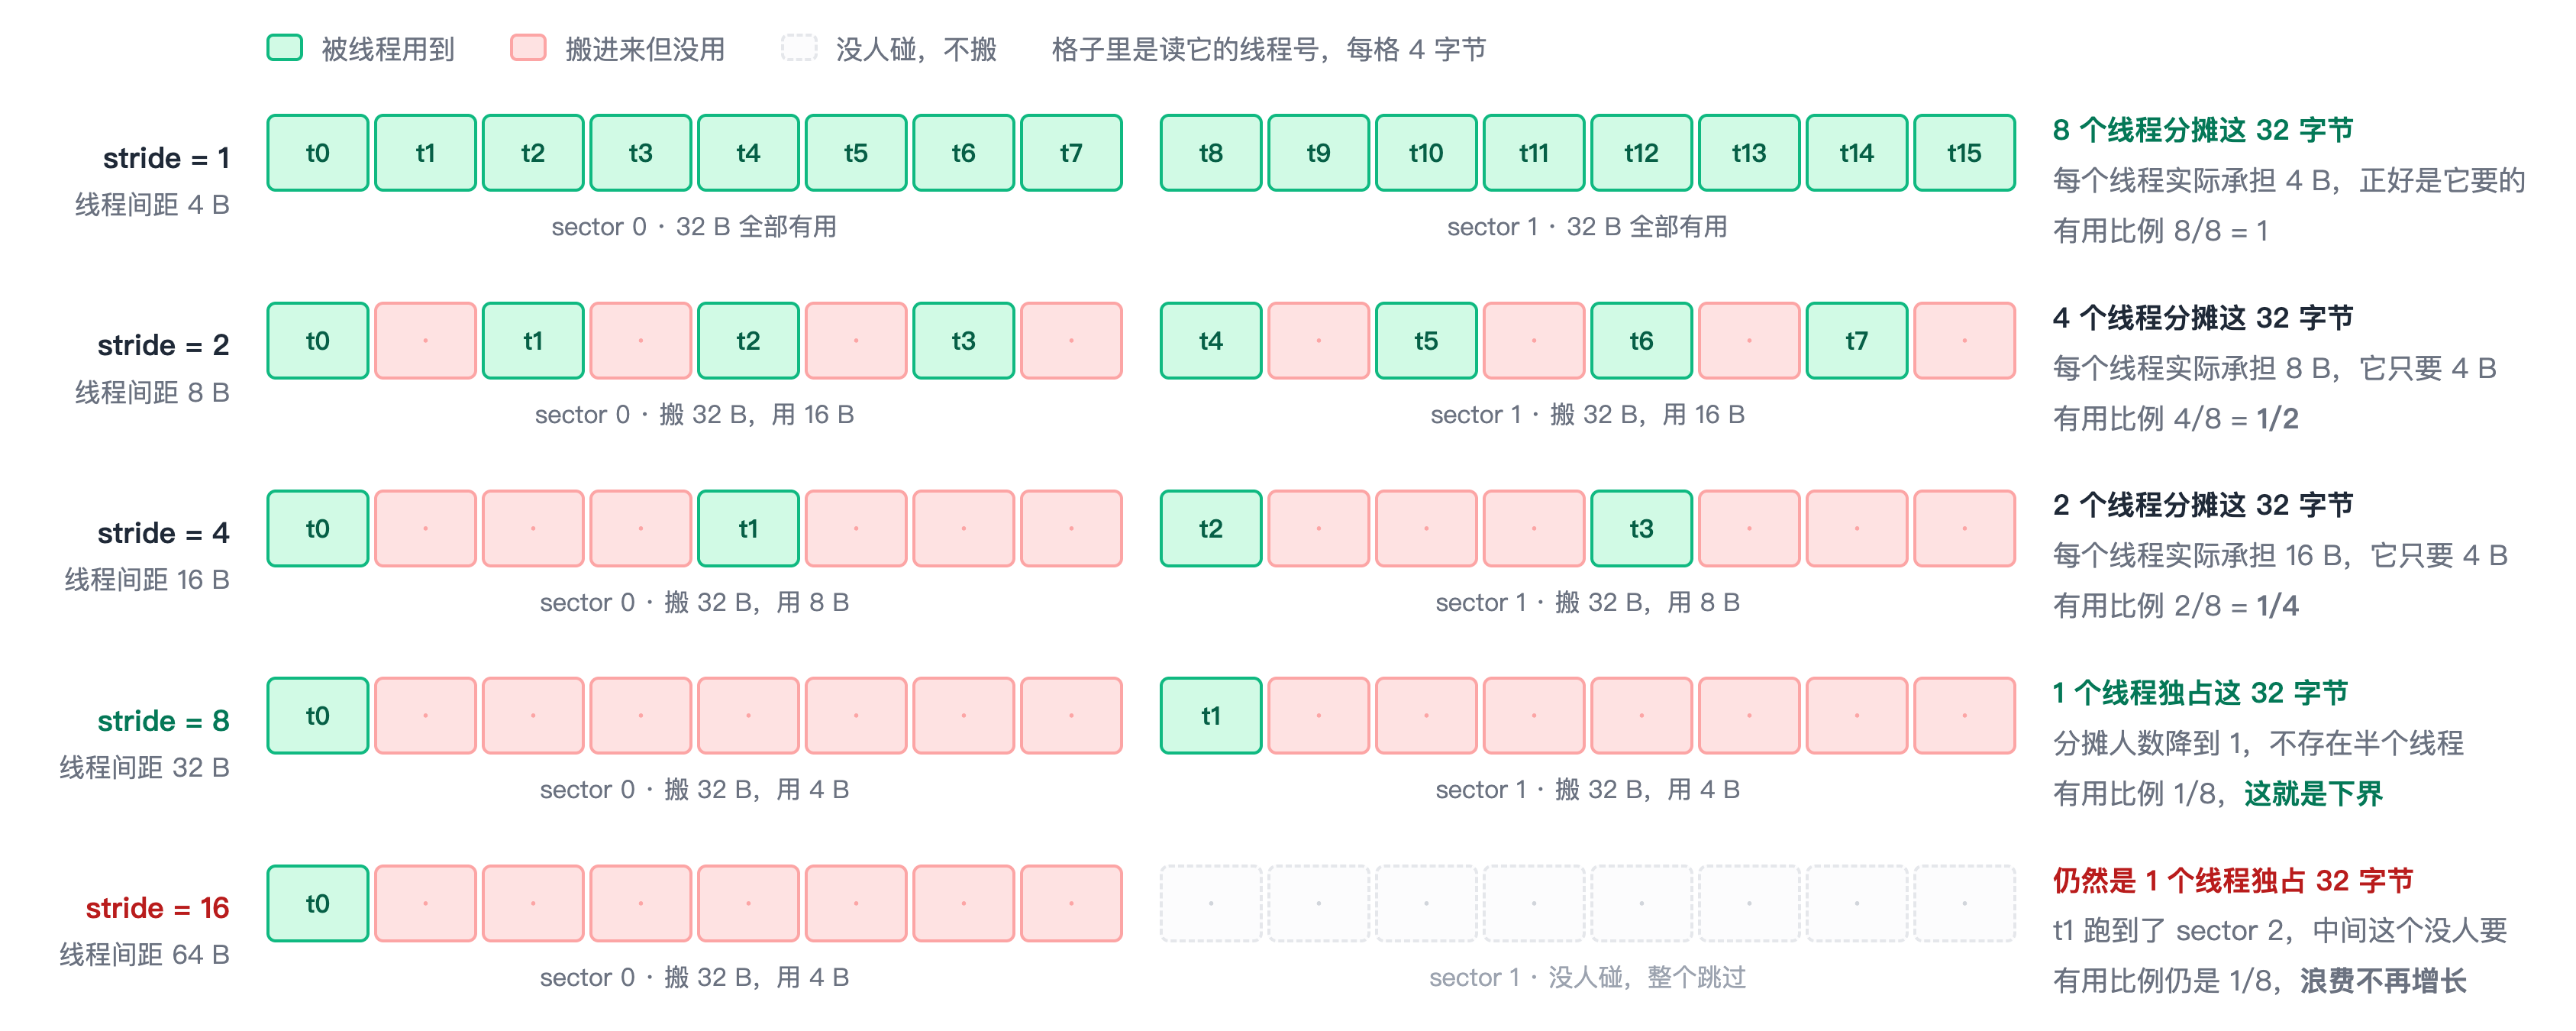
不同 stride 的 Sectors/Req 指标 - 在 2 ≤ stride ≤ 8 时,有效带宽约等于 1/stride。原因如图所示,当 stride × 4 B < sector 容量 32B 时,多条 lane 可以共用一个 sector,有效带宽随着 stride 的上升而下降。
- 在 stride = 8 时,每个 lane 独占一个 sector,Sectors/Req 指标,不会再随着 stride 的增大而增大
- 在 stride > 8 时,Sectors/Req 恒为 32,但有效带宽继续下降:369.9 → 264.8 → 172.2 GB/s。此时原因不再是 sector 限制,而是和「为什么有效带宽只有理论带宽的 54%」 一致。
非对齐访问:读端起始地址偏移对带宽的影响
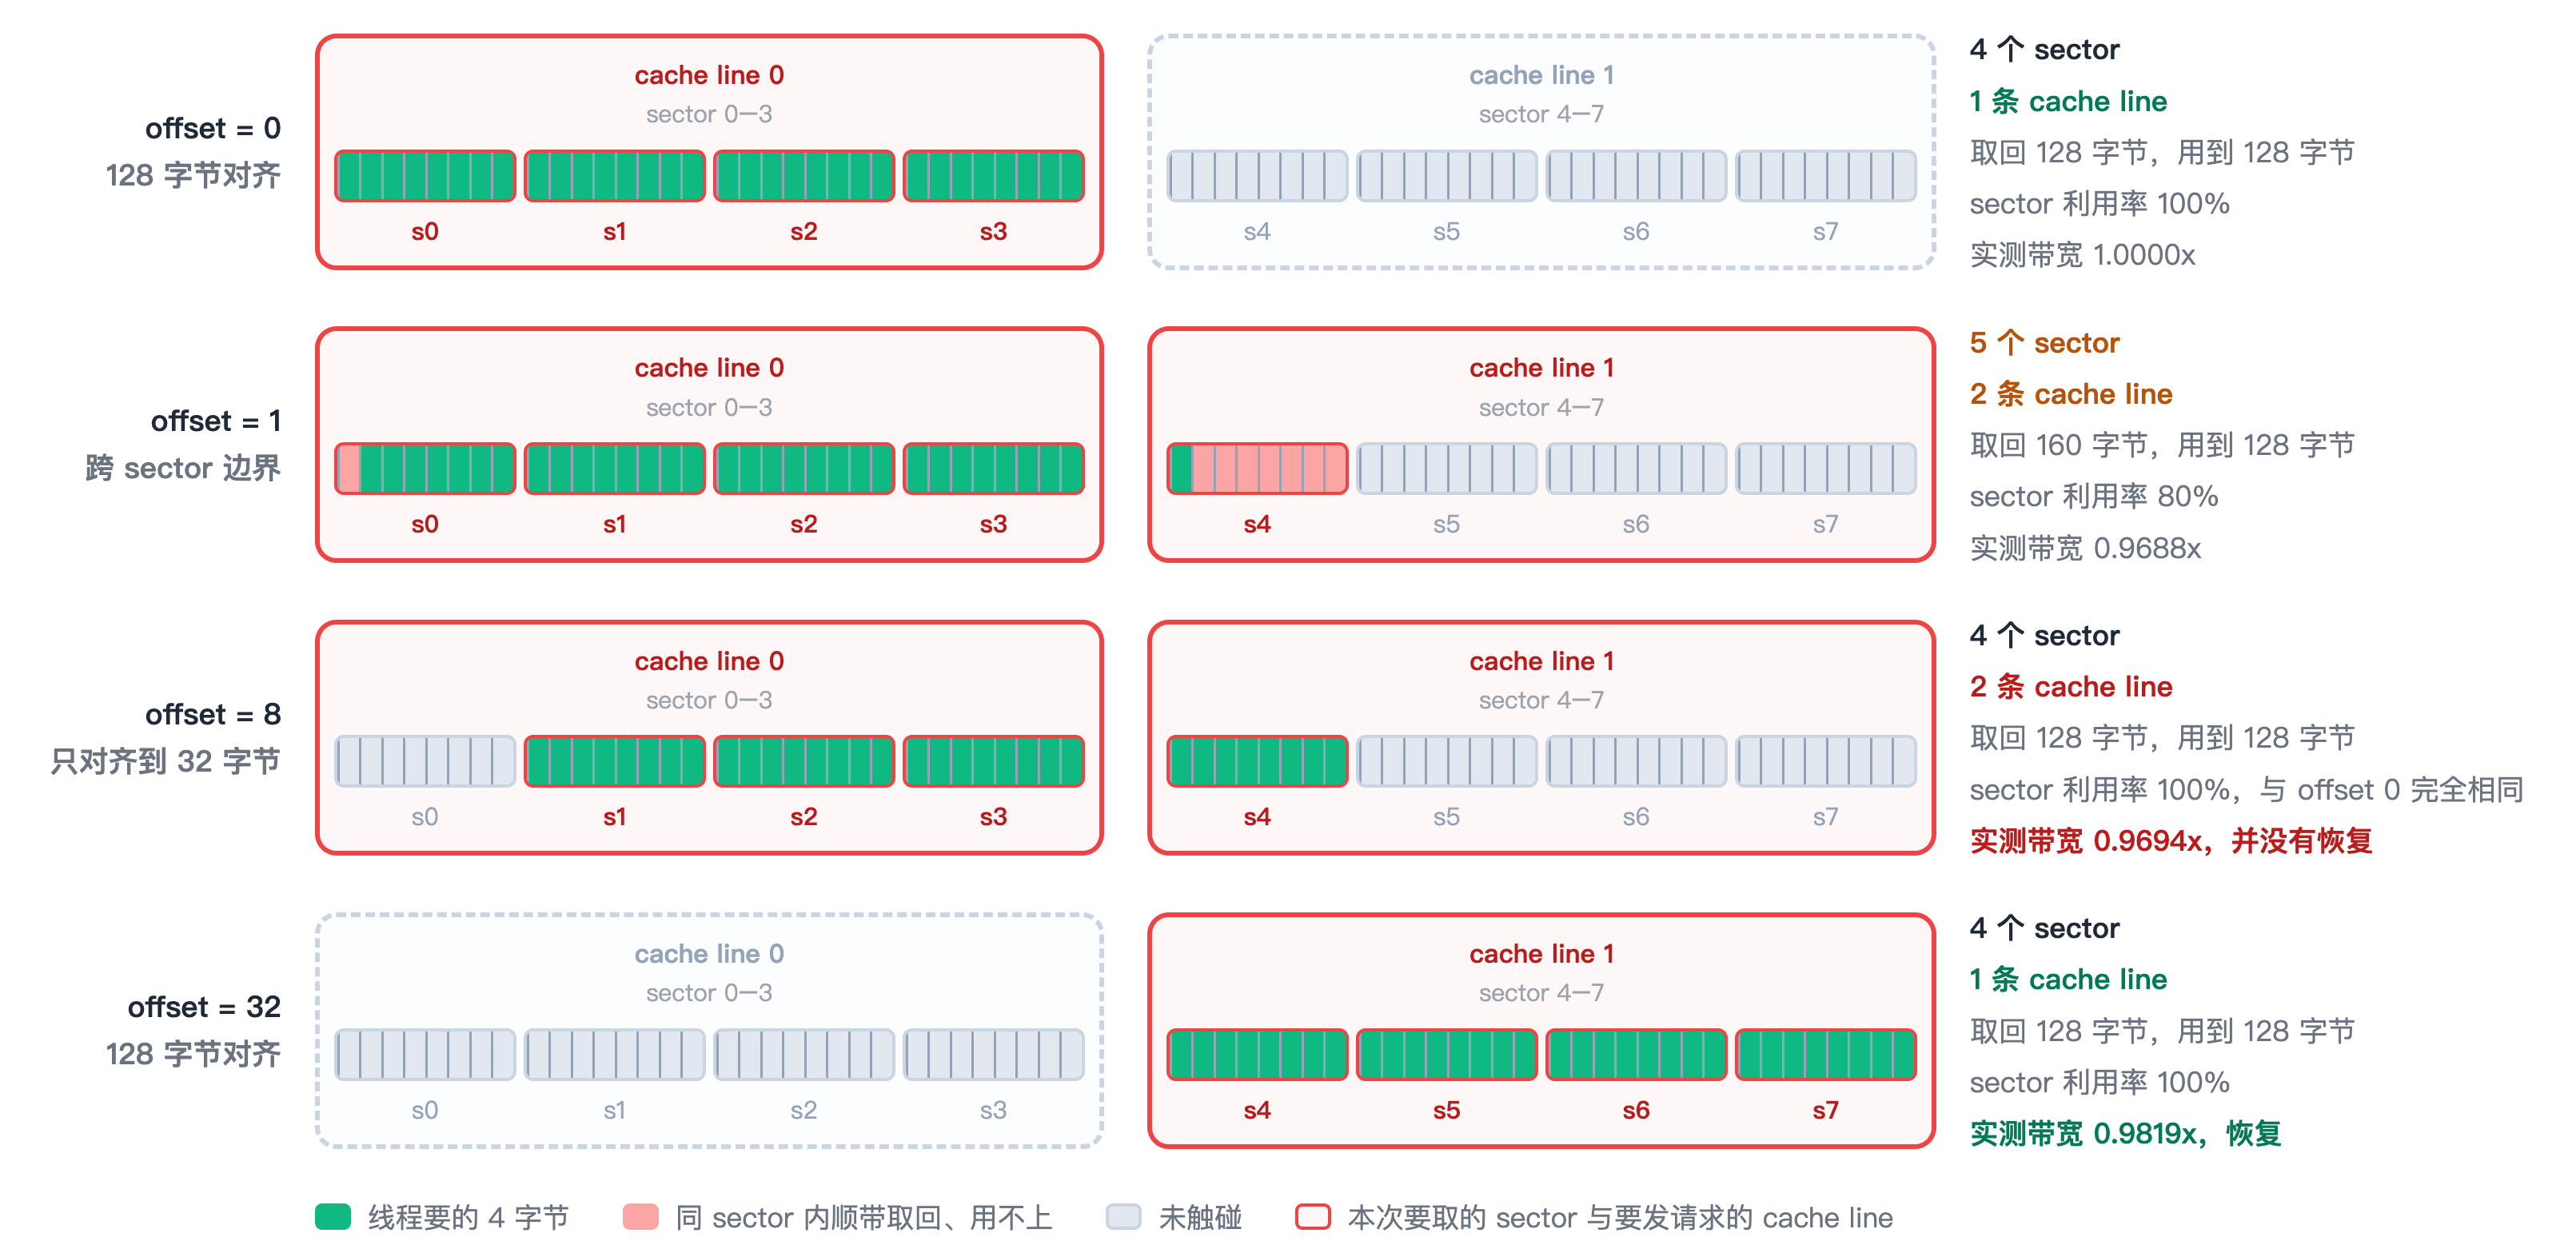
1 ≤ offset ≤ 31 时,存在两个原因会导致有效带宽降低
- offset 对齐 sector 时,一个 warp 访存时,会额外多读一个 cache line
- offset 没对齐 sector 时,除了额外多读一个 cache line,还需要额外多获取一个 sector 的数据
完整代码参见:https://github.com/boxtsecond/ai-infra-learn/blob/main/cuda/memory-lab-code/src/l2_offset.cu
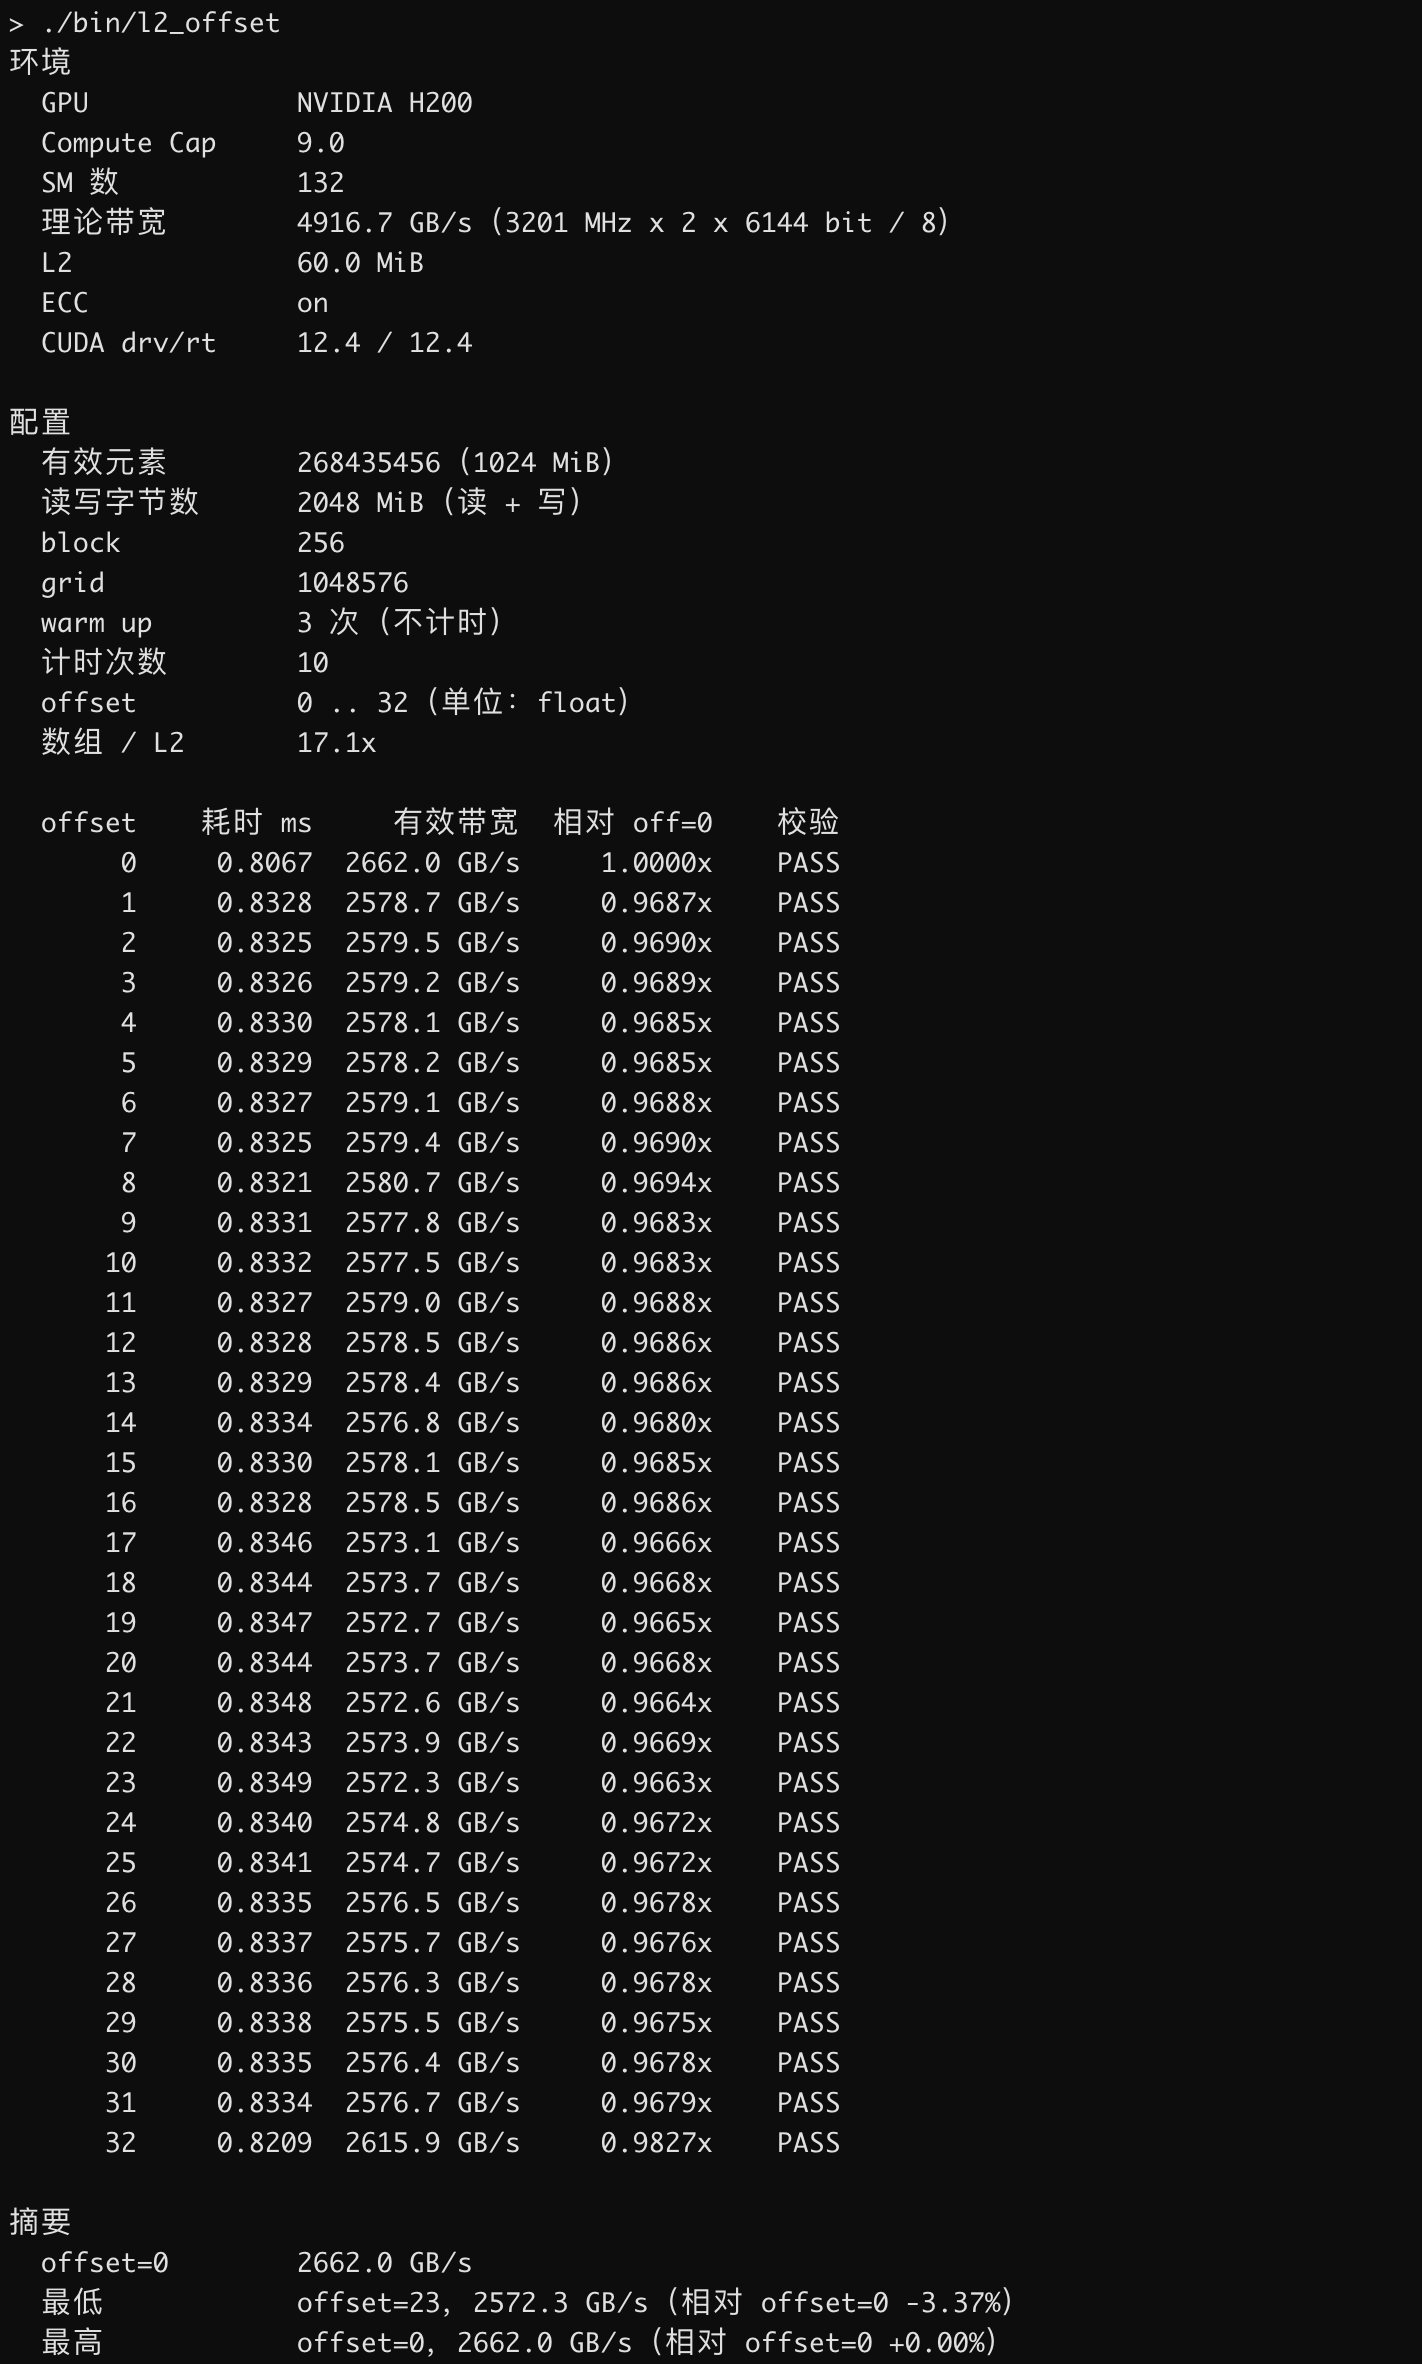
-
offset = 1,sector = 5
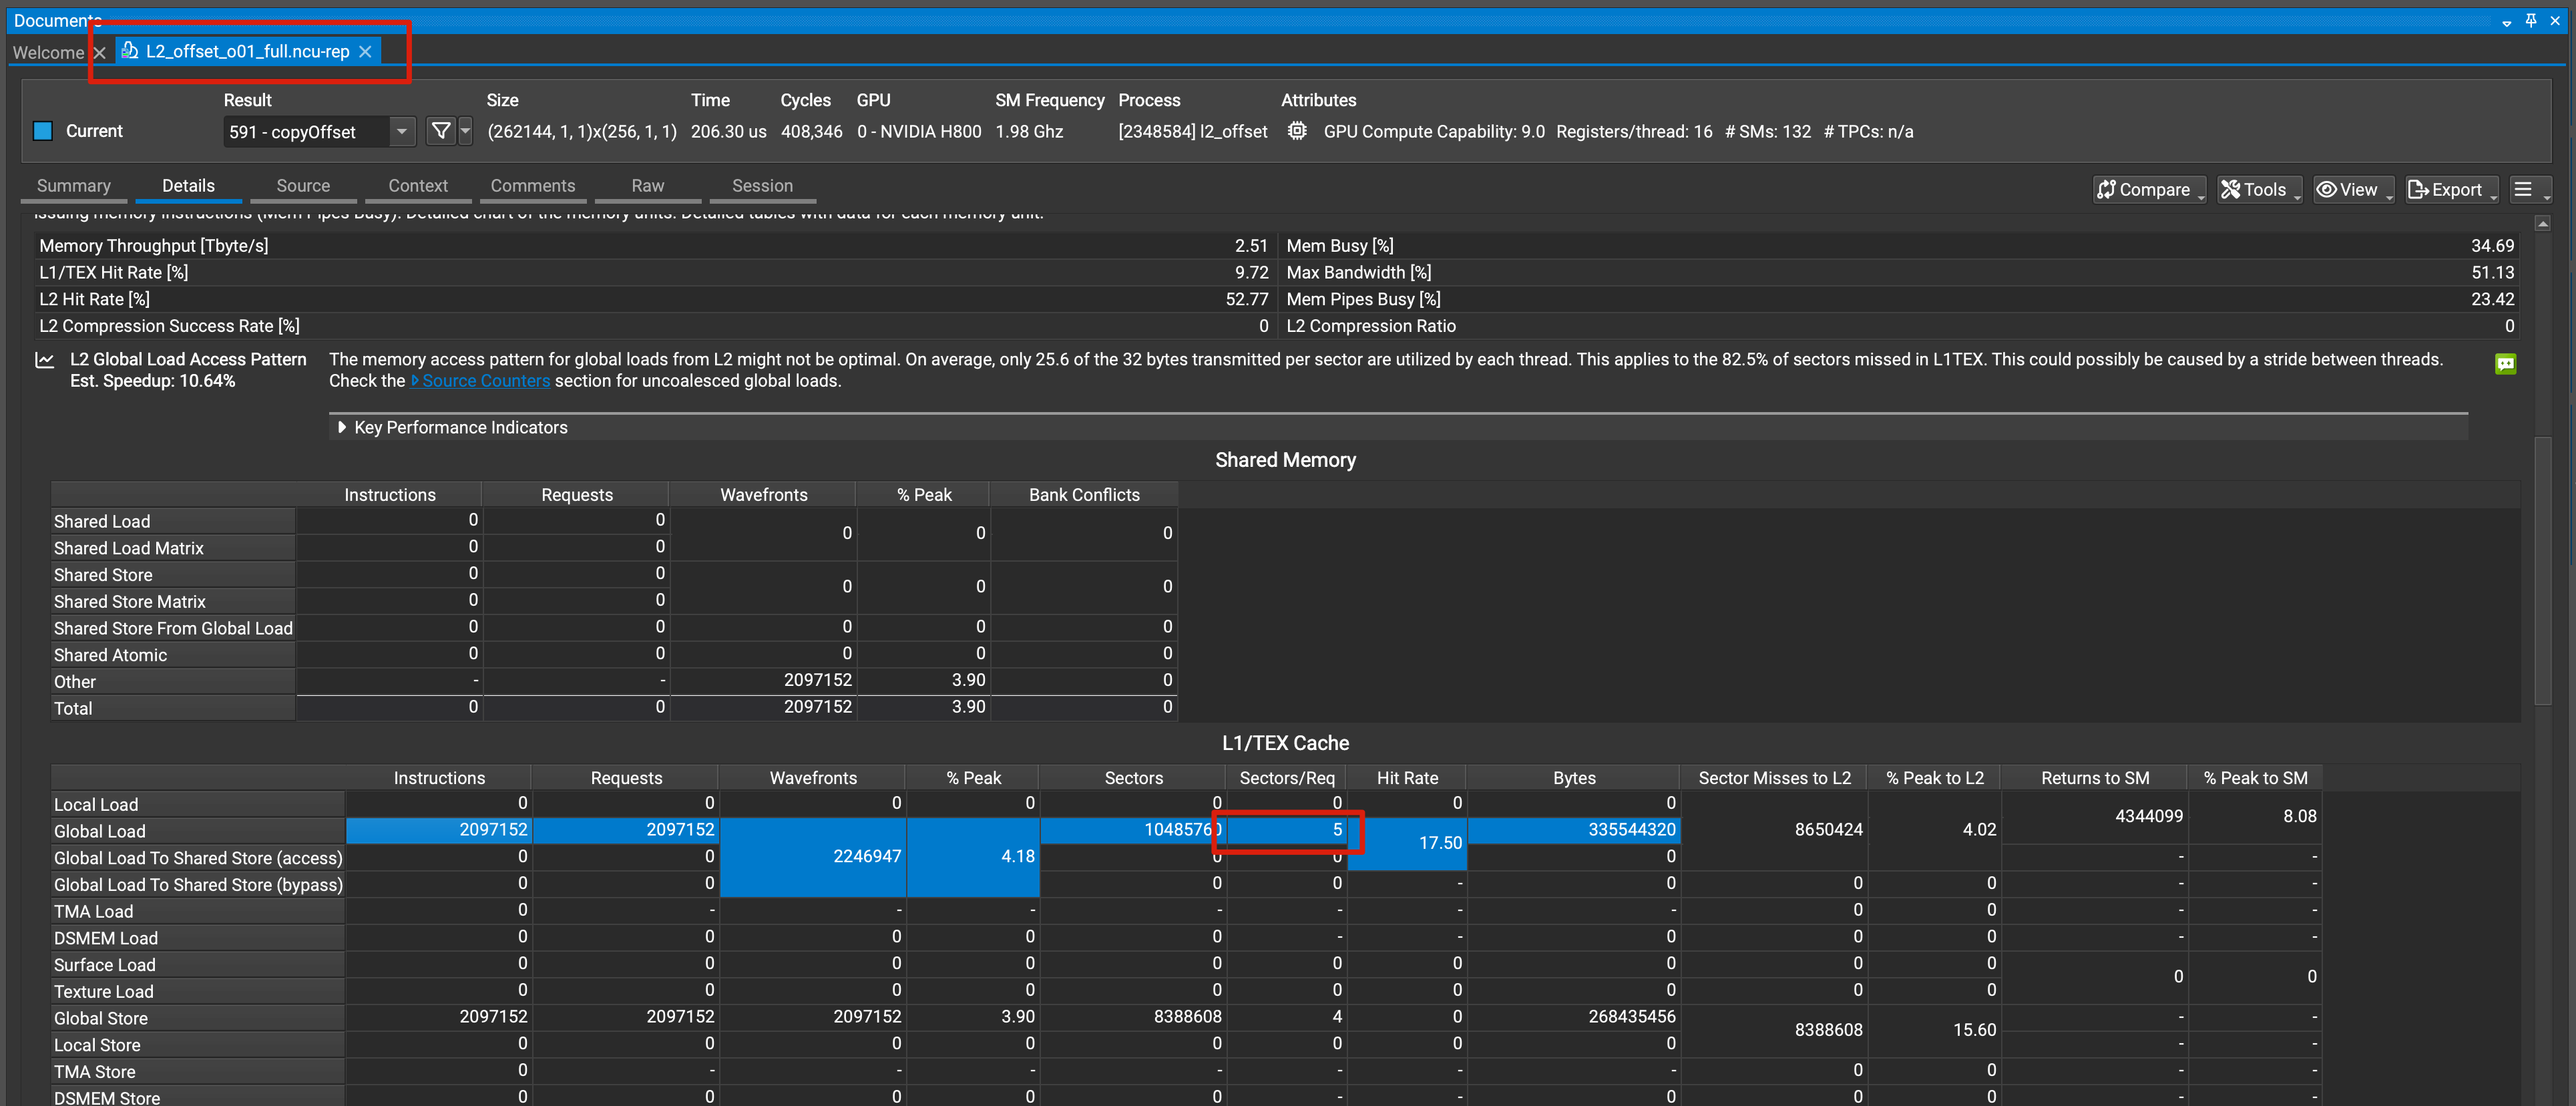
offset = 1 的 L1/TEX Cache 指标 -
offset = 0、8、16、32,sector = 4。以 offset = 8 举例
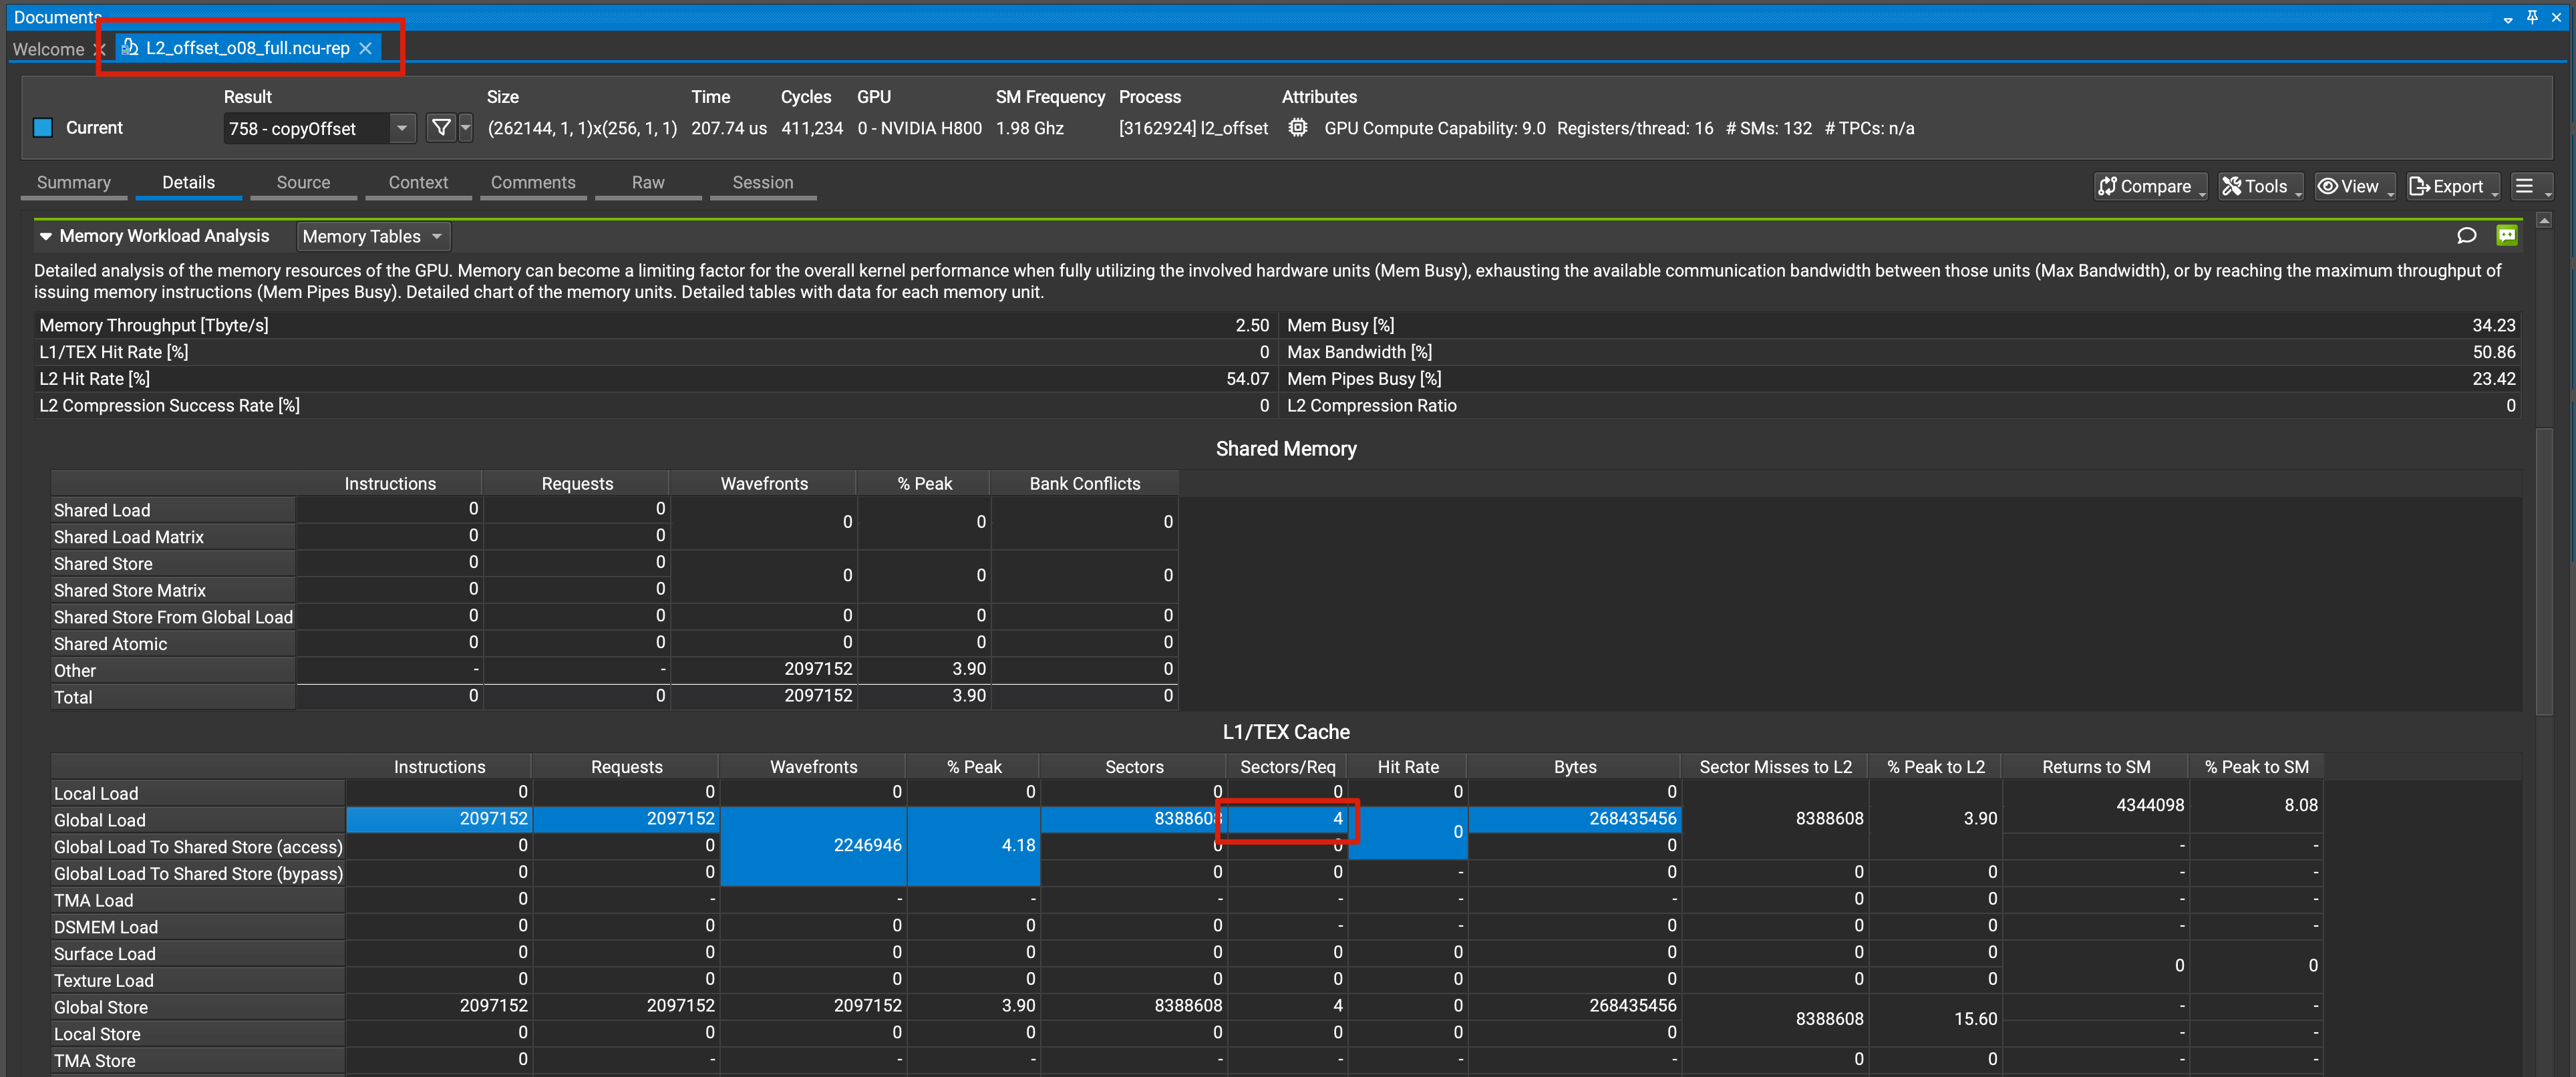
offset = 8 的 L1/TEX Cache 指标
AoS 与 SoA 两种内存布局的读带宽
 // AoS (Array of Structures) —— 线程 i 读 arr[i].x,实际 stride = 3
 struct Vec { float x, y, z; };
 Vec arr[N];

 // SoA (Structure of Arrays) —— 线程 i 读 x[i],stride = 1
 float x[N], y[N], z[N];
完整代码参见:https://github.com/boxtsecond/ai-infra-learn/blob/main/cuda/memory-lab-code/src/l3_layout.cu
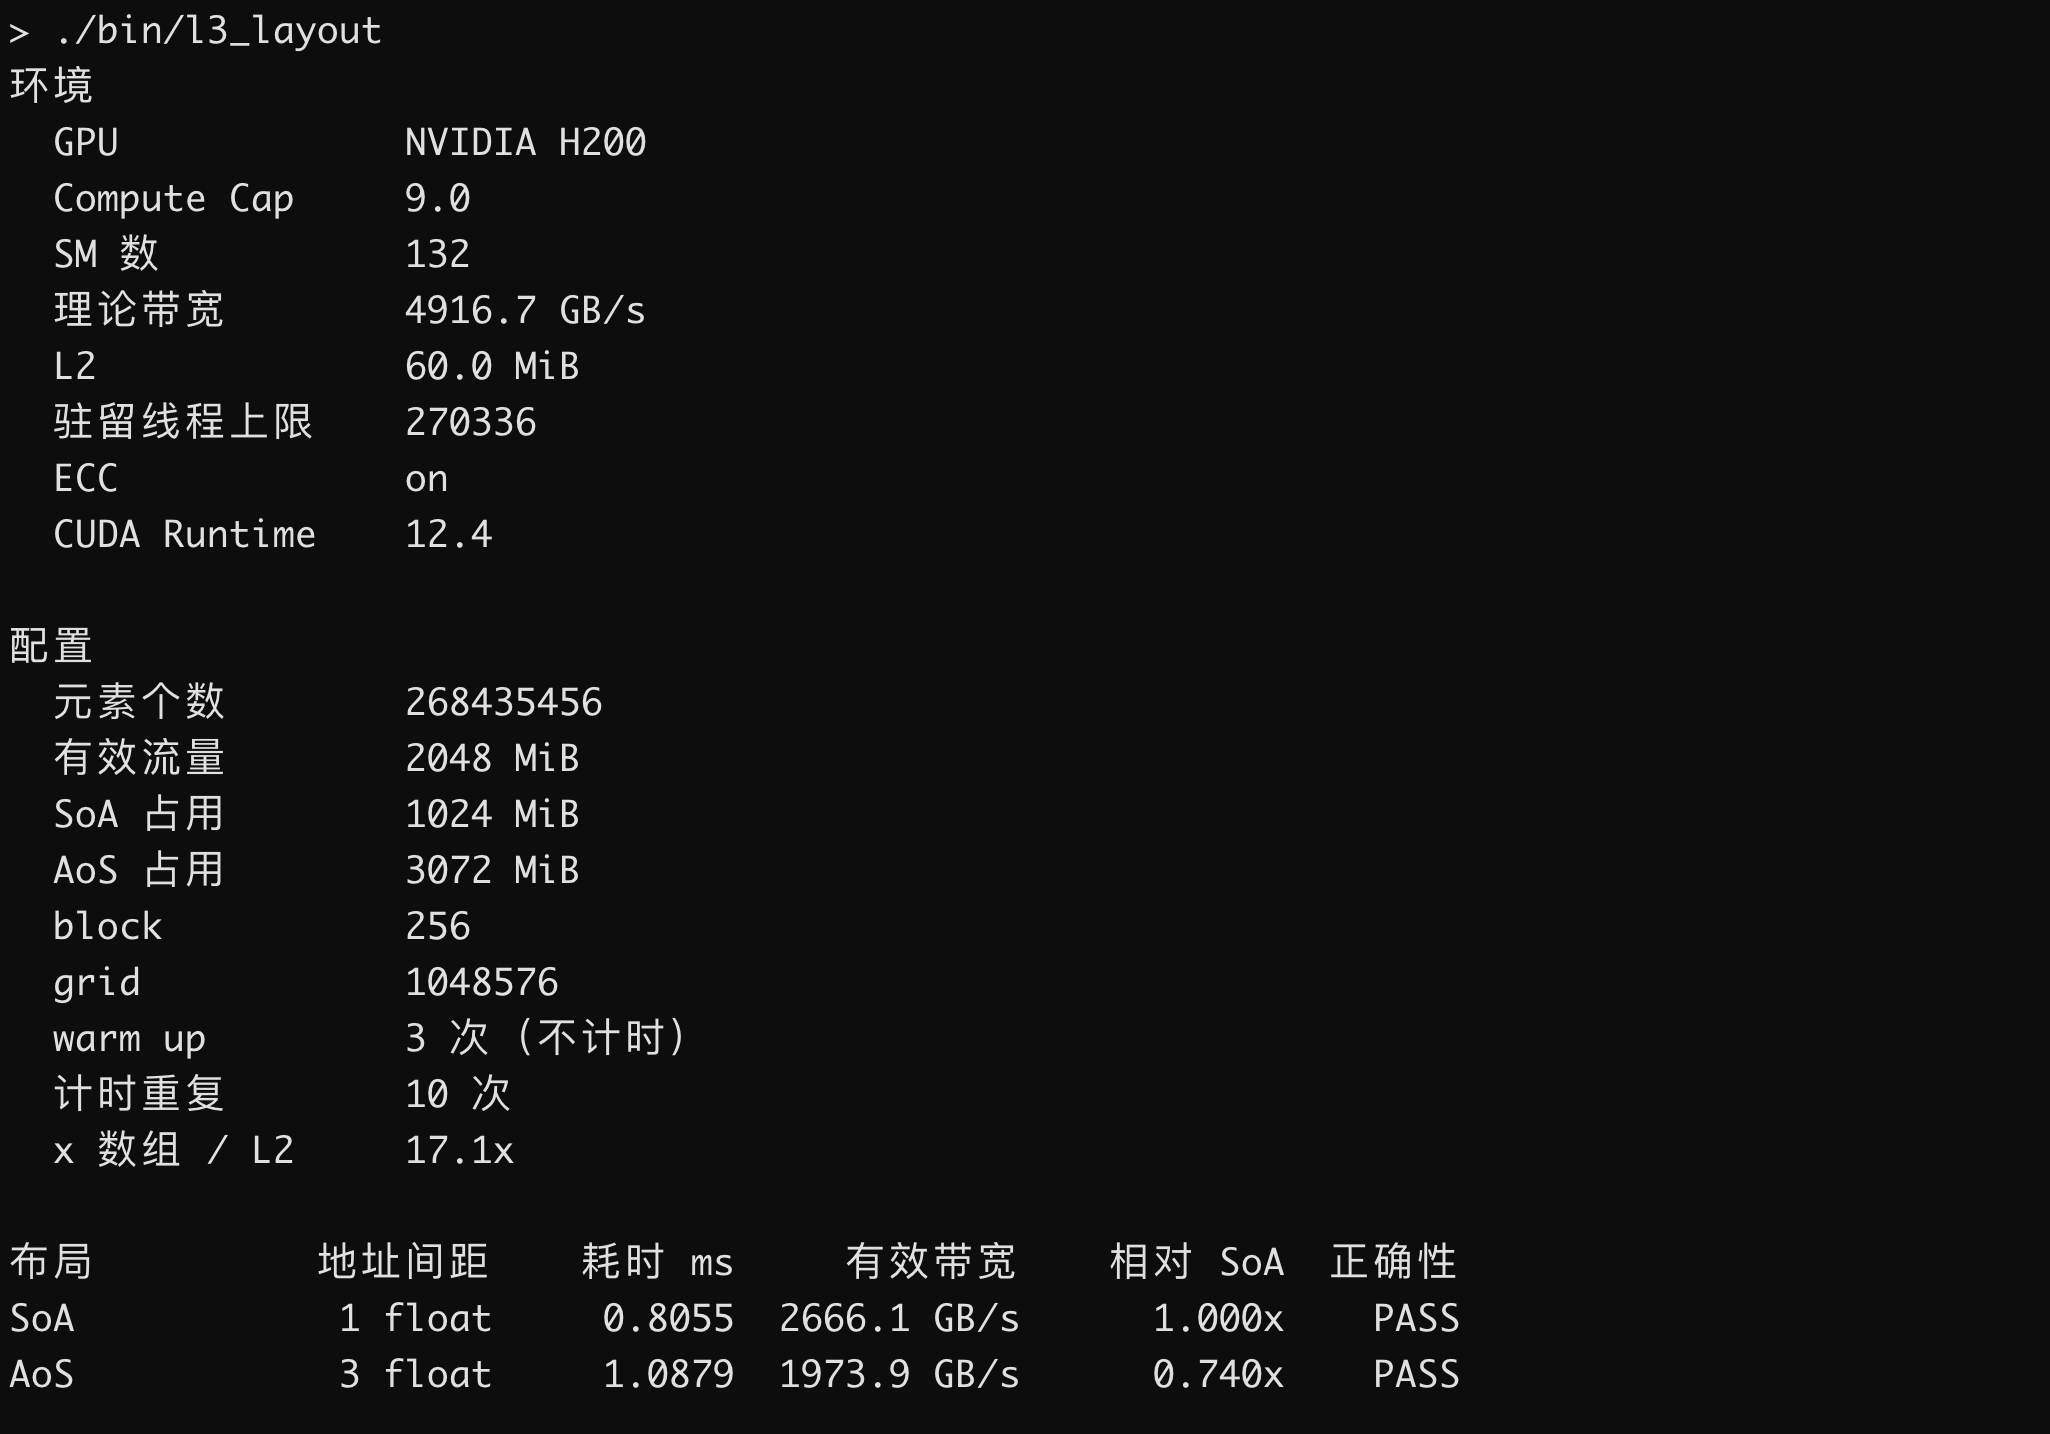
之前在「跨步访问:相邻线程的地址间距对带宽的影响」的实验中,读写都跨步,而当前实验只有读跨步,因此需要对跨步访问的实验做些改造,获取出仅对读跨步的有效带宽,并验证 stride = 3 时,有效带宽是否和 AoS 一致。
跨步访问的改造代码参见:link
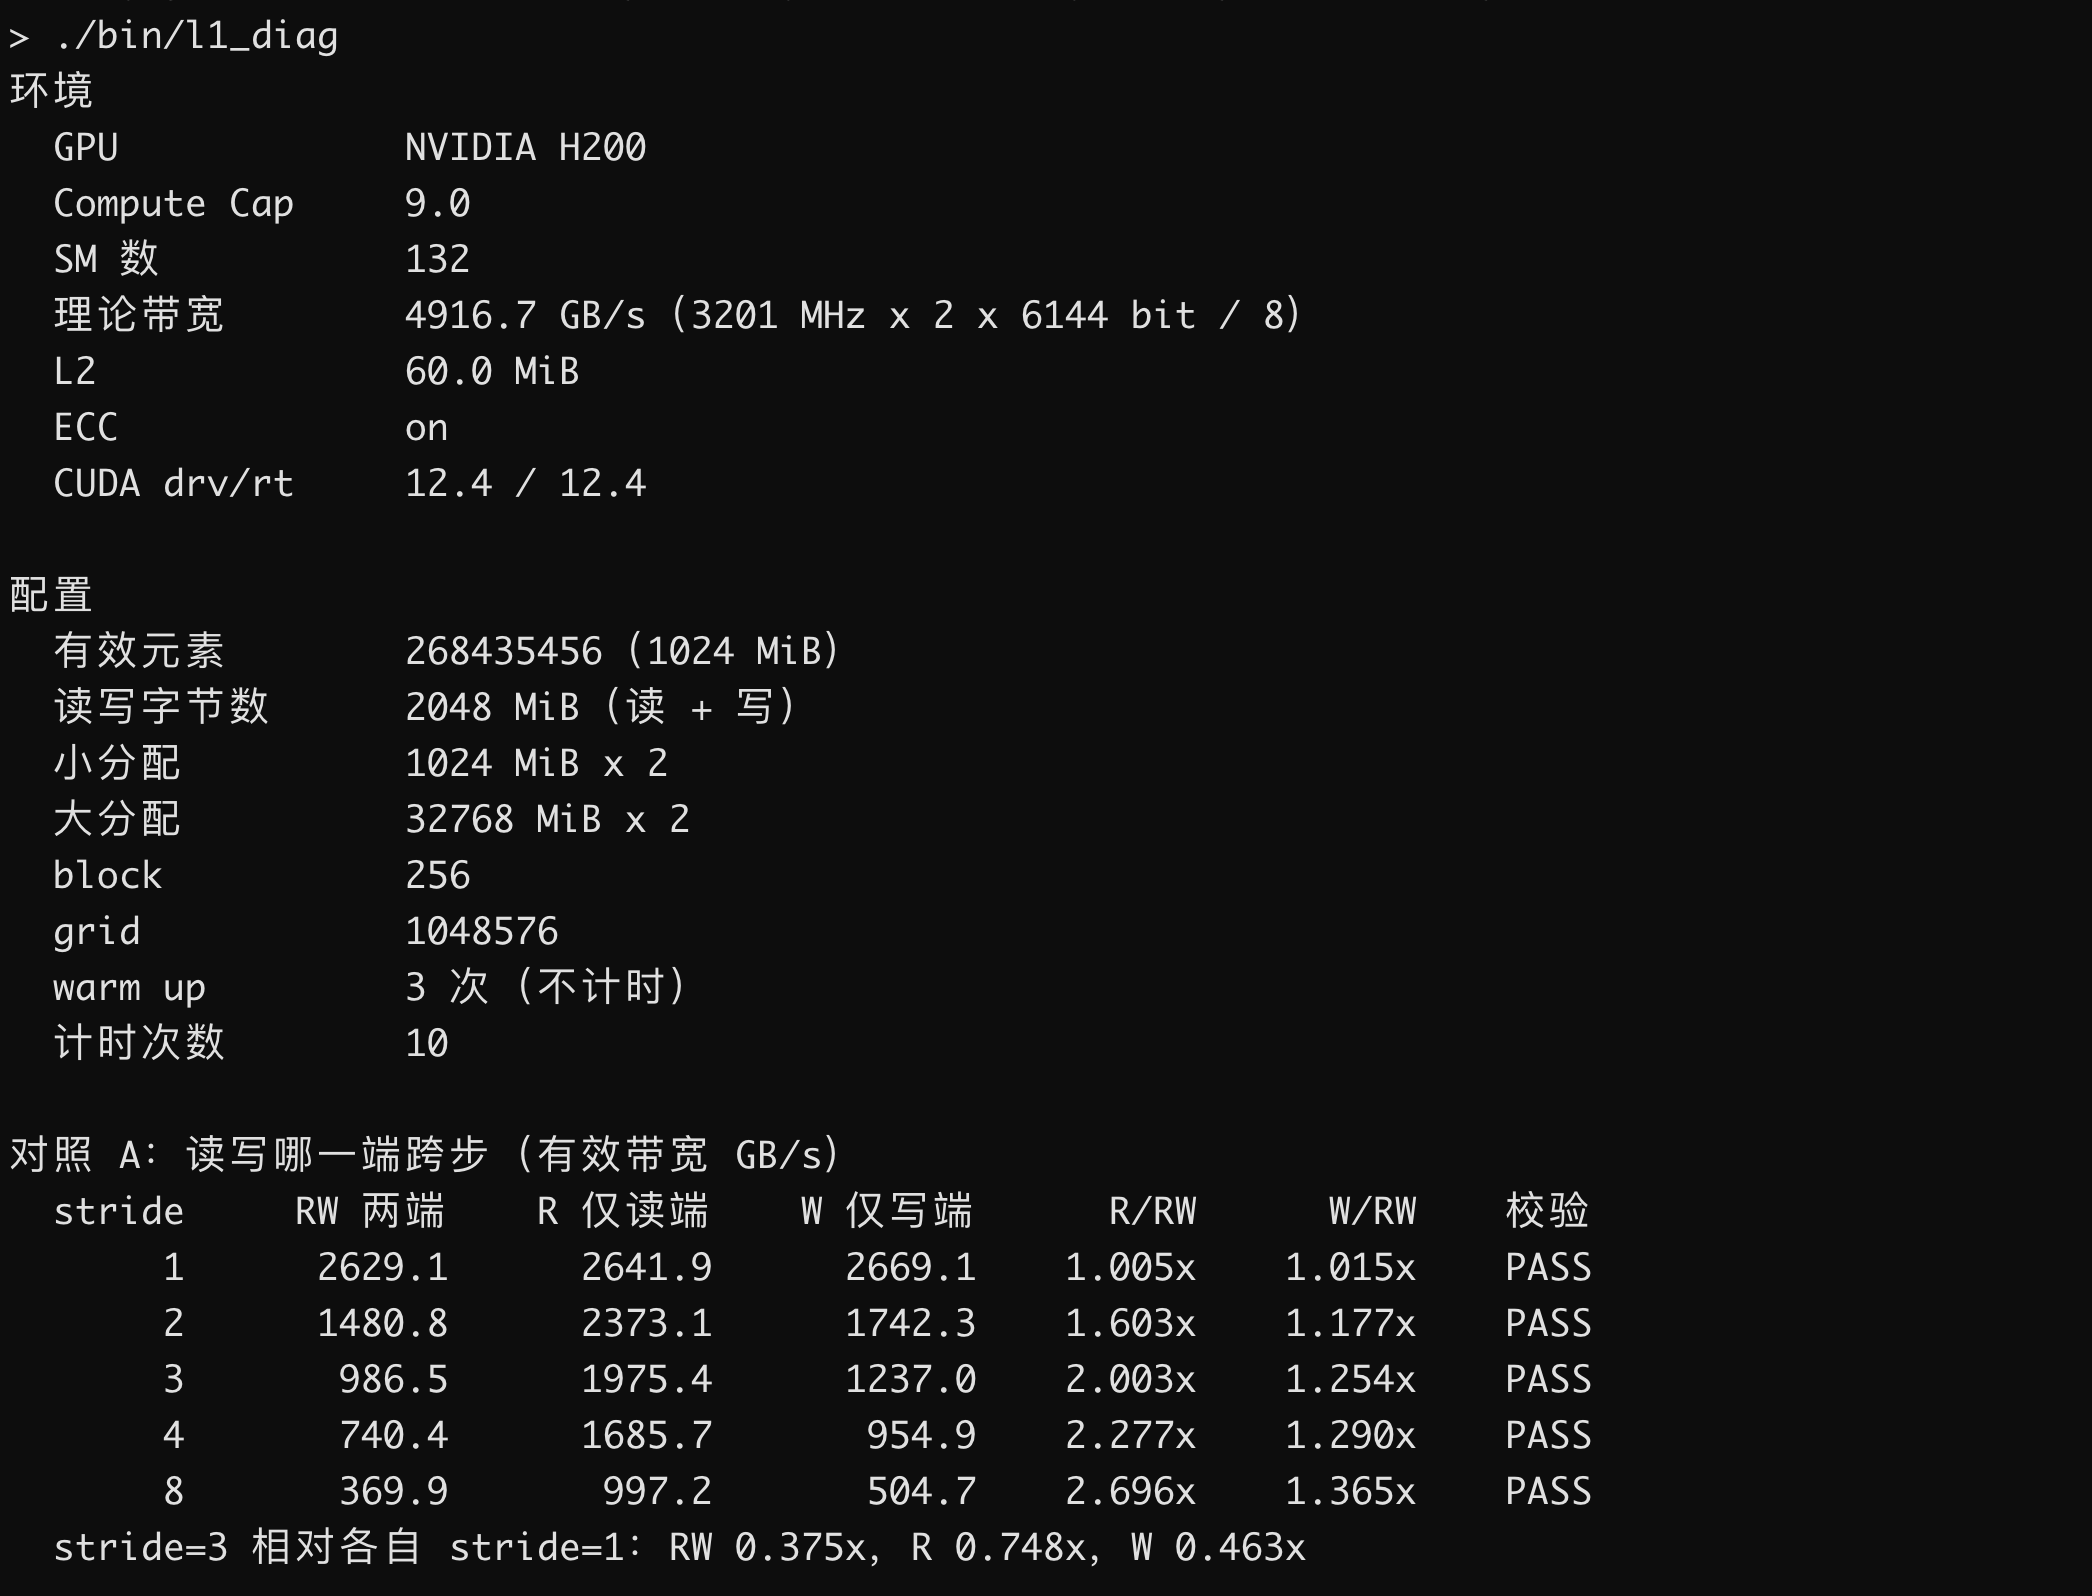
可以看到,实际 stride = 3 的仅读跨步,约等于 AoS 有效带宽。
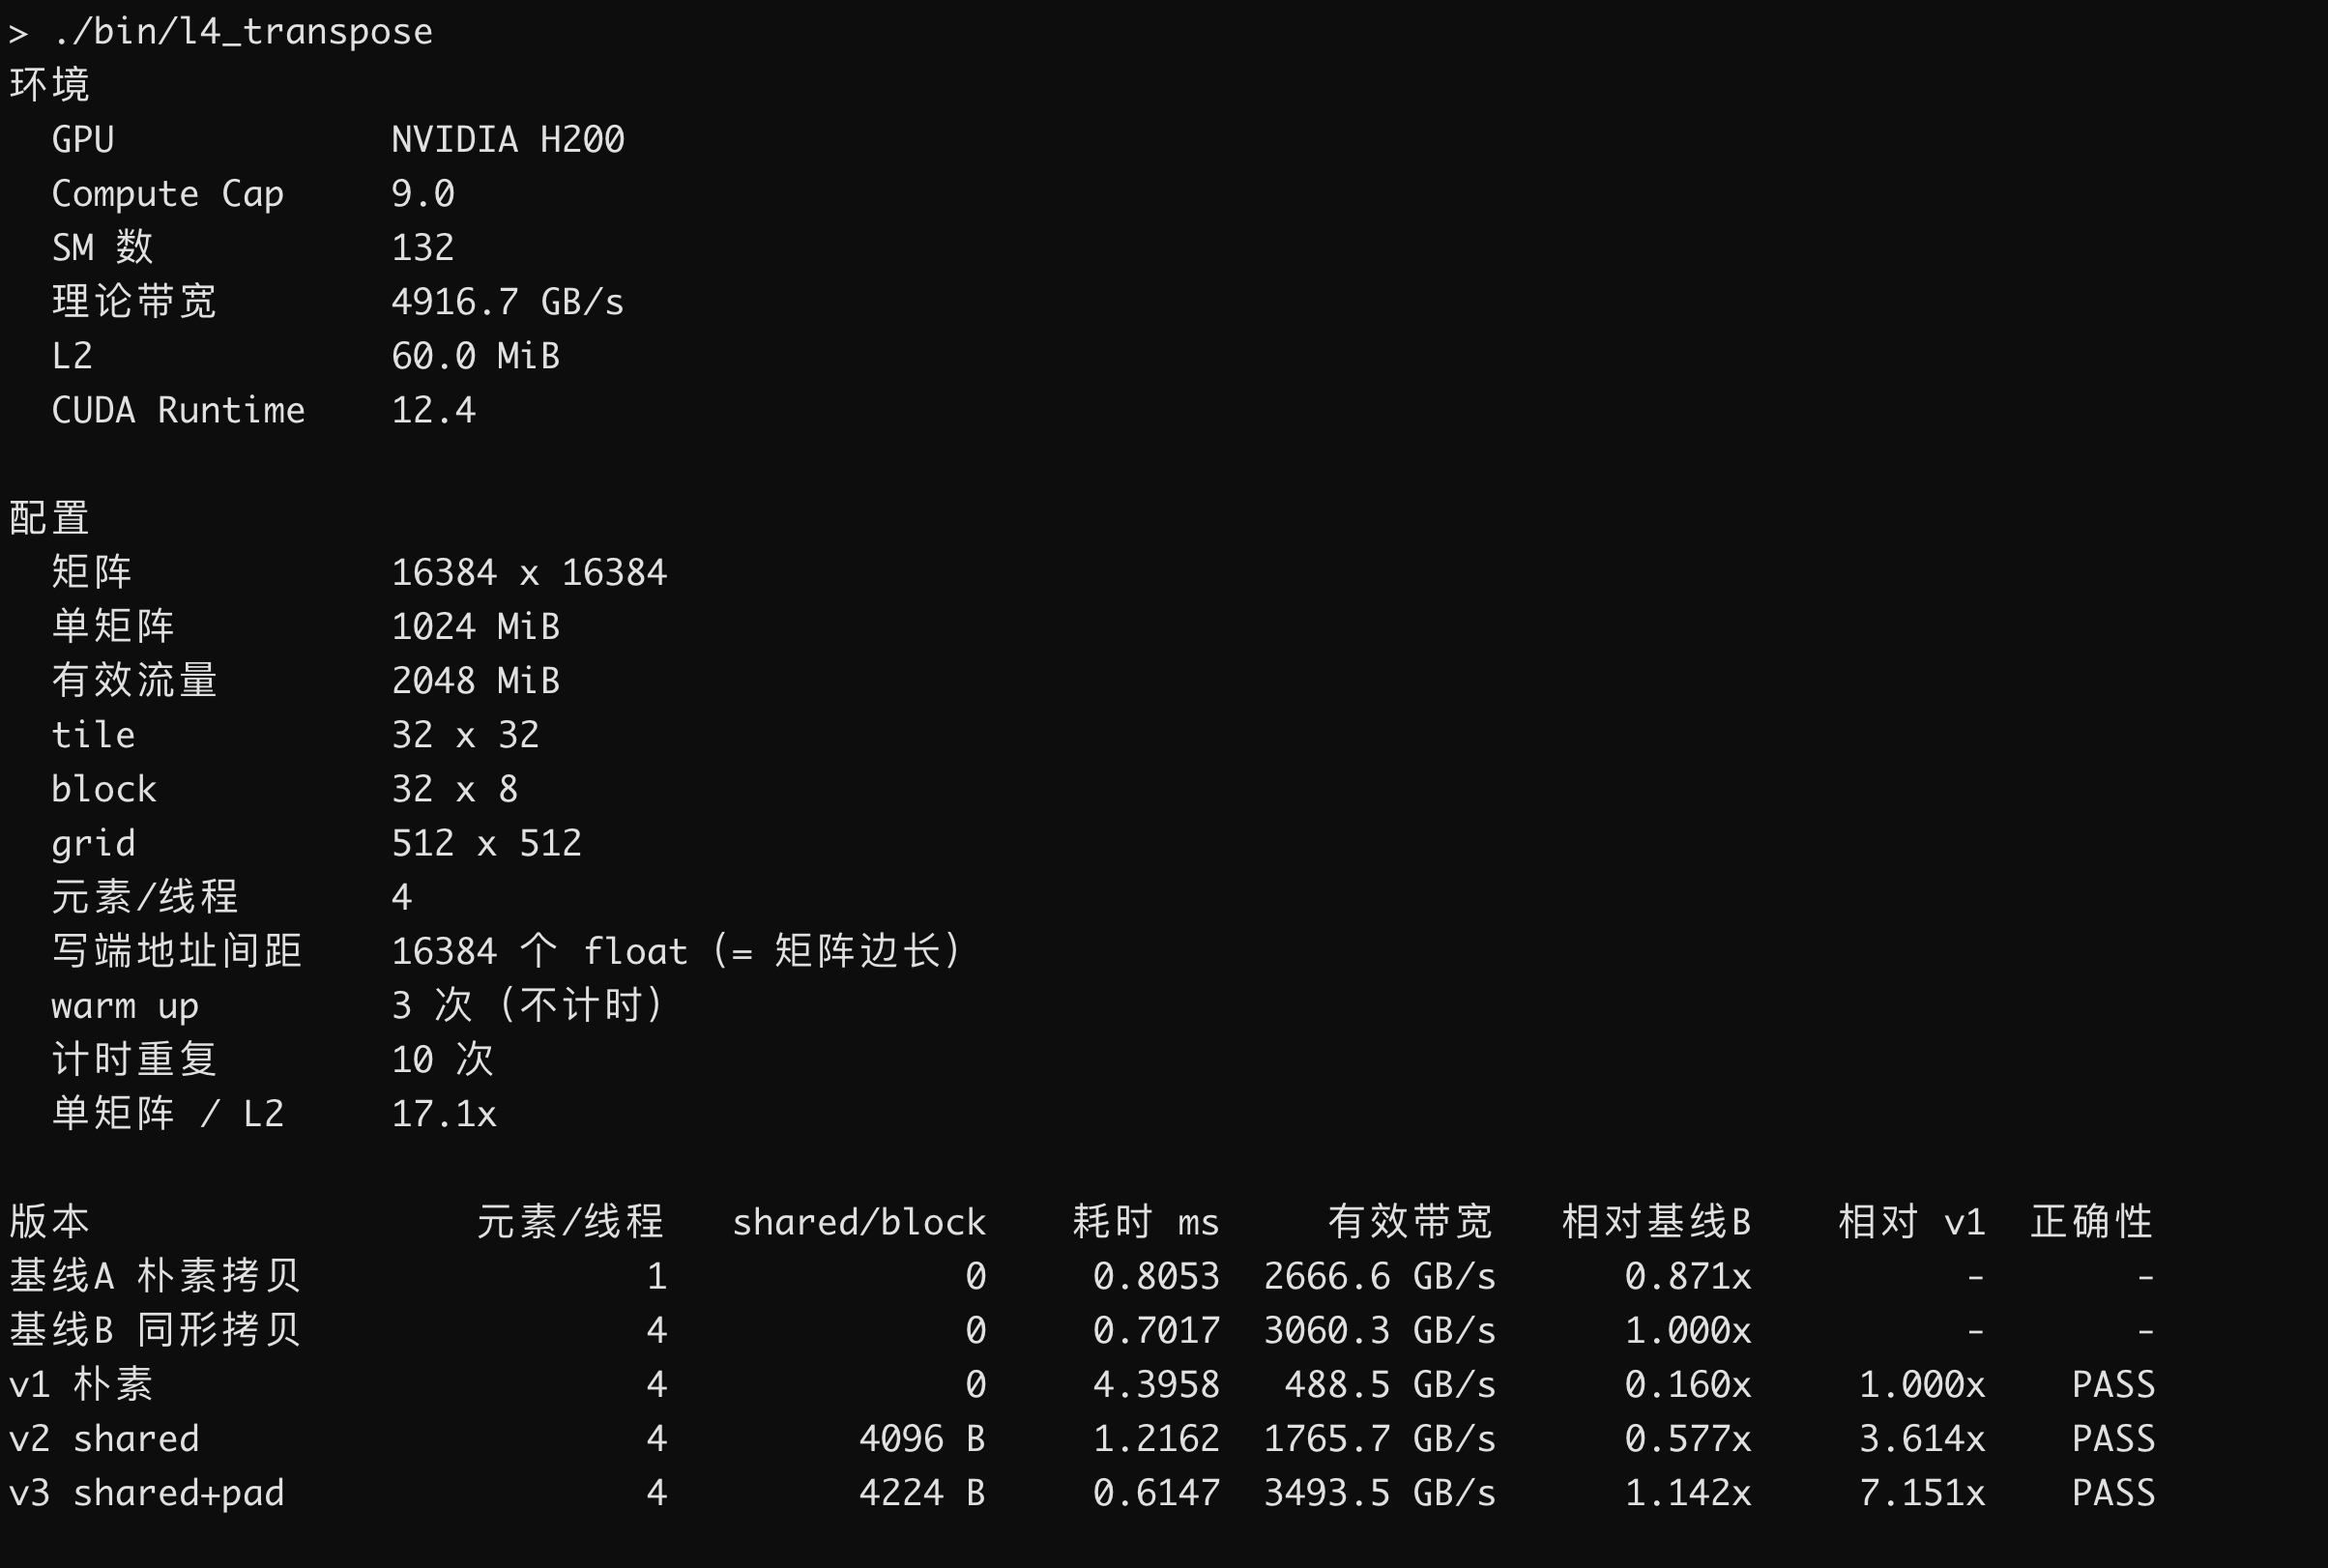
矩阵转置
矩阵转置最佳优化方式参考:https://docs.nvidia.com/cuda/cuda-c-best-practices-guide/index.html#shared-memory-in-matrix-multiplication-c-aat
完整代码参见:https://github.com/boxtsecond/ai-infra-learn/blob/main/cuda/memory-lab-code/src/l4_transpose.cu
共享内存 bank conflict
之前的实验都是在验证**合并访存,**不同的操作对带宽的实际利用率。共享内存 bank conflict 不同,它验证的是访问数据用多少个周期,也就是耗时。
完整代码参见:https://github.com/boxtsecond/ai-infra-learn/blob/main/cuda/memory-lab-code/src/l5_bank.cu
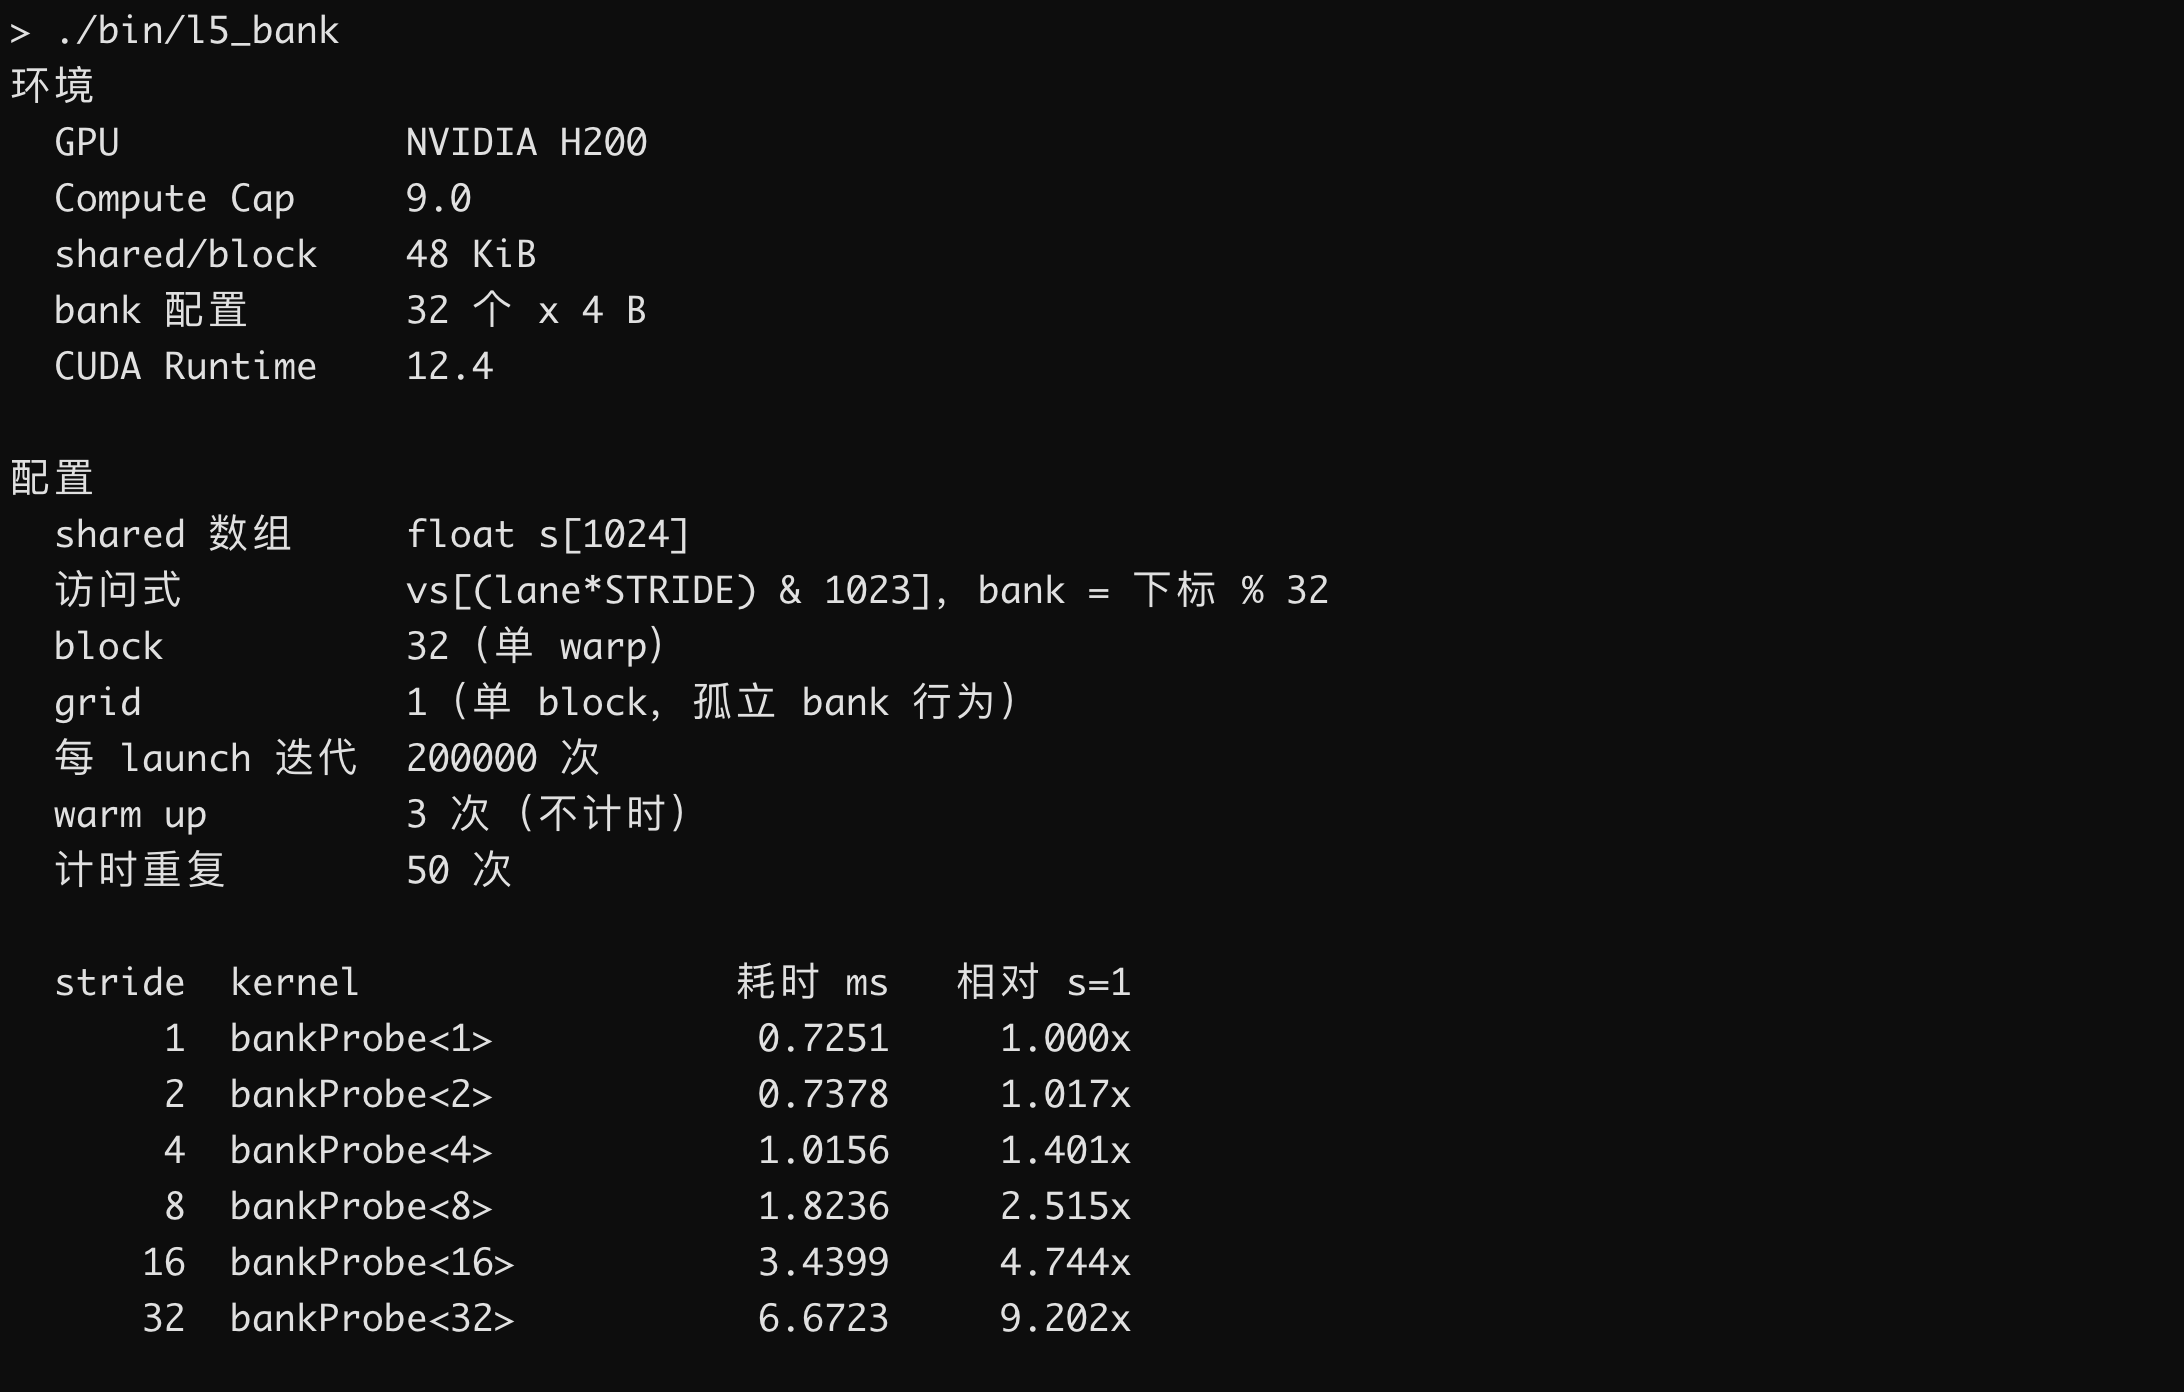
6 个 launch,对应 stride 1/2/4/8/16/32
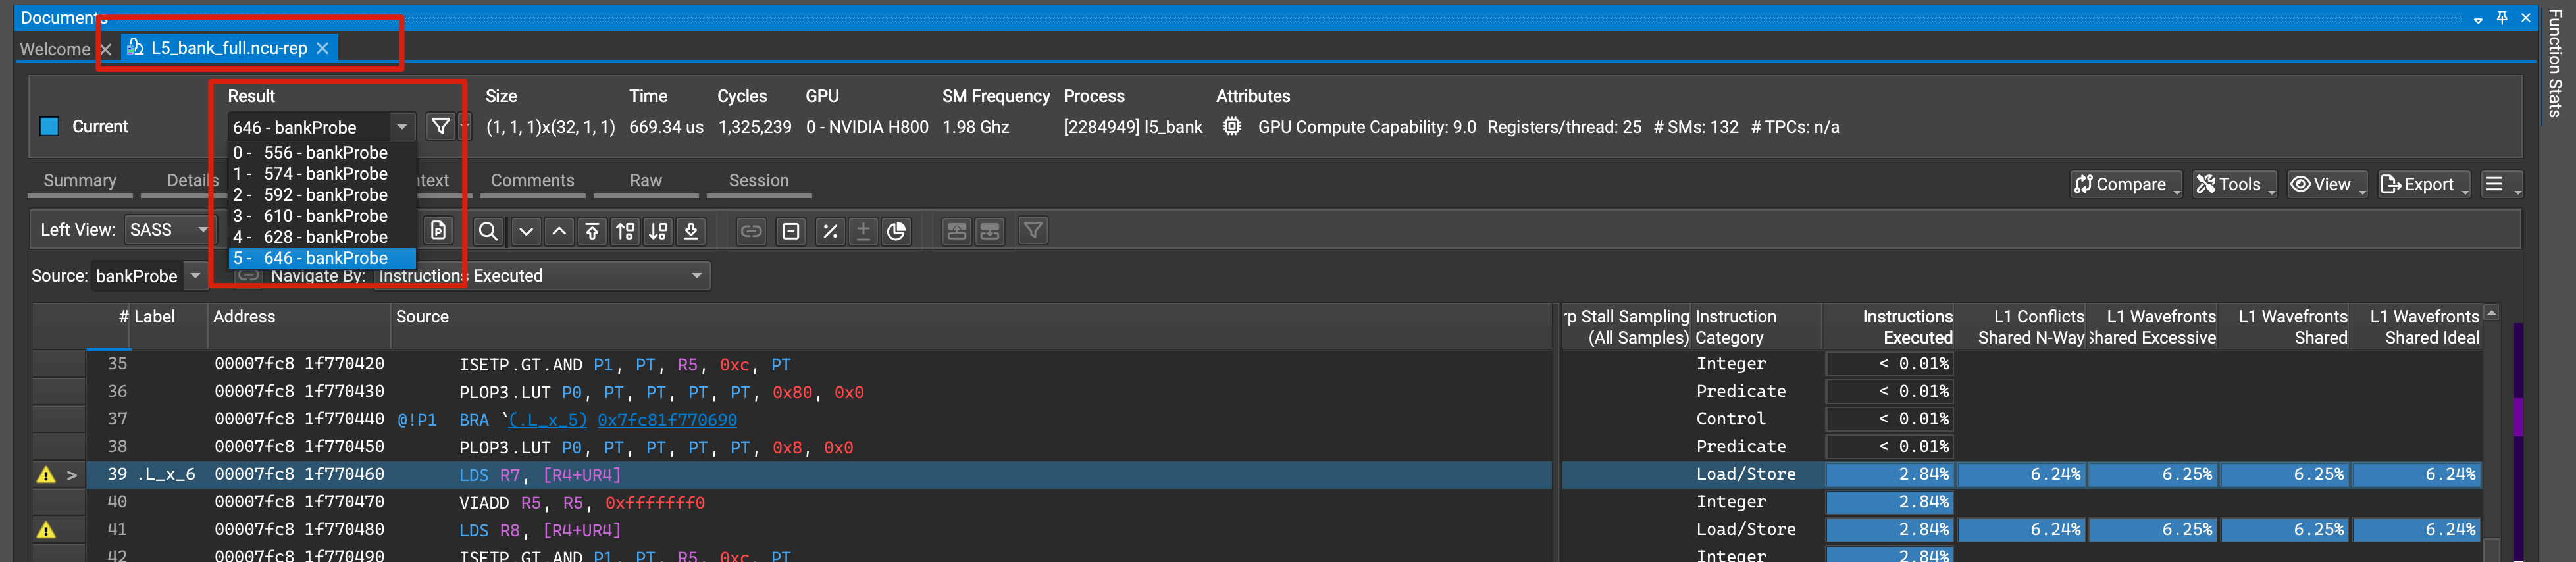
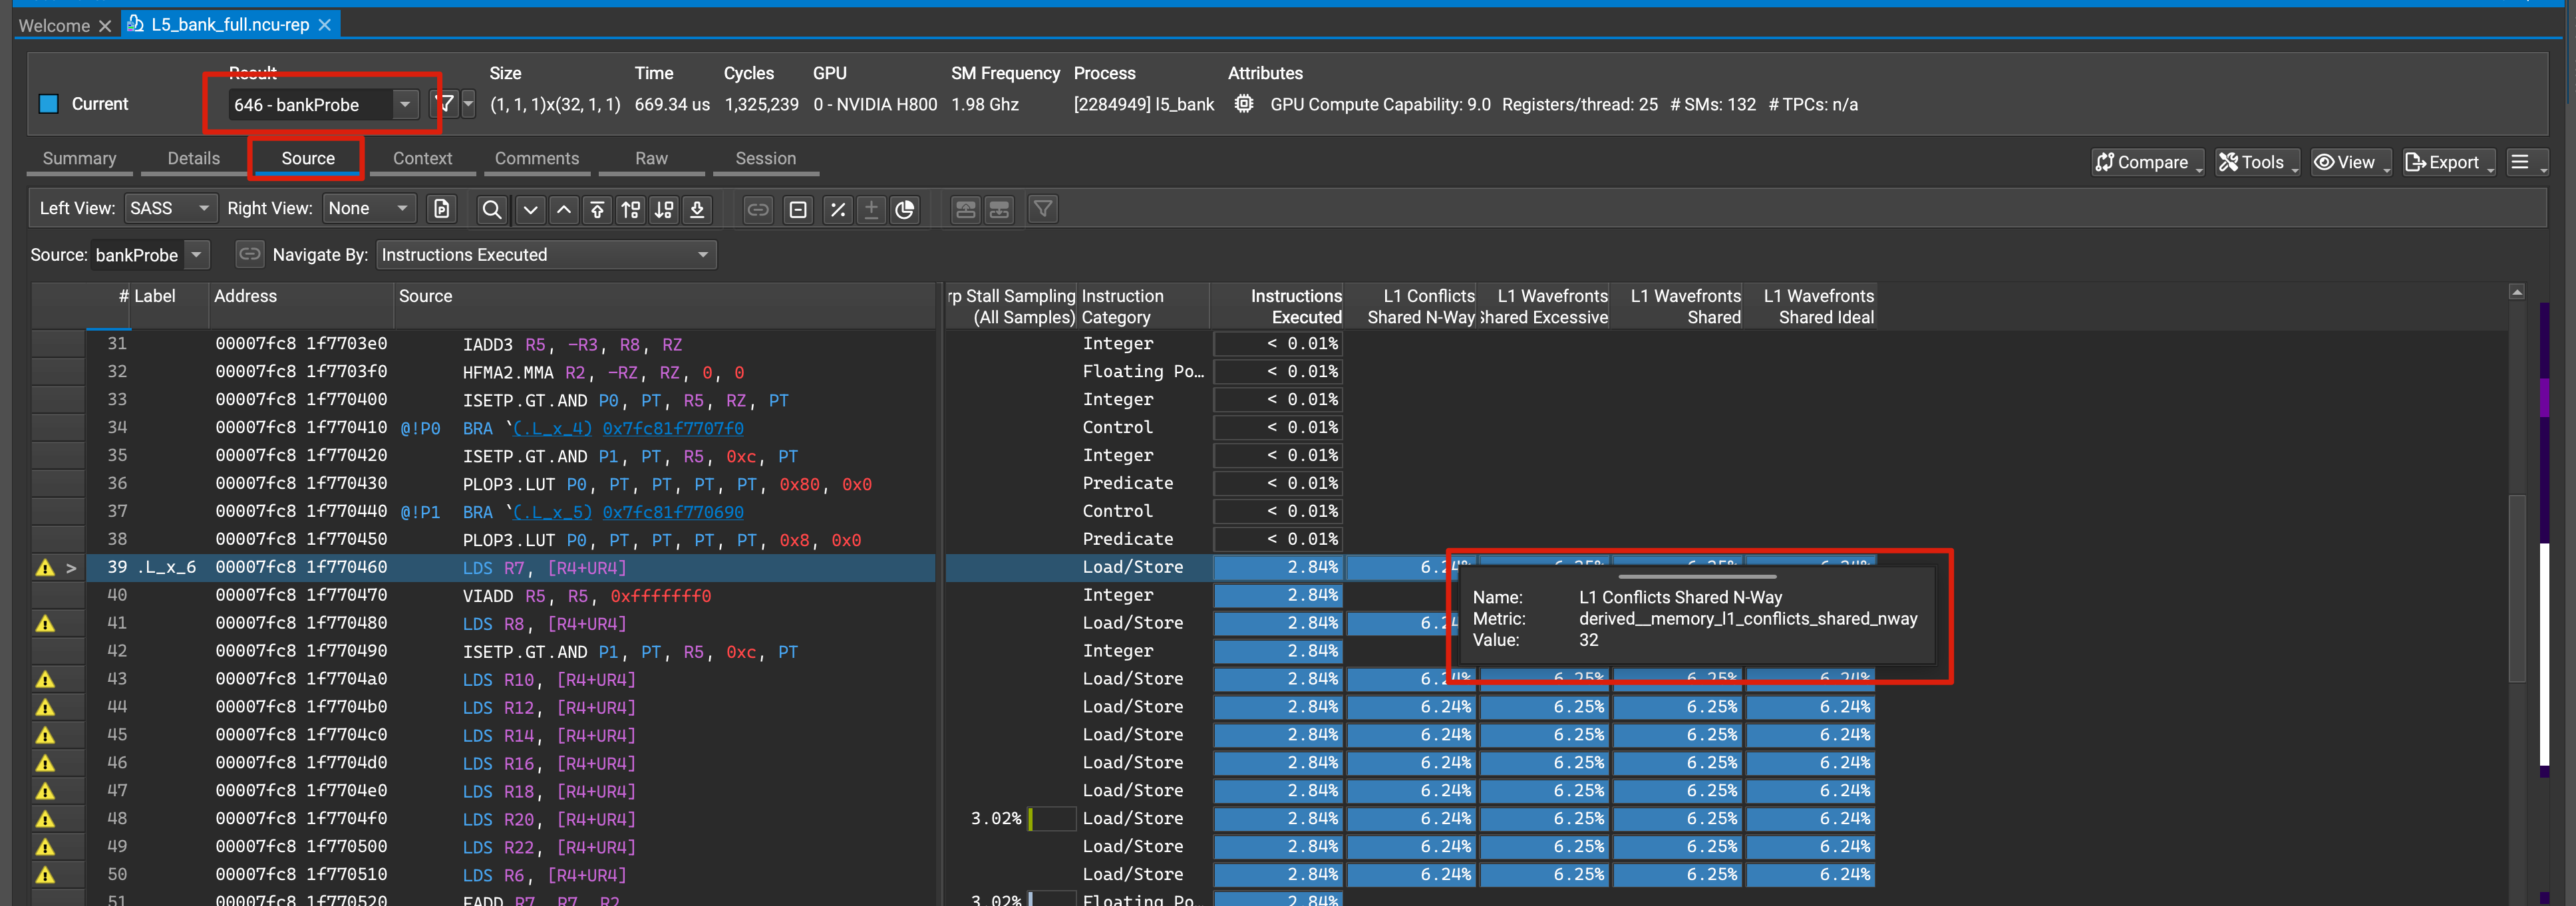
以 stride 32 为例,应该有 32 次串行执行,L1 Conflicts Shared N-Way 指标 = 32
总结
| 合并访存 | bank conflict | |
|---|---|---|
| 发生位置 | 全局内存(L1TEX → L2 → HBM) | 共享内存(片上 SRAM) |
| 硬件单元 | 32 字节 sector | 4 字节宽的 bank,共 32 个 |
| 看地址的什么 | 是否连续(落在几个 sector) | 地址 mod 32(落在哪个 bank) |
| 理想情况 | 32 个地址挤进 4 个 sector | 32 个地址散到 32 个 bank |
| 最坏情况 | 32 个 sector,一人一个 | 全挤在 1 个 bank,32 路冲突 |
| 代价 | 搬了没用的字节,浪费带宽 | 串行化,多花周期,字节不浪费 |
实验涉及到的数据采集都开源在 https://github.com/boxtsecond/ai-infra-learn/tree/main/cuda/memory-lab-reports,感兴趣的可以使用 Nsight Compute 自行查看实验结果