内存结构
| 内存类型 | 作用域 | 生命周期 | 物理位置 | 延迟 | 说明 |
|---|---|---|---|---|---|
| 寄存器 Register | 单个线程 | 线程 | SM 内的 Register File | ~1 | 存放 kernel 里的局部变量,片上。由编译器自动分配,代码中无显式语法。 |
| 本地内存 Local | 单个线程 | 线程 | 显存 | ~400-600 | 在寄存器放不下时,会放在这里 |
| Warp 内寄存器直传 | 同一 Warp 内的 32 线程 | 指令级 | - | ~1 | 严格说不是一种内存,而是 __shfl_sync 等指令在 Register File 上的交叉互连,允许一条 lane 读取另一条 lane 的寄存器。 |
| 共享内存 Shared | 同一 block | block | 与 L1 数据缓存共用同一块 SRAM | ~20–30 | 用 __shared__ 显式声明,由程序自己管理。 |
| 分布式共享内存 DSMEM | 同一 cluster | cluster | 不是一种新的物理存储介质,而是共享内存的一种扩展寻址方式 | 介于共享内存与全局内存之间 | 簇内各 block 可直接对其它 SM 的共享内存做 load / store / atomic。 经 GPC 内的 SM-to-SM 互联网络,比绕全局内存交换数据快约 7 倍。 |
| 全局内存 Global | 全体线程 + 主机端 | 由 API 决定 | 显存 | ~400–600 | cudaMalloc 分配的地方。 访问统一经过全卡共享的 L2 缓存。不随 kernel 结束而释放,主机端也可读写。 |
| L1 数据缓存 | 本 SM | 硬件自动 | 与共享内存共用同一块 SRAM | ~20–30 | 访问全局内存时由硬件自动缓存,代码中无对应语法。 |
| L2 缓存 | 全卡所有 SM | 硬件自动 | GPU 内的 L2 Cache | ~200 | 全卡所有 SM 共享。是跨 SM 数据复用的唯一硬件通路 |
| 常量内存 Constant | 全体线程(只读) | 由 API 决定 | 显存 | ~400–600 | __constant__ 声明,数据在显存。经每 SM 8 KB 专用缓存读取,总量上限 64 KB。一个 warp 读同一地址时可广播,此时效率最高。 读不同地址时会按地址数拆成多次请求,吞吐成比例下降。 |
| 纹理 / 表面内存 | 全体线程(通常只读) | 由 API 决定 | 显存 | ~400–600 | 经专用的纹理缓存读取。带硬件插值、归一化坐标和边界处理,为二维空间局部性优化。 源自图形渲染,通用计算中较少使用。 |
代码中的内存
// ① 全局作用域:常量内存(显存 + 每 SM 8 KB 常量缓存)
__constant__ float coef[64];

__global__ void myKernel(float* in, float* out, int n) // ② 形参:寄存器
{
    // ③ 普通局部变量:寄存器
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    float sum = 0.0f;

    // ④ 小的、下标可静态确定的数组:寄存器
    float acc[4] = {0,0,0,0};

    // ⑤ 下标运行时才知道 → 编译器放进本地内存(显存!)
    float buf[64];
    buf[idx % 64] = sum;

    // ⑥ 共享内存:片上 SRAM,本 block 独占一份
    __shared__ float tile[256];
    tile[threadIdx.x] = in[idx];   // 全局 → 共享
    __syncthreads();

    // ⑦ 指针指向的数据:全局内存(显存),指针本身在寄存器
    out[idx] = tile[threadIdx.x] * coef[0];
}
| 代码序号 | 代码概念 | 物理位置 | 说明 |
|---|---|---|---|
| ① | 常量内存 | 显存 | 经每 SM 8KB 的常量缓存读取,全 grid 只读可见。 warp 内读同一地址时广播,最快;读不同地址会拆成多次请求。 |
| ② | 形参 | 常量内存 → 寄存器 | 线程私有,经常量内存传递,kernel 执行时由编译器加载进寄存器使用 |
| ③ | 局部变量 | 寄存器 | 线程私有,由编译器自动分配 |
| ④ | 小数组(常量下标) | 寄存器/显存 | 下标能静态确定到具体某个元素时,编译器把每个元素当成独立的标量变量,各自分配寄存器(按数据宽度占 1 个或多个 32-bit 寄存器) |
| ⑤ | 数组(动态下标) | 本地内存(显存) | 满足以下任一种情景,数据会保存在本地内存 1. 下标非常量,编译器无法静态确定 2. 数组太大,编译器判断放寄存器不划算 3. kernel 整体寄存器压力过高,发生溢出(spilling),每线程最多 255 个 32-bit 寄存器 |
| ⑥ | 共享内存 | SM 内的 SRAM | 与 L1 共用同一块 SRAM,本 block 独占一份,其它 block 看不到 |
| ⑦ | 全局内存 | 显存 | 经 L1 → L2 → HBM3 访问 指针变量本身在寄存器,它指向的数据在显存 |
共享内存
共享内存的物理结构
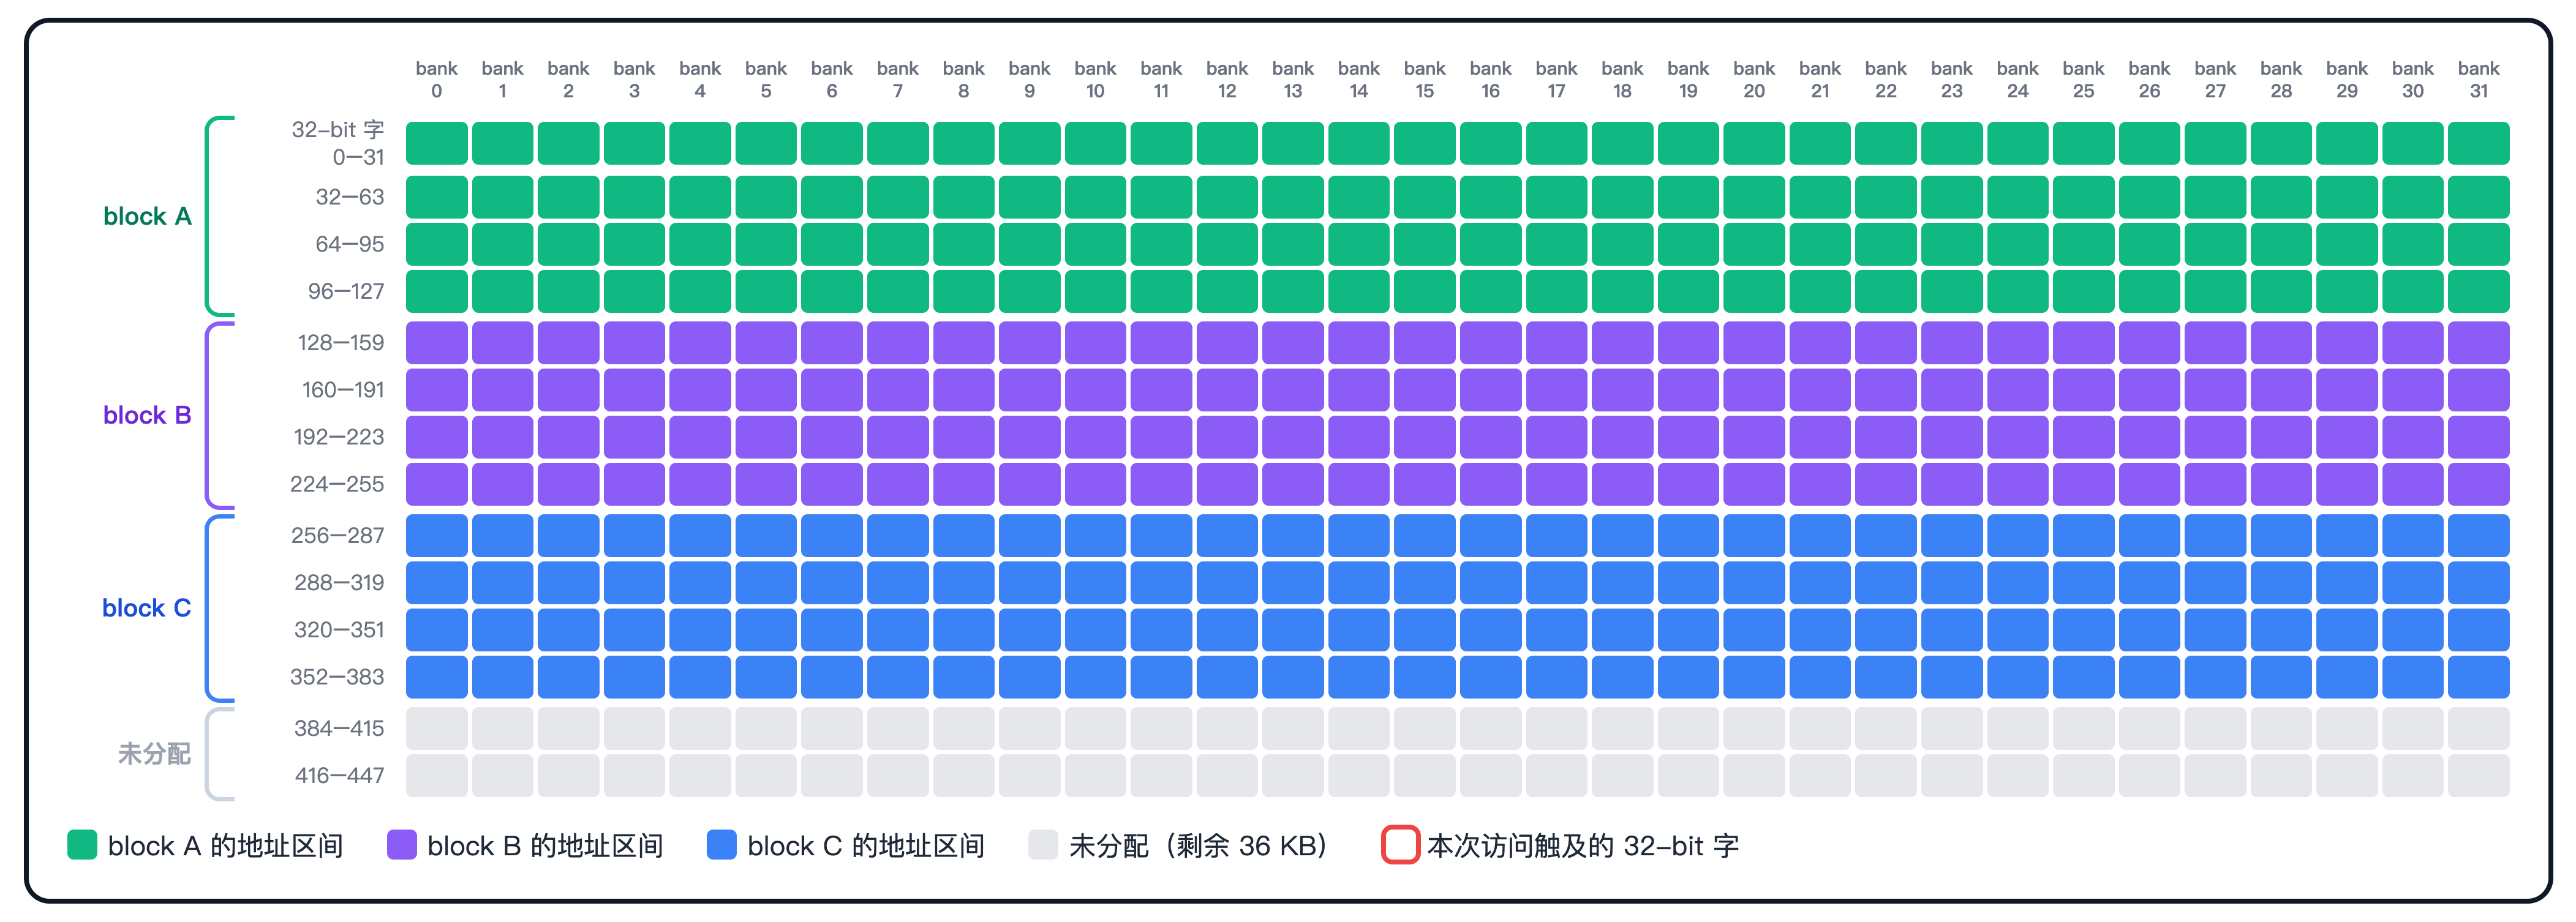
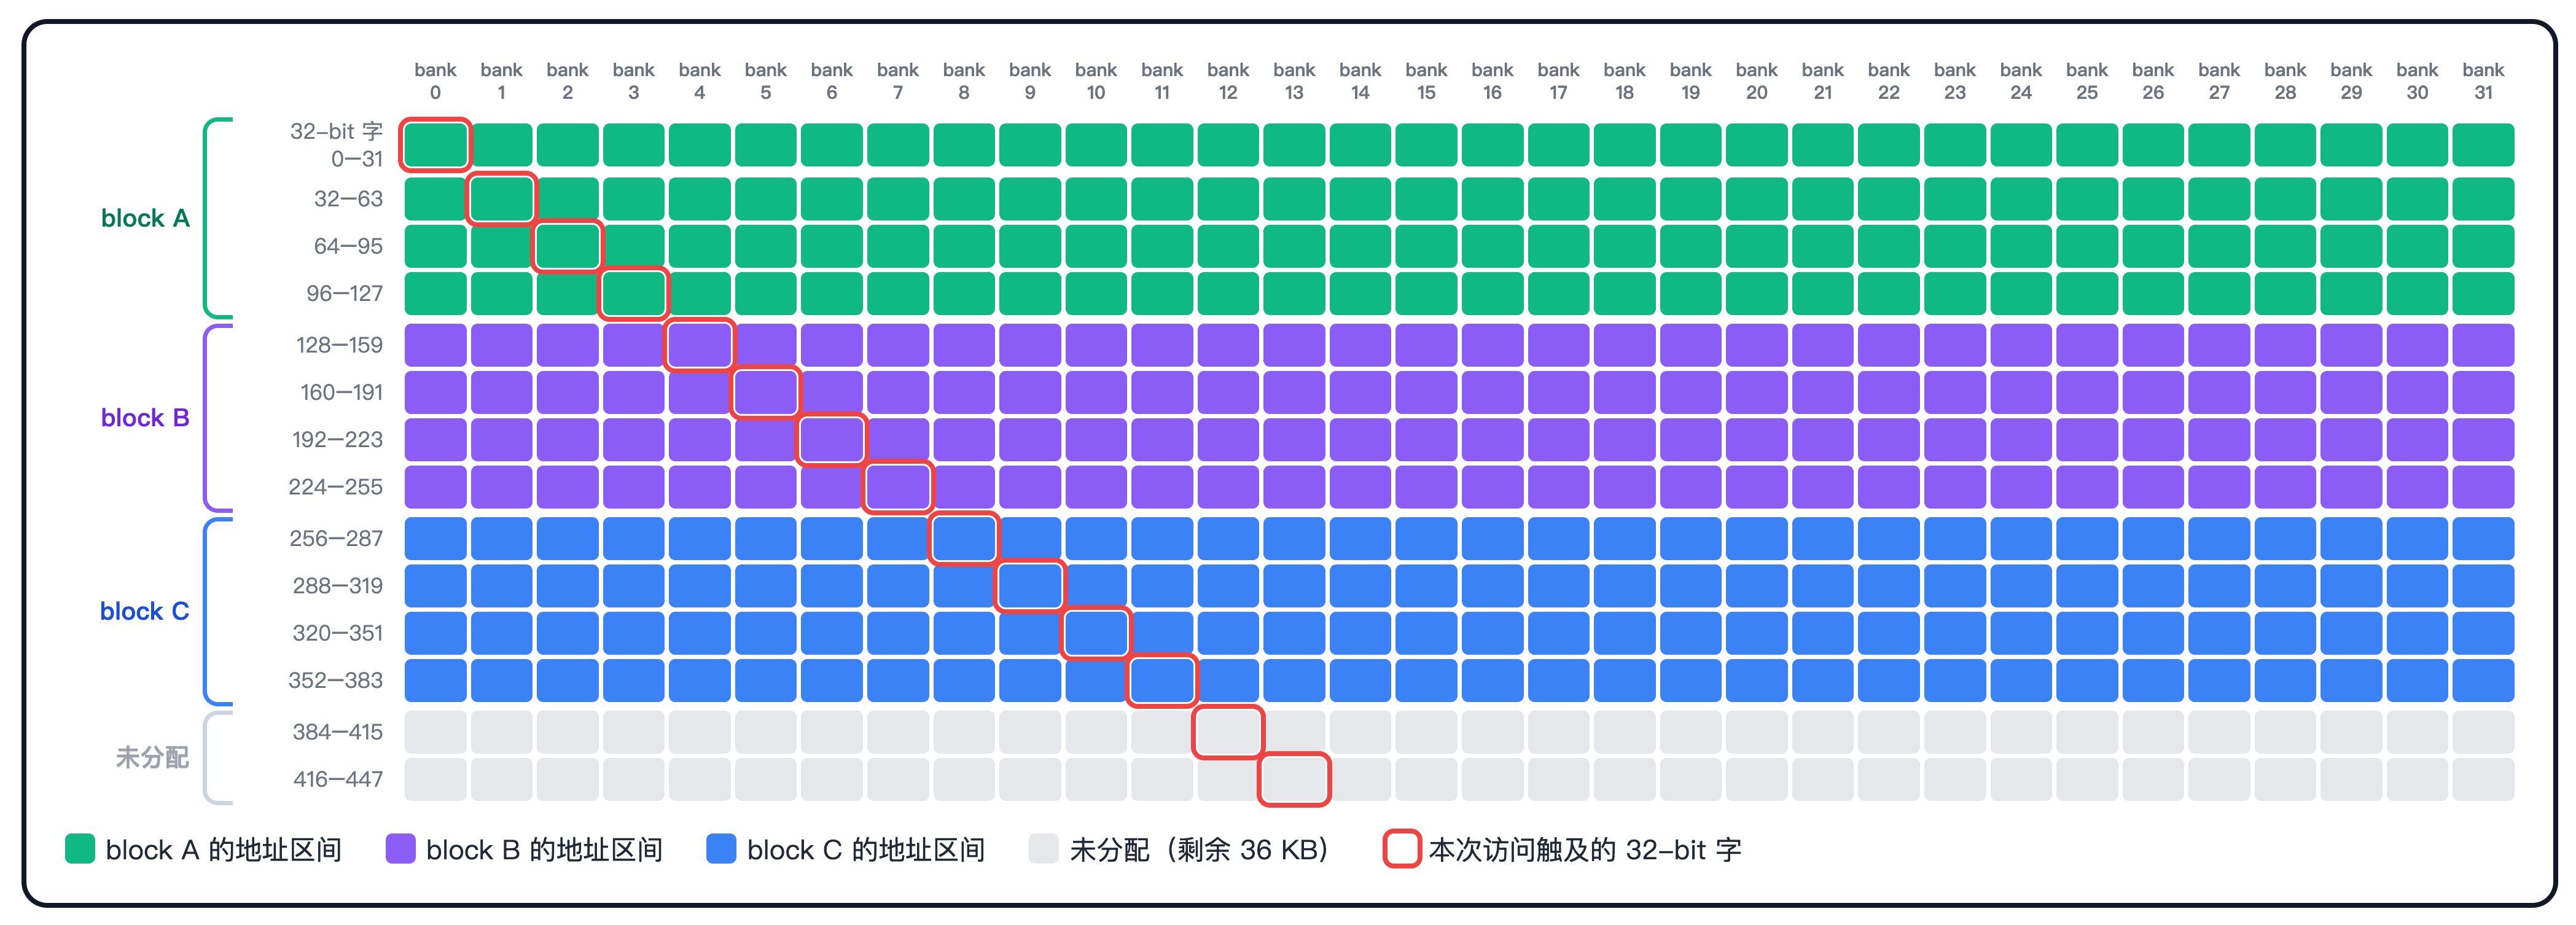
共享内存被分成大小相等、可同时访问的模块,称为 bank。bank 是整块共享内存的物理结构,图中的每一列对应一个 bank。整个共享内存只有 32 个 bank,增大共享内存只会让每个 bank 更深,但 bank 的数量不变。
地址按 32-bit 字(4 字节)映射到 bank,bank = 字地址 % 32,即图中的一个个小方格。第 0~31 个 32-bit 字横跨所有的 bank,第 32 个绕回到 bank 0。
一个 bank 在一个时钟周期里,只能读出(或写入)一个 32-bit 字,因此在同一时刻一个 bank 只能服务一个地址。把连续的 32 个字分散到 32 个不同 bank,正是为了让一个 warp 的 32 个线程能同时取数,获得 32 倍带宽。
array[threadIdx.x] 这种最自然的写法自动满足这一点,注意这里的 array 数据类型需要是 int 或 float 4 字节,每个元素正好占用一个字,32 个线程正好铺满 32 个 bank。反之,如果多个线程的不同地址落在同一 bank,就会发生 bank conflict,硬件将拆成多次串行。
共享内存的 Bank Conflict
若一次请求的 n 个地址落在 n 个不同的 bank 上,就能同时完成,带宽是单个模块的 n 倍。若两个地址落在同一个 bank,则发生 bank conflict,硬件必须把请求拆成多次串行完成, 吞吐按拆分次数成比例下降。
有一个例外,当多个线程读同一个 32-bit 字时,一次读取后广播给所有线程,不会发生 bank conflict。而当多个线程写同一个 32-bit 字时,只有其中一个线程的写会生效,但具体是哪个线程不确定。因此,如果多个线程要写同一个地址且在意结果,必须用原子操作或者重新设计数据布局。
综上,bank conflict 是同一个 warp 内部的问题,与 SM 上驻留了几个 block 无关。
无 bank conflict
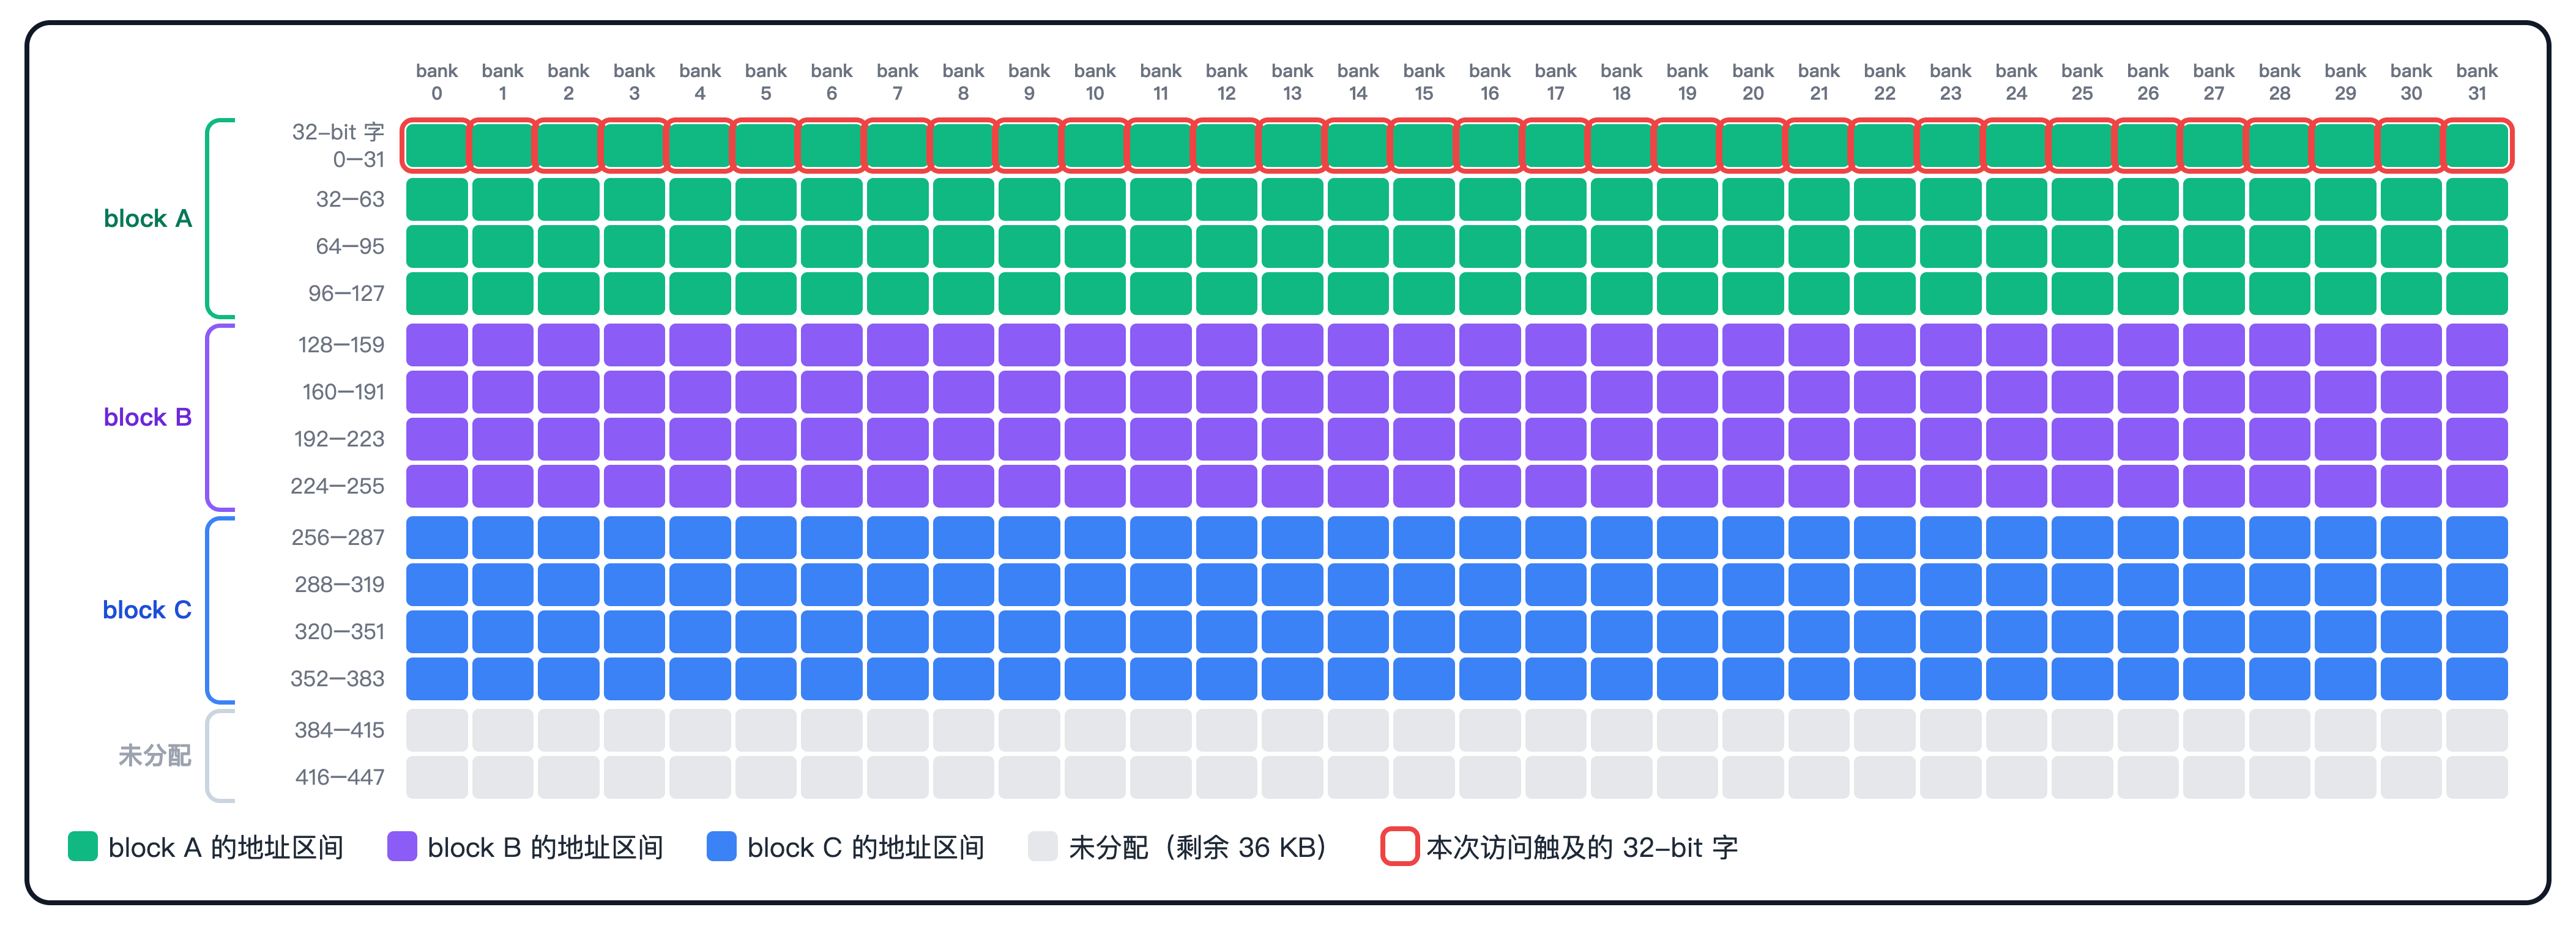
array[threadIdx.x]:32 个线程访问连续的 32 个 32-bit 字。同一时刻,32 个 bank 各被访问一次,一次即可完成,是最理想的访问模式。
2 路冲突
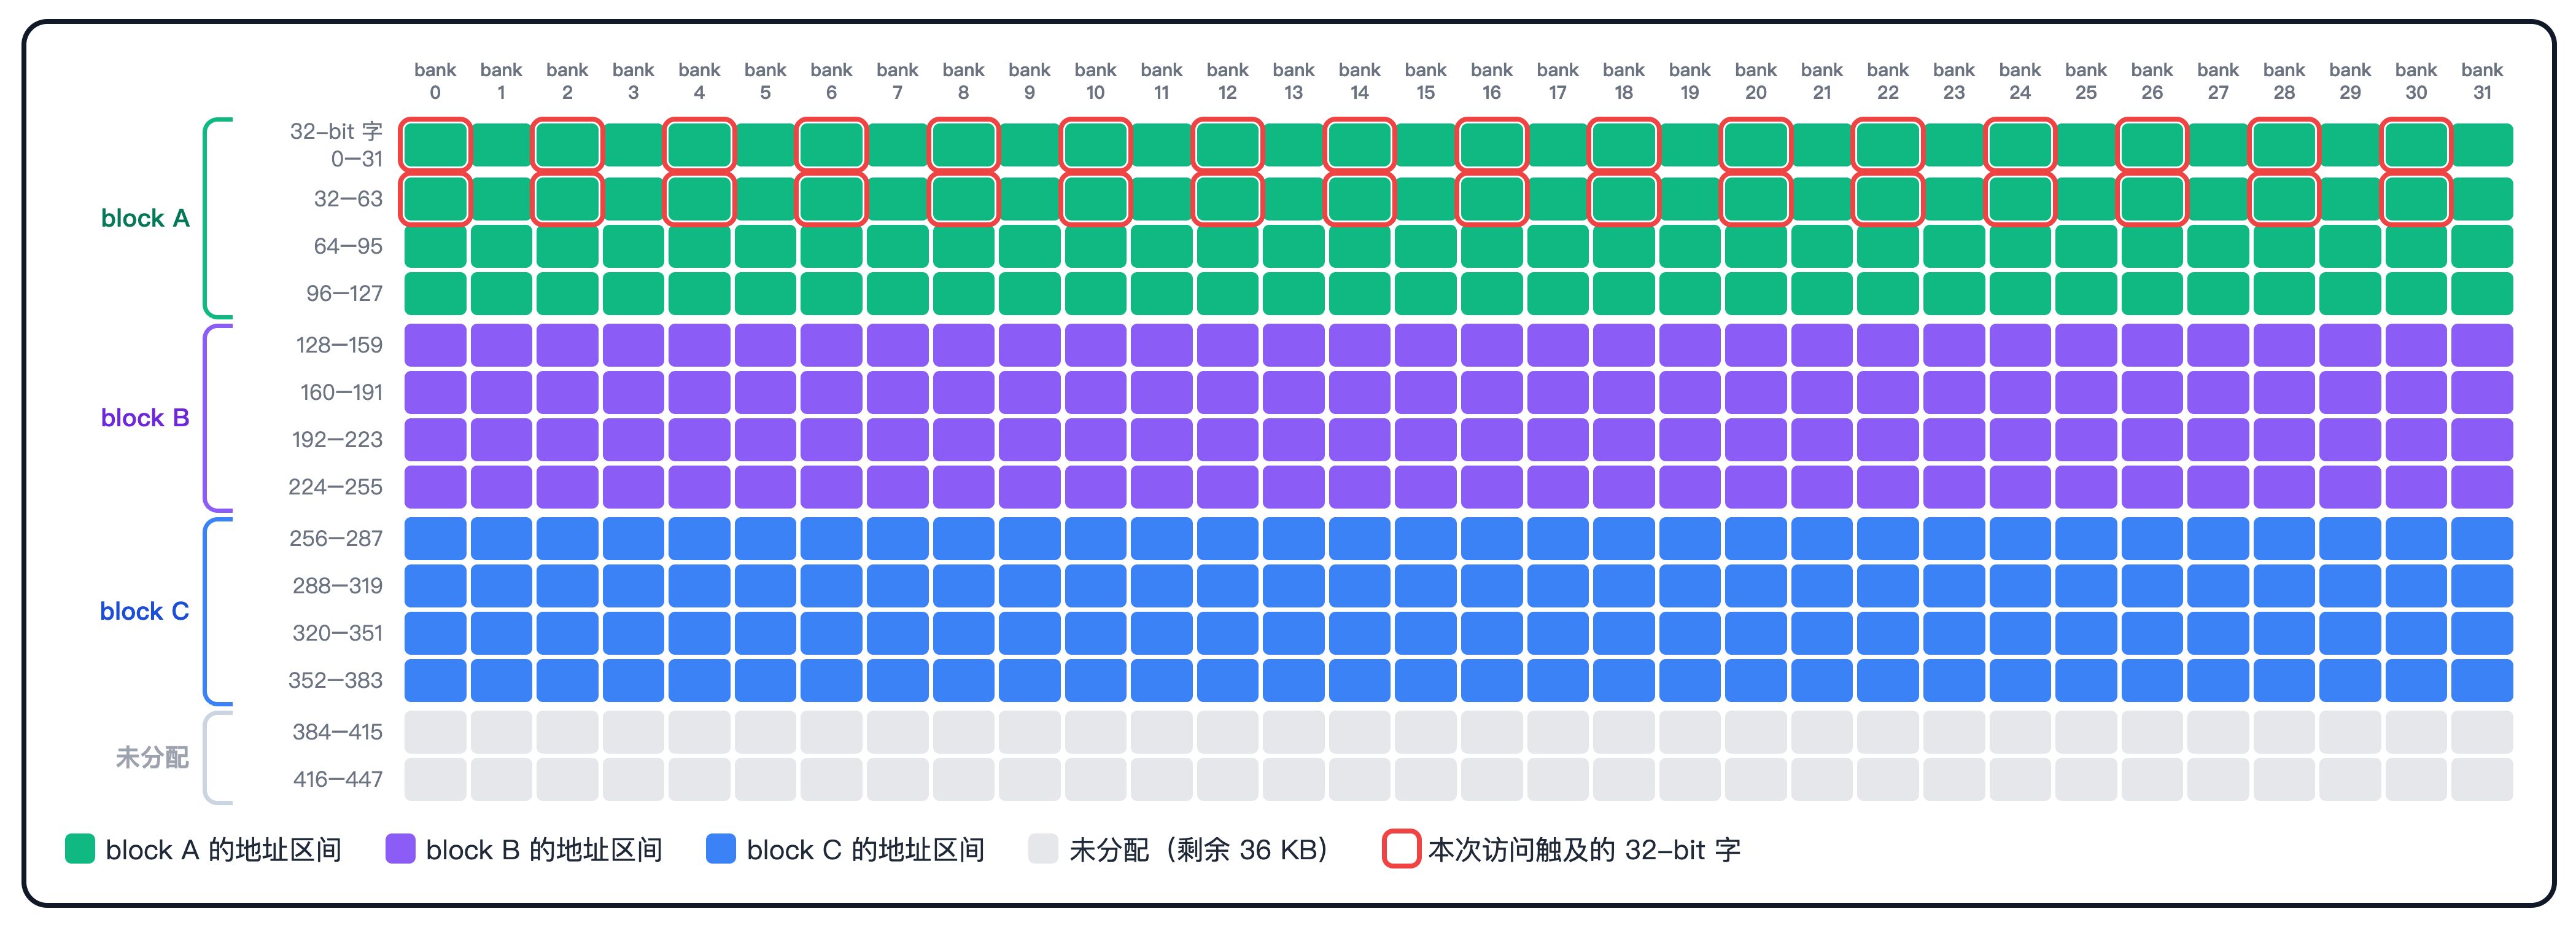
array[threadIdx.x * 2]:每隔一个 32-bit 字访问。线程 0 访问字 0,在 bank 0;线程 16 访问字 32,也是 bank 0,发生 2 路冲突。bank 的访问拆成 2 次串行,吞吐减半,一半的 bank 全程闲置。
32 路冲突
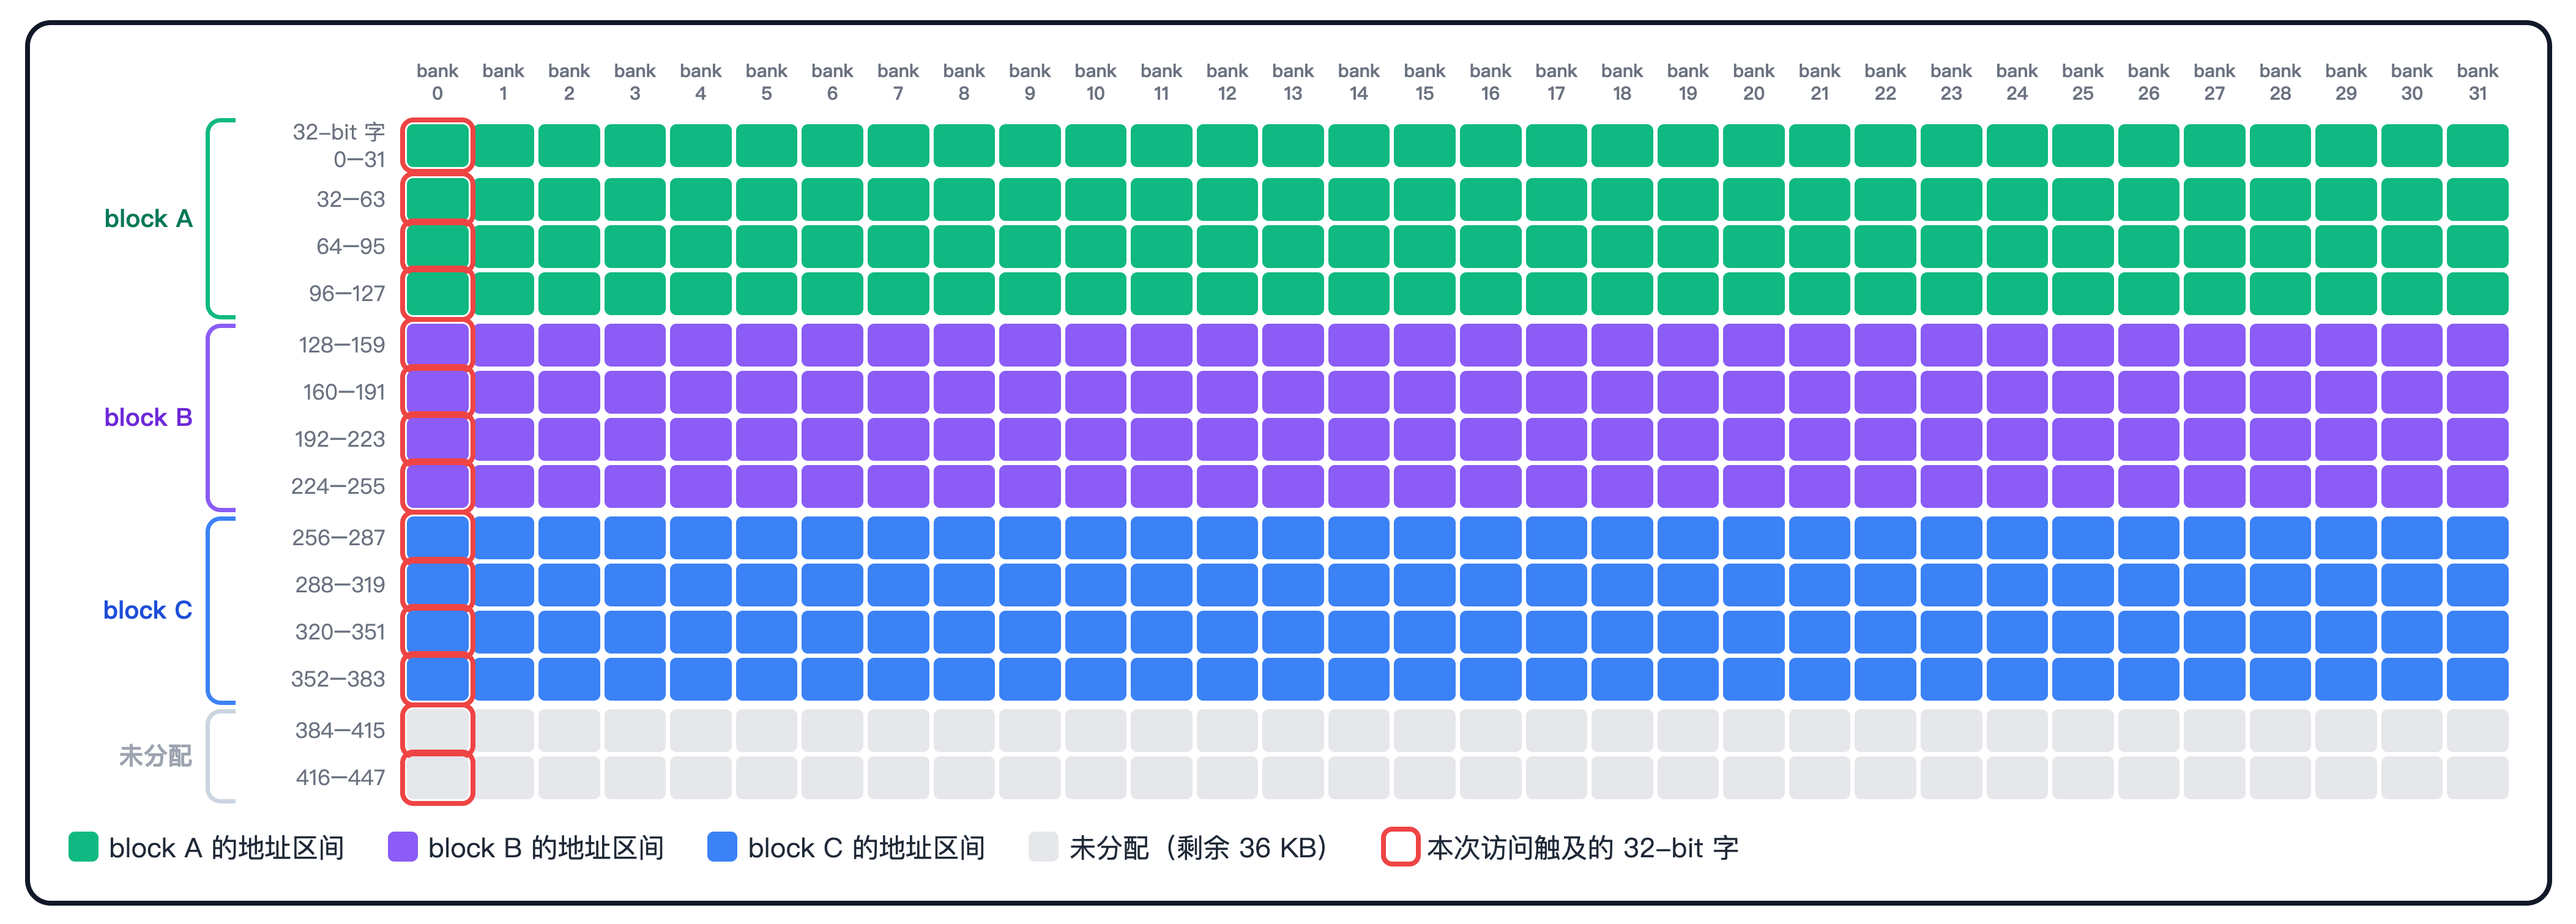
array[threadIdx.x * 32]:每隔 32 个 32-bit 字访问。所有 32 个线程都撞在 bank 0 上,而地址各不相同,发生 32 路冲突。bank 的访问拆成 32 次串行,吞吐慢 32 倍,这是最糟的情况。
面对这种场景,最常见的优化手段为 padding。把 array[32][32] 改成 array[32][33],每行错开一个 32-bit 字,列访问就自然分散到不同 bank。于是按列访问 array[threadIdx.x][k] 时(k 固定),跨行取同一列,如下图所示。
冲突路数计算
每元素占用字节数 < 4
char、short 这种数据类型,多个线程会落在同一个 32-bit 字内,触发的是广播而不是冲突。
- 字节步长 = 下标步长 × 每元素占的字节数
- 字节步长 < 4,无冲突;字节步长 ≥ 4,冲突路数 = gcd(字节步长 / 4, 32)
每元素占用字节数 ≥ 4
-
wavefront = ceil(32 × 每元素占的字节数 / 128)
- wavefront:共享内存单元把一条访存指令拆成的一次内部处理批次
- 一个 warp 有 32 个线程
- 一个 bank 返回 4 字节,32 个 bank,每周期最多能返回 128 字节
- ceil(这条指令一共要搬多少字节 / 每周期能搬多少字节)
-
每个 wavefront 内的线程数 = 32 / wavefront
- 一个 warp 的 32 个线程,被平均分到 W 个 wavefront 里,求出每个 wavefront 摊到多少个线程
-
冲突路数 = gcd(元素的下标步长, 每个 wavefront 内的线程数)
-
实际需要的总周期数:wavefront * 冲突路数
- 同一个 wavefront 内部并行,不同 wavefront 之间串行
- 每个 wavefront 拆分成 冲突路数 个周期
| 数据类型 | 每元素占的字节数 | wavefront | 每个 wavefront 内的线程数 | 下标步长 | 冲突路数 | 说明 |
|---|---|---|---|---|---|---|
| char | 1 | 1 | 32 | array[threadIdx.x] 为 1 | 1 | 1. 无冲突:多个线程落在同一个 32-bit 字内 2. 广播:落在同一个 bank 的同一个字,一次读出即可满足 |
| char | 1 | 1 | 32 | array[threadIdx.x * 3] 为 3 | 1 | 字节步长 3 < 4,相邻线程常落在同一个字里,广播,无冲突 |
| short | 2 | 1 | 32 | array[threadIdx.x] 为 1 | 1 | 同上 |
| short | 2 | 1 | 32 | array[threadIdx.x * 3] 为 3 | 1 | 同上 |
| float | 4 | 1 | 32 | array[threadIdx.x] 为 1 | 1 | 无冲突 |
| float | 4 | 1 | 32 | array[threadIdx.x * 2] 为 2 | 2 | 2 路冲突,吞吐减半 |
| double | 8 | 2 | 16 | array[threadIdx.x] 为 1 | 1 | 无冲突。拆 2 个 wavefront 是 128 字节 / 周期返回带宽所致,不是 bank conflict |
| double | 8 | 2 | 16 | array[threadIdx.x * 2] 为 2 | 2 | 2 路冲突,吞吐减半 |
| float4 | 16 | 4 | 8 | array[threadIdx.x] 为 1 | 1 | 无冲突。向量化访问通常是推荐做法 |
| float4 | 16 | 4 | 8 | array[threadIdx.x * 2] 为 2 | 2 | 总周期 4 × 2 = 8,其中 4 个是带宽必需,另 4 个是冲突浪费,可用 padding 消除 |
| float4 | 16 | 4 | 8 | array[threadIdx.x * 4] 为 4 | 4 | 4 路冲突,吞吐降至 1/4 |
wavefront 只随数据类型变,冲突路数只随下标步长变。数据类型本身不制造 bank conflict,宽类型带来的是 wavefront 增多,这是 128 字节 / 周期返回带宽的物理限制。真正能优化的是步长造成的冲突路数。因此任何数据类型,连续访问(步长为 1)都不会发生 bank conflict。
全局内存
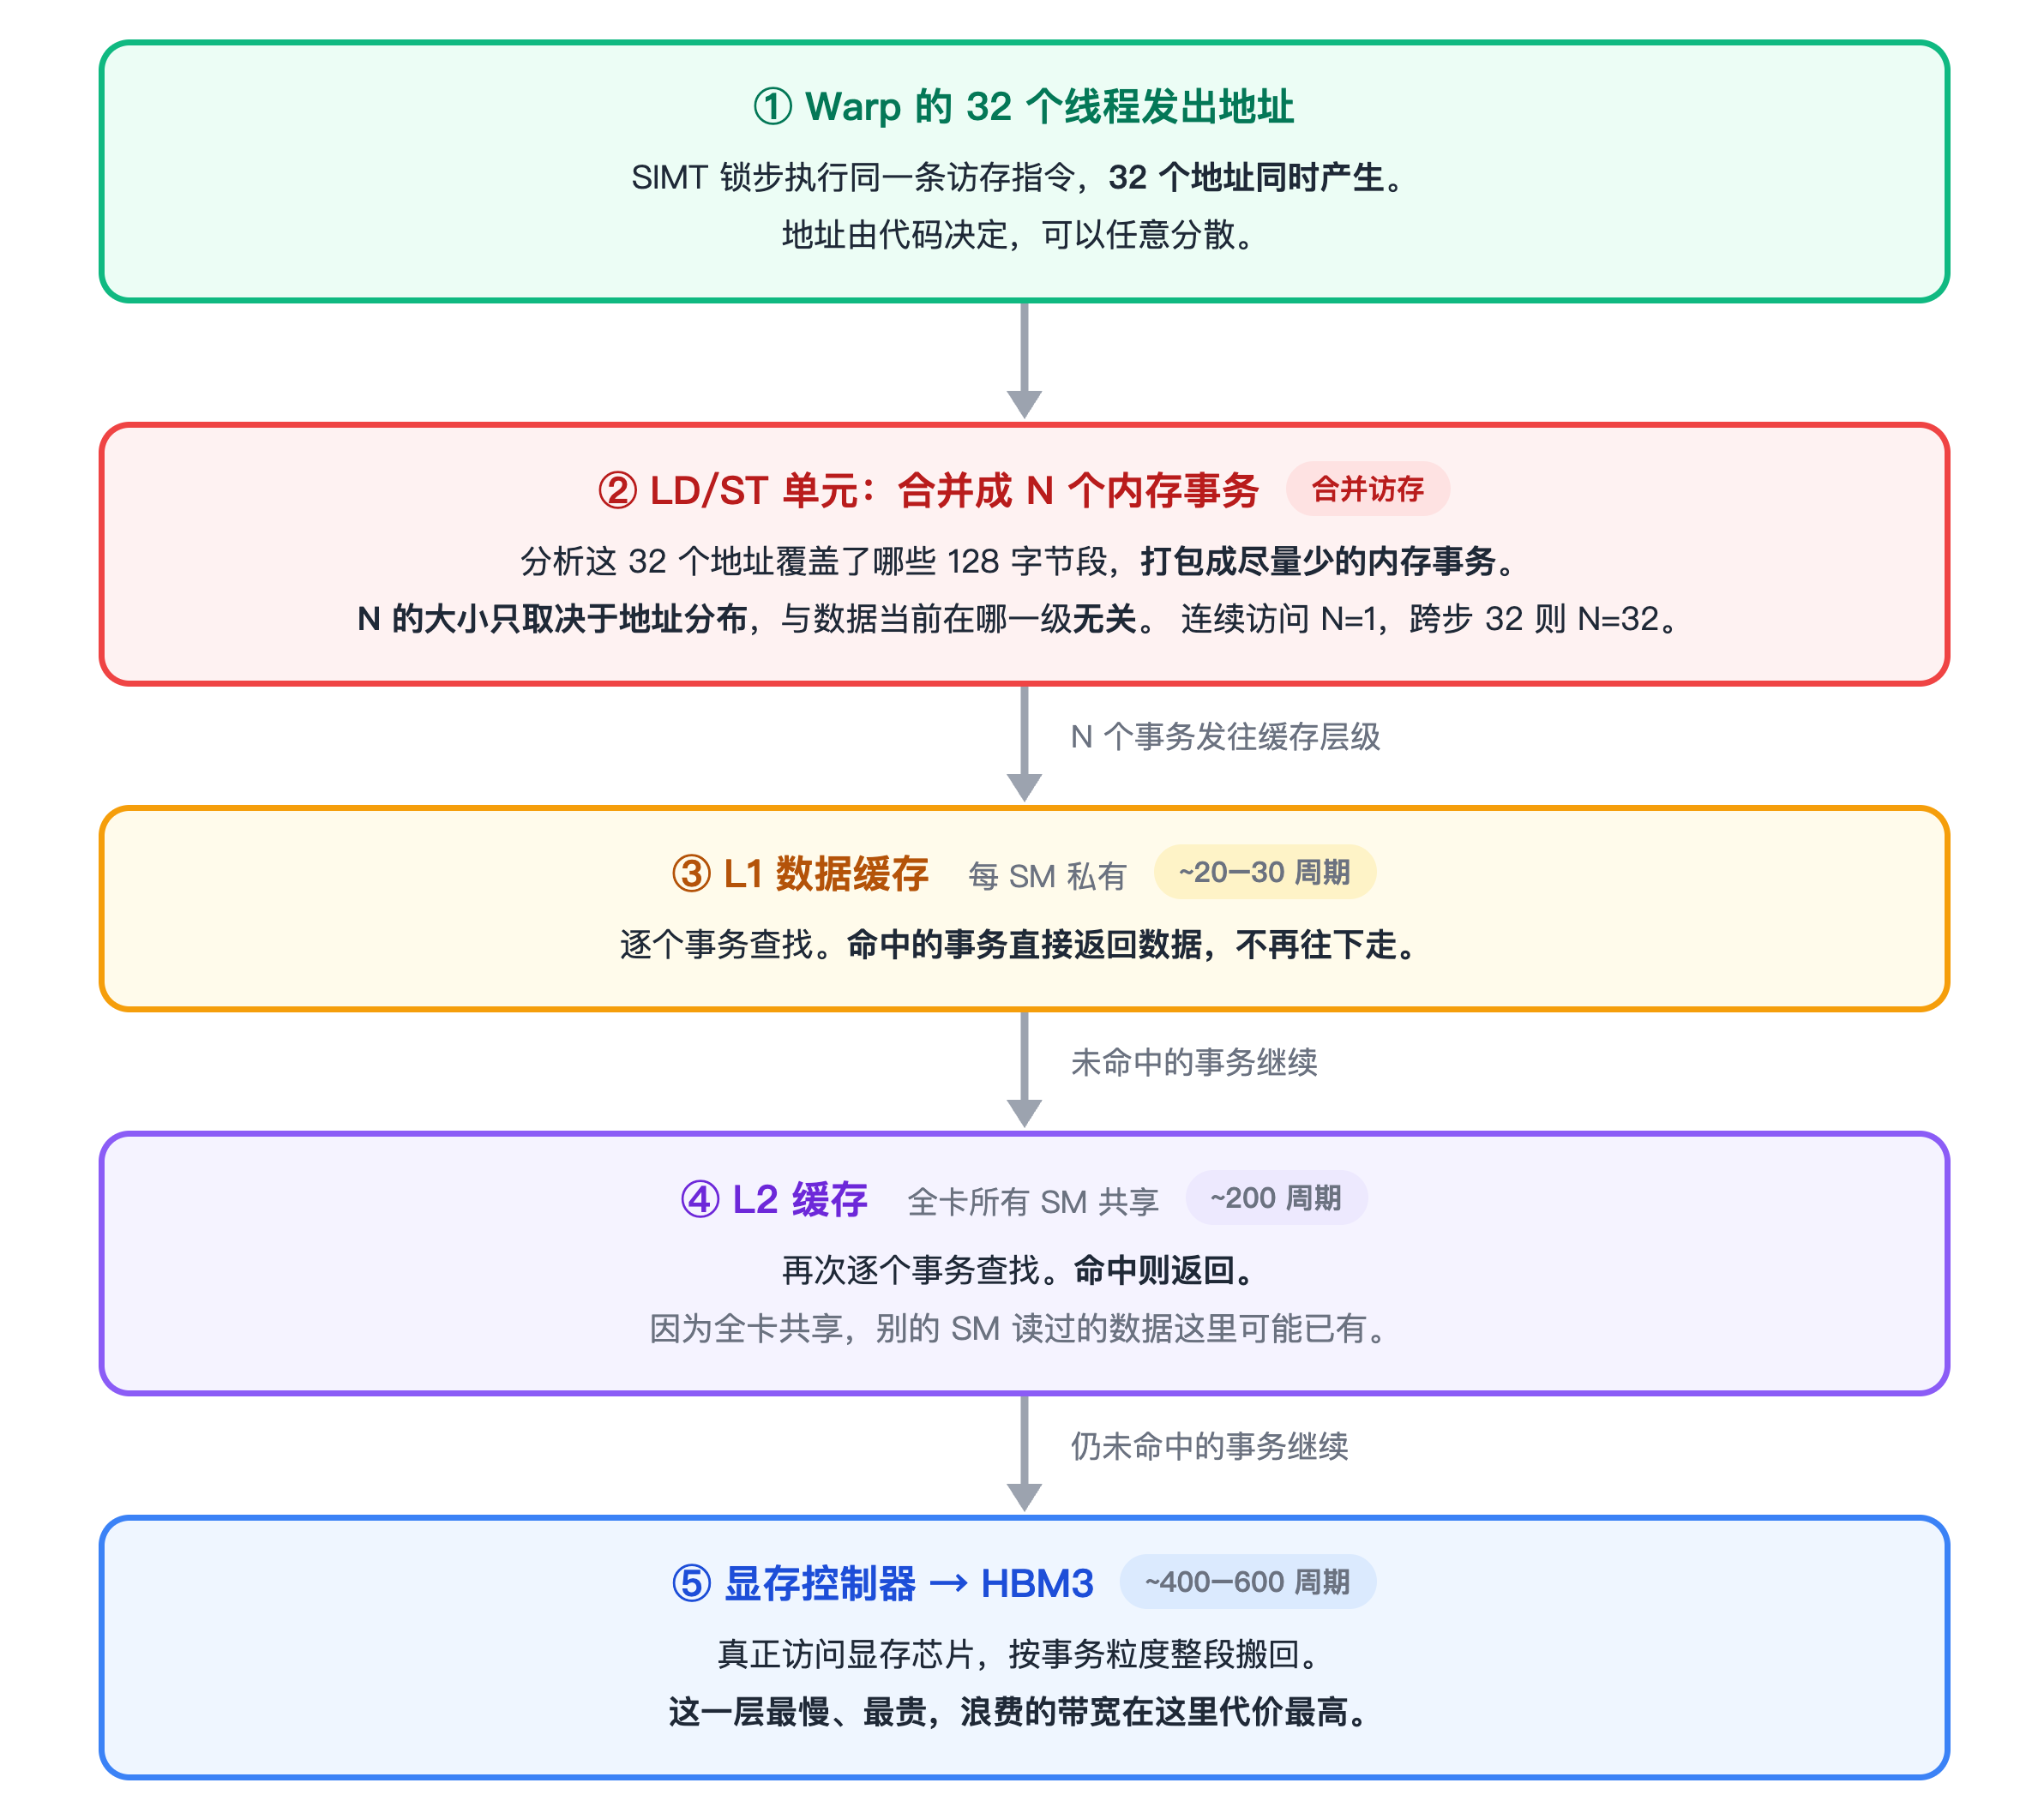
一个 warp 的 32 个线程同时访问全局内存时,LD/ST 单元会把这 32 个地址 合并成尽量少的内存事务,然后发往 L1 / L2 缓存层级,若命中则返回,未命中则最终到达显存。这个合并成尽量少的内存事务,称之为合并访存 Coalescing。
内存事务 Memory Transaction,是硬件访问显存的最小搬运单位,一次只能是 32、64 或 128 字节。即使线程只要 4 字节,硬件也必须搬回一整个事务。
事务的起始地址必须是自身大小的整倍数,比如 128 字节的事务,只能从 0、128、256 … 开始,不能从 4 或 100 开始。如果地址稍有错位,就可能多触发一个事务。
因此,内存访问优化的关键有两个,内存事务的数量和缓存命中率。
连续访问发起的内存事务
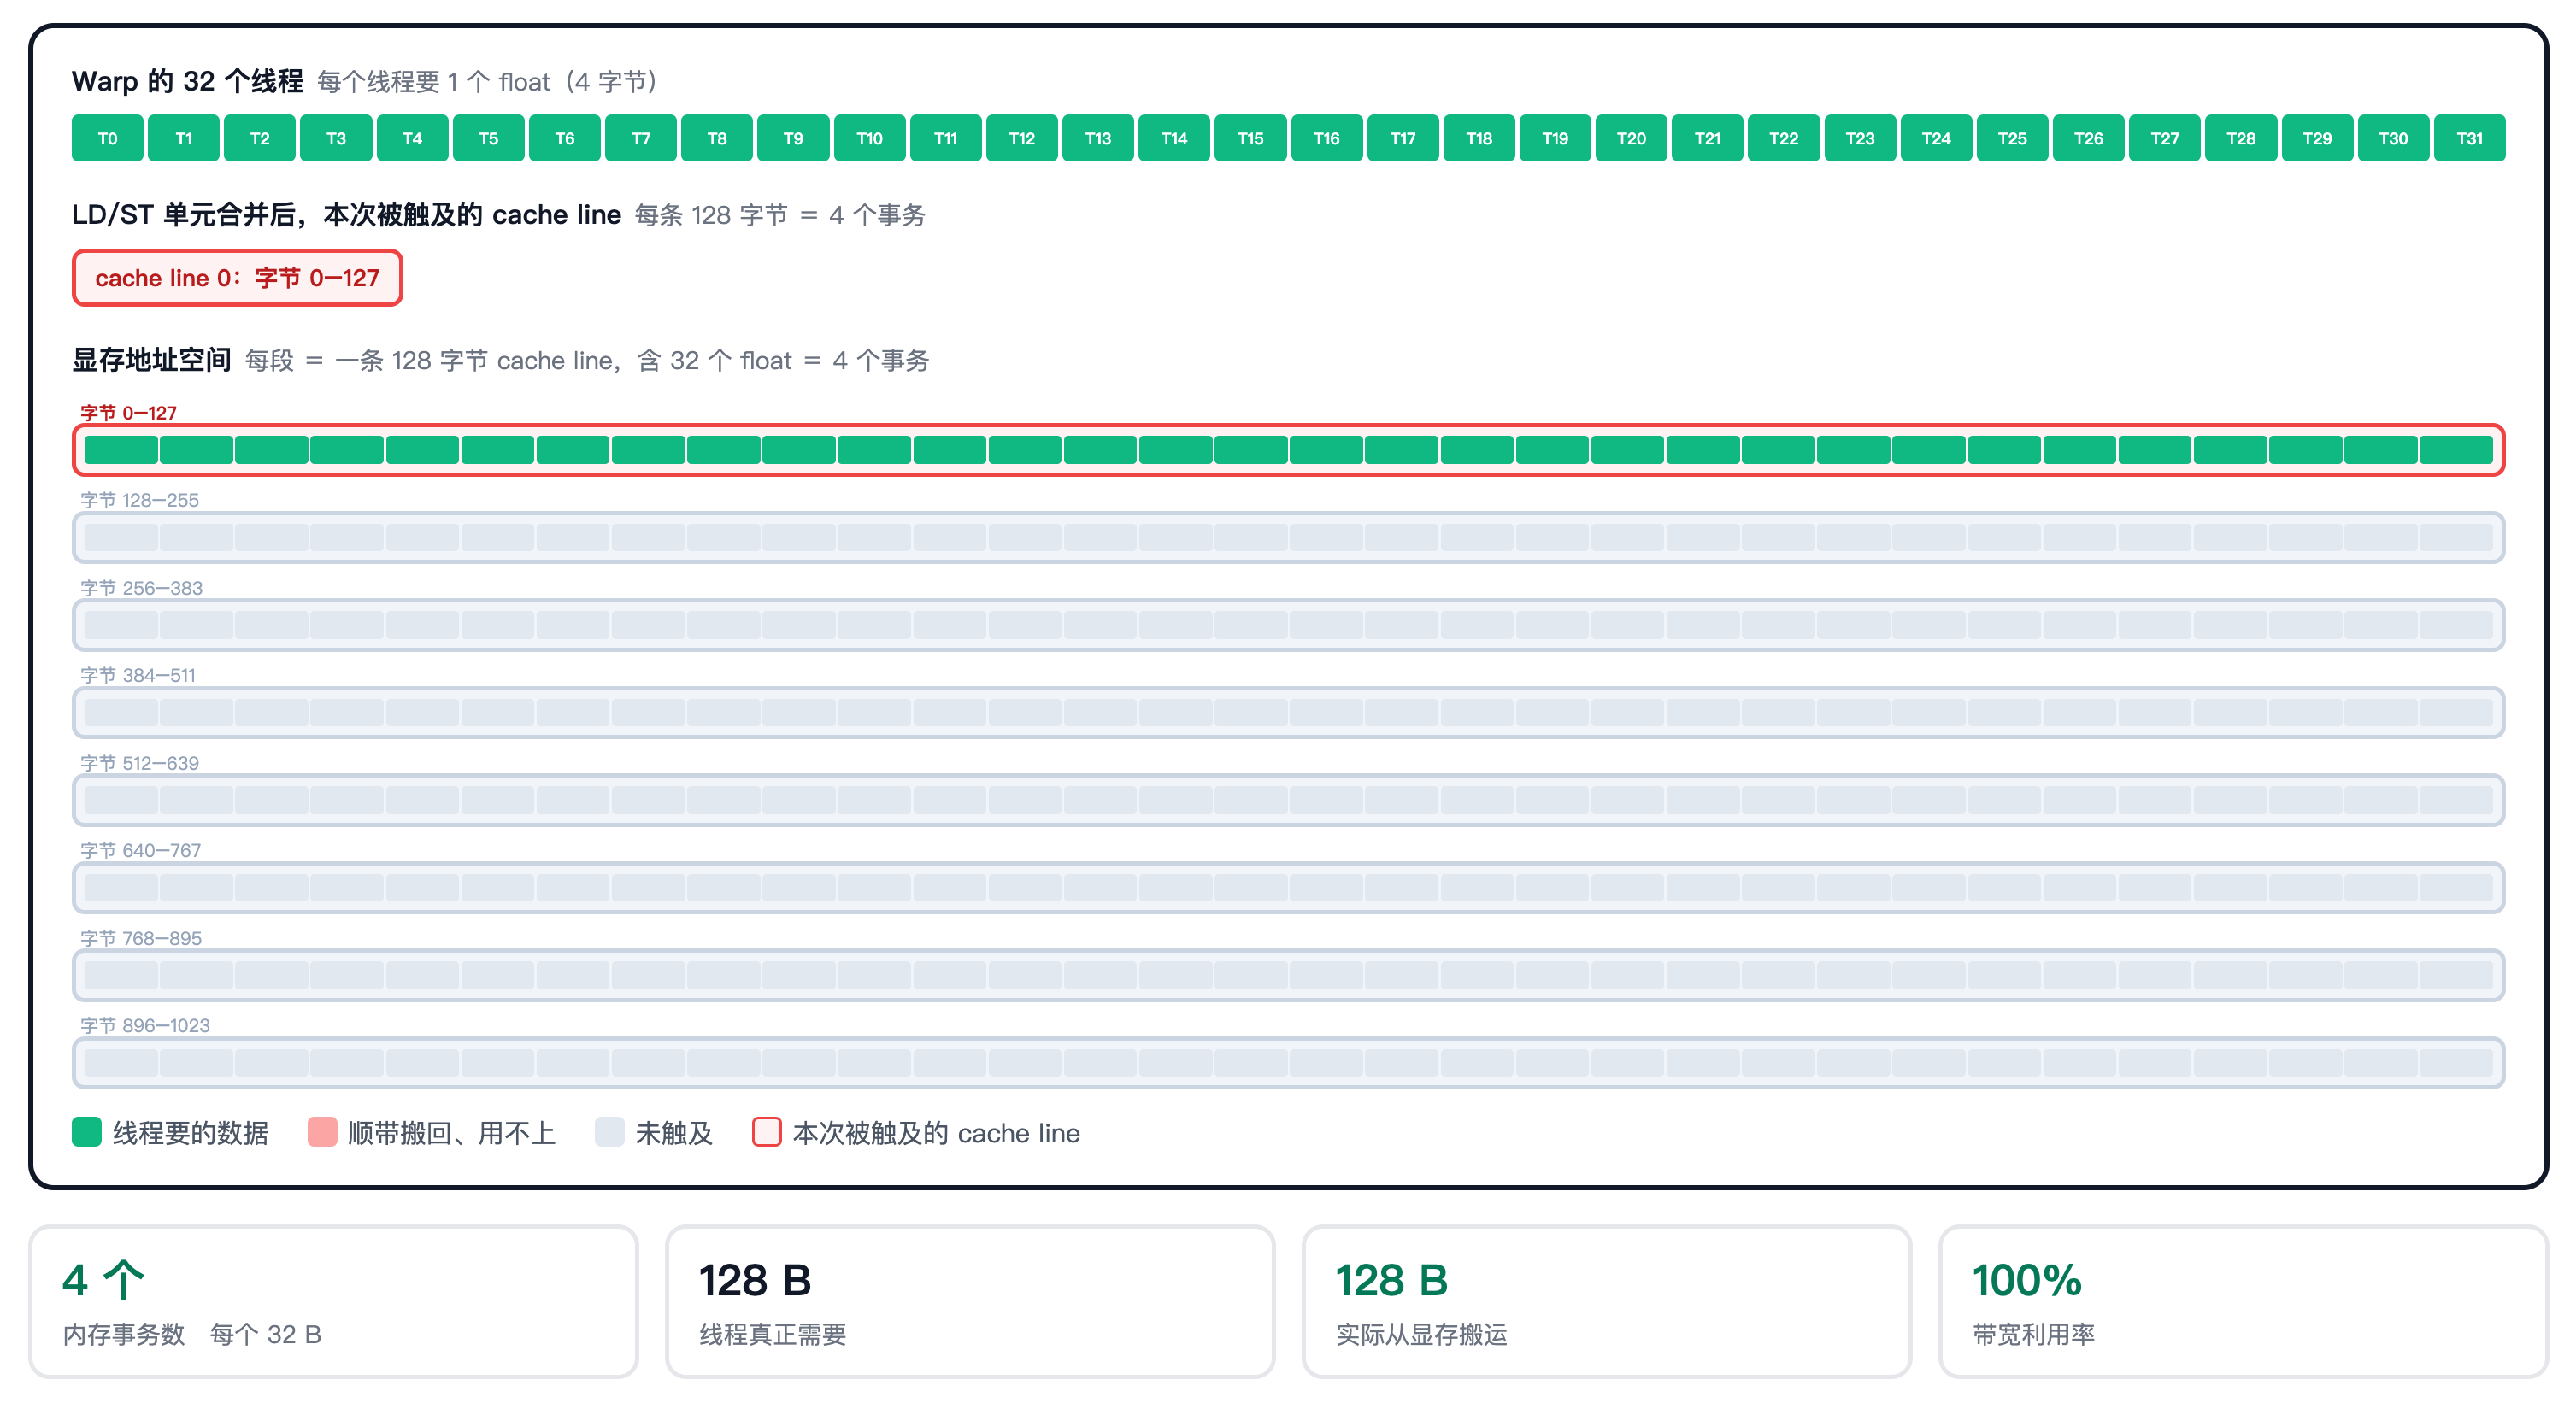
以 128 字节的内存事务为例(实际硬件会根据访问宽度与分布选用 32 / 64 / 128 字节事务),访问 global_data[i]。32 个线程访问连续的 32 个 float,合计 128 字节,恰好等于一个事务的大小且自然对齐。LD/ST 单元只需发起 1 个事务,搬回的 128 字节全部有用,是最理想的访问模式,带宽利用率 100%。
跨步访问发起的内存事务
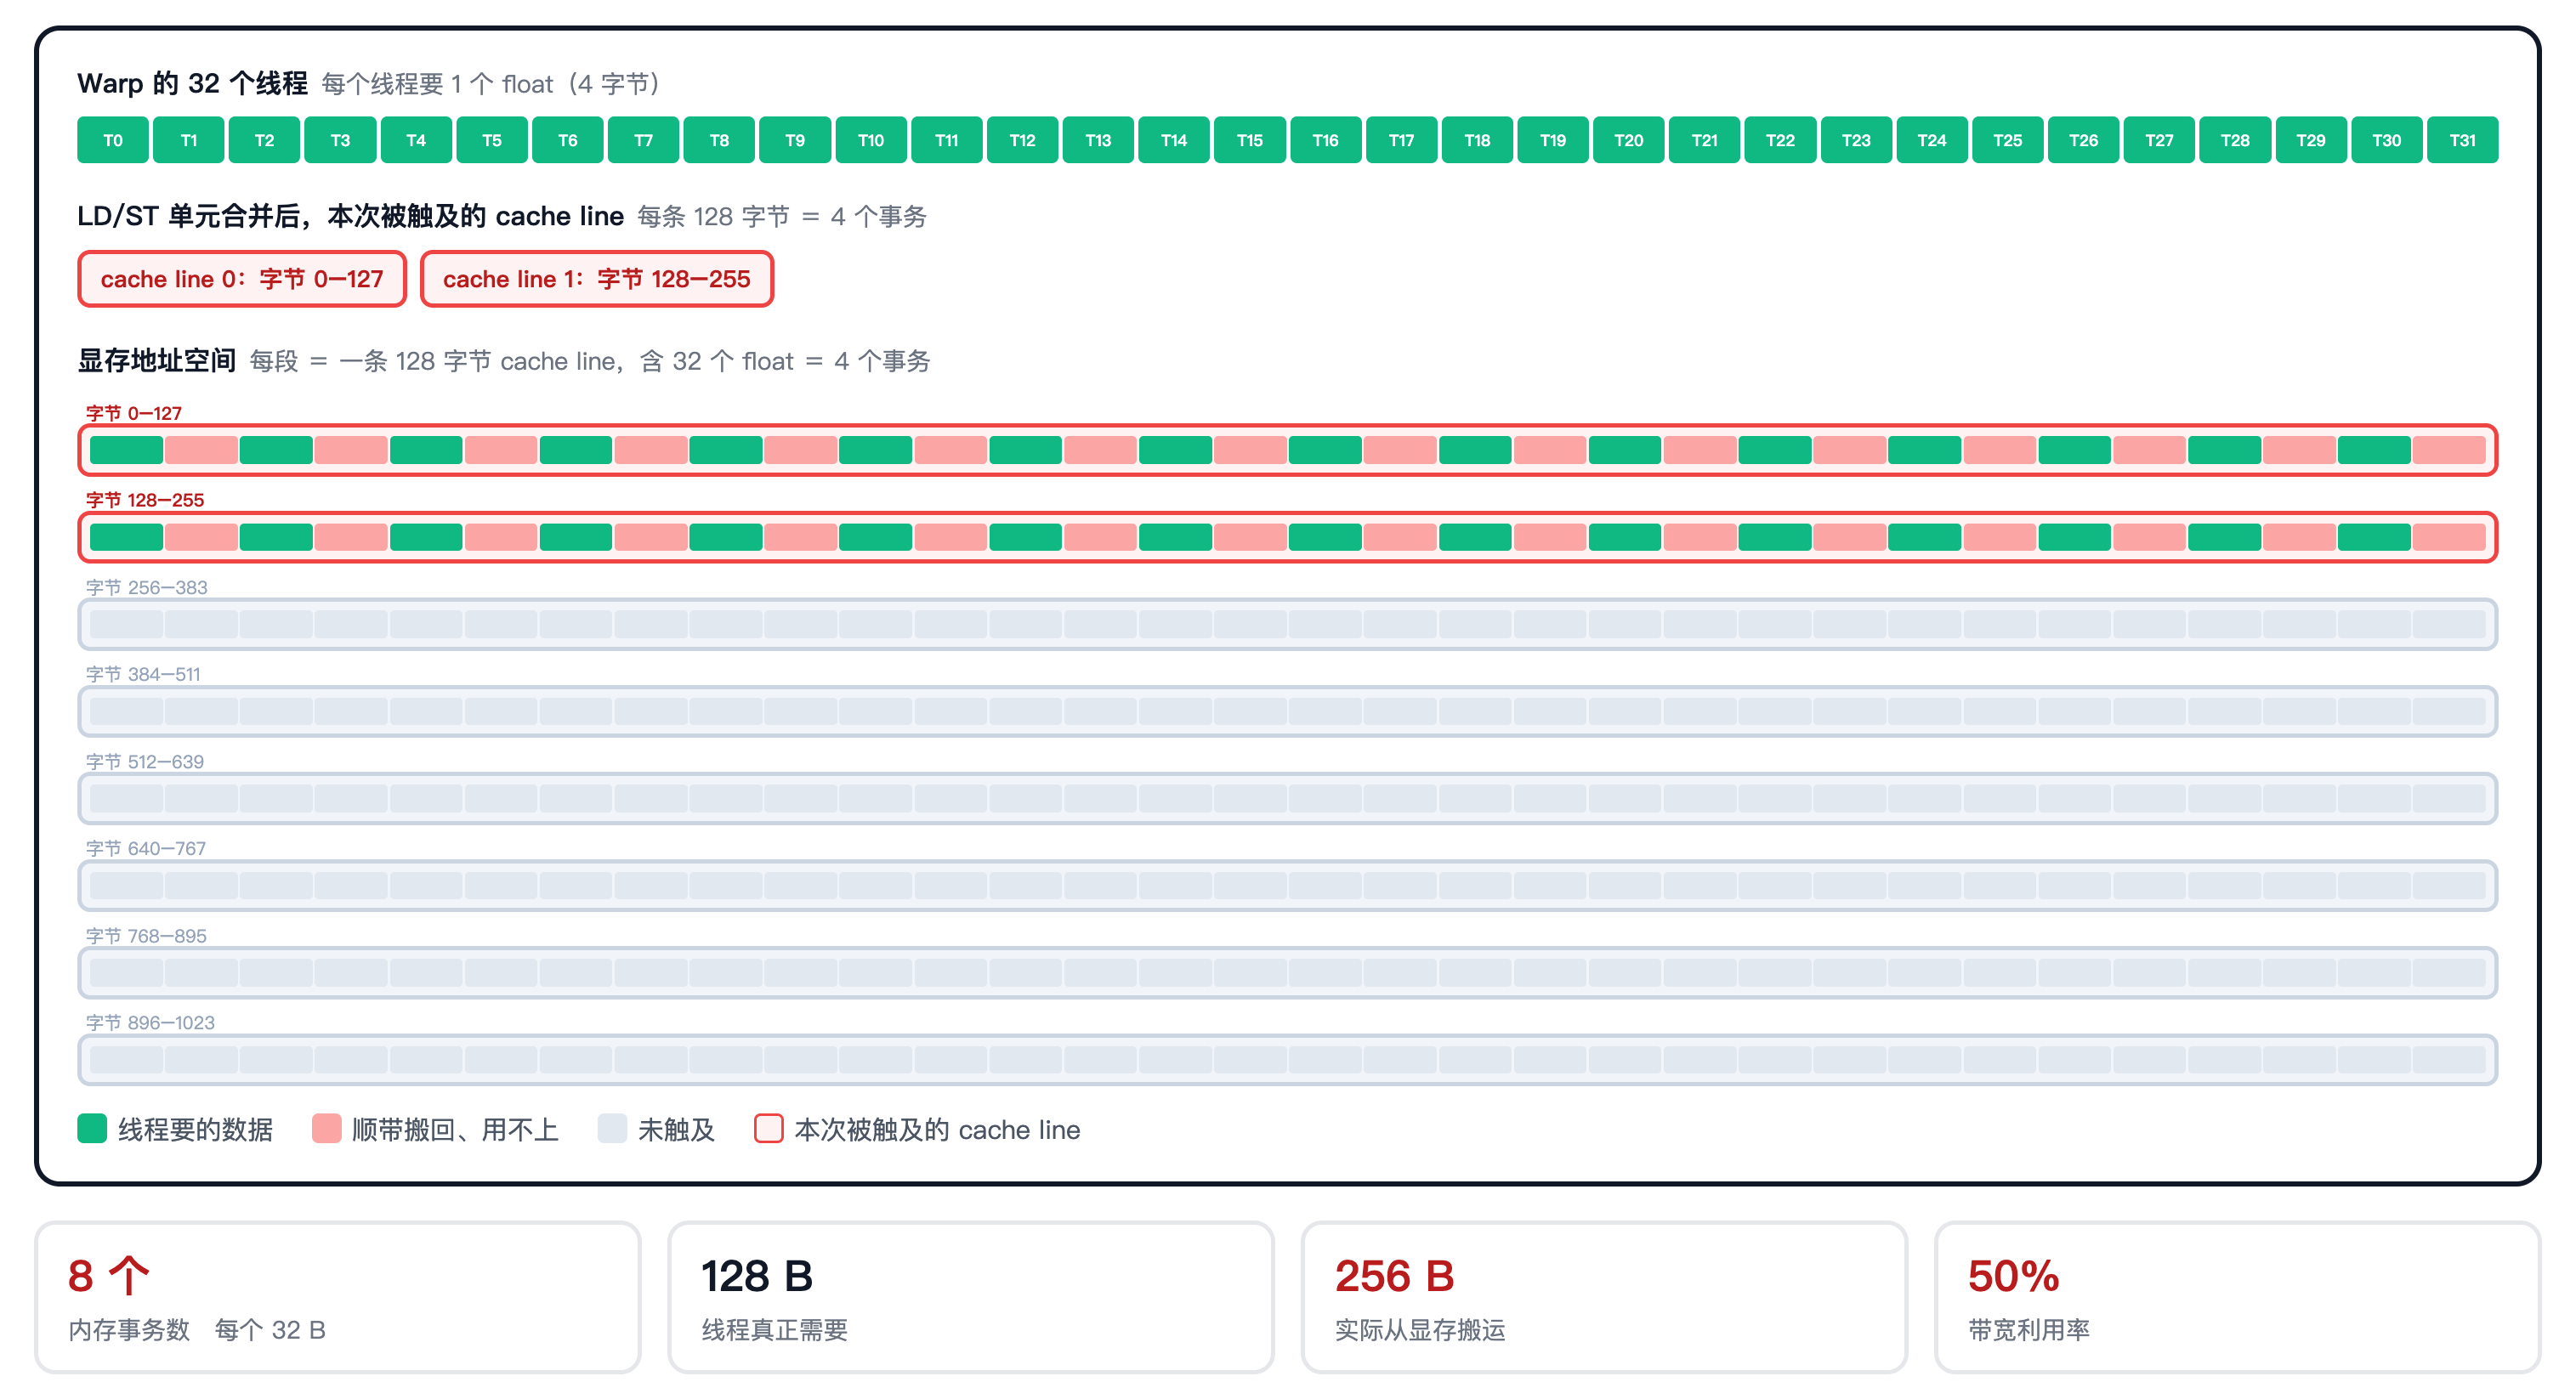
以 128 字节的内存事务为例,访问 global_data[i * 2]。线程访问 global_data[0]、global_data[2]、global_data[4]…… 跨度 8 字节,32 个地址横跨 2 个事务段。需要 2 个事务搬回 256 字节,其中只有 128 字节有用,另 128 字节(红色部分)白搬,一半的带宽被浪费。
更极端的,访问 global_data[i * 32],需要 32 个事务搬回 4096 字节,而真正要用的只有 128 字节。带宽利用率仅 3%,等于浪费了 97% 的显存带宽。
起点错位访问发起的内存事务
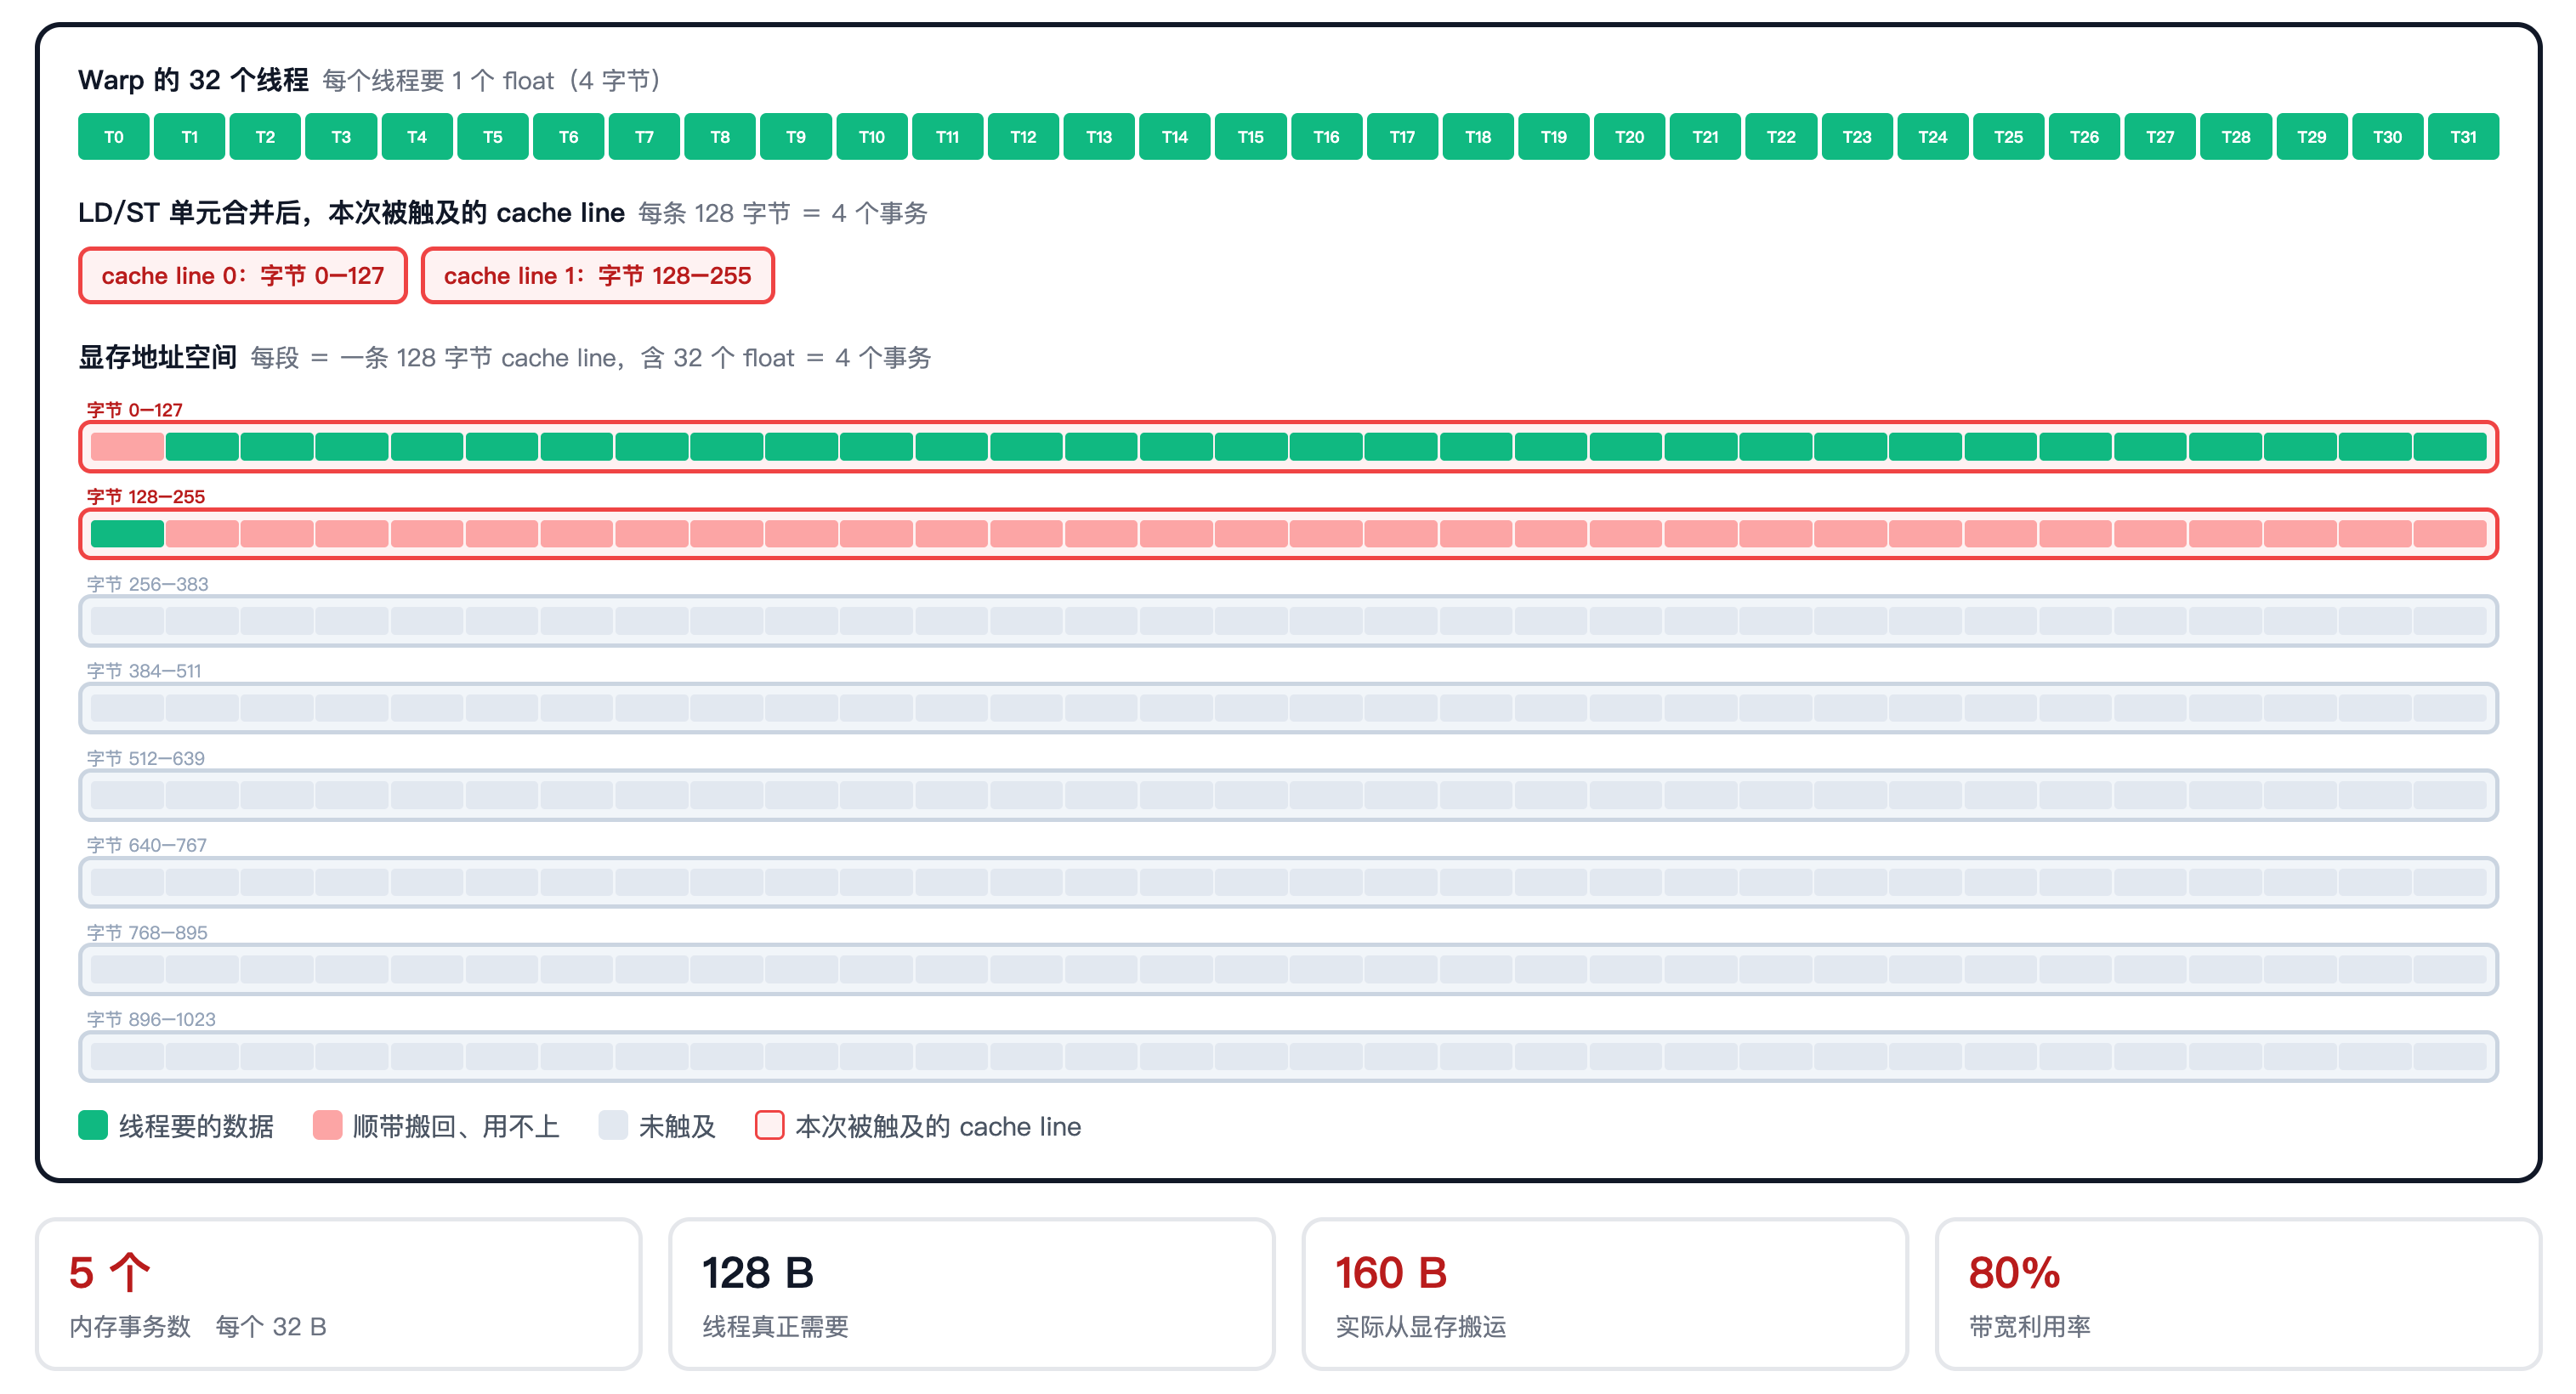
以 128 字节的内存事务为例,访问 global_data[i + 1]。访问 global_data[1] 到 global_data[32],数据依然连续,合计也是 128 字节。但起点在字节 4,不是 128 的整数倍,违反了自然对齐要求,于是这段数据横跨两个事务段。需要 2 个事务,带宽利用率降到 50%。
优化合并访存
- 让相邻线程访问相邻数据
int i = blockIdx.x * blockDim.x + threadIdx.x;
float v = data[i];        // ✓ 相邻线程访问相邻地址
float v = data[i * 32];   // ✗ 地址分散,事务暴增
- 用 SoA 替代 AoS
// AoS 结构体数组
// AoS:访问 p[i].x 时,相邻线程地址相差 12 字节 ✗
struct { float x, y, z; } p[N];

// SoA 数组的结构体
// SoA:访问 x[i] 时,相邻线程地址相差 4 字节 ✓
struct { float x[N], y[N], z[N]; } p;
-
保证起始地址对齐
cudaMalloc 返回的指针天然按 256 字节对齐,自行偏移后可能破坏对齐。二维数组建议用 cudaMallocPitch,它会自动补齐每行的宽度。