异构系统
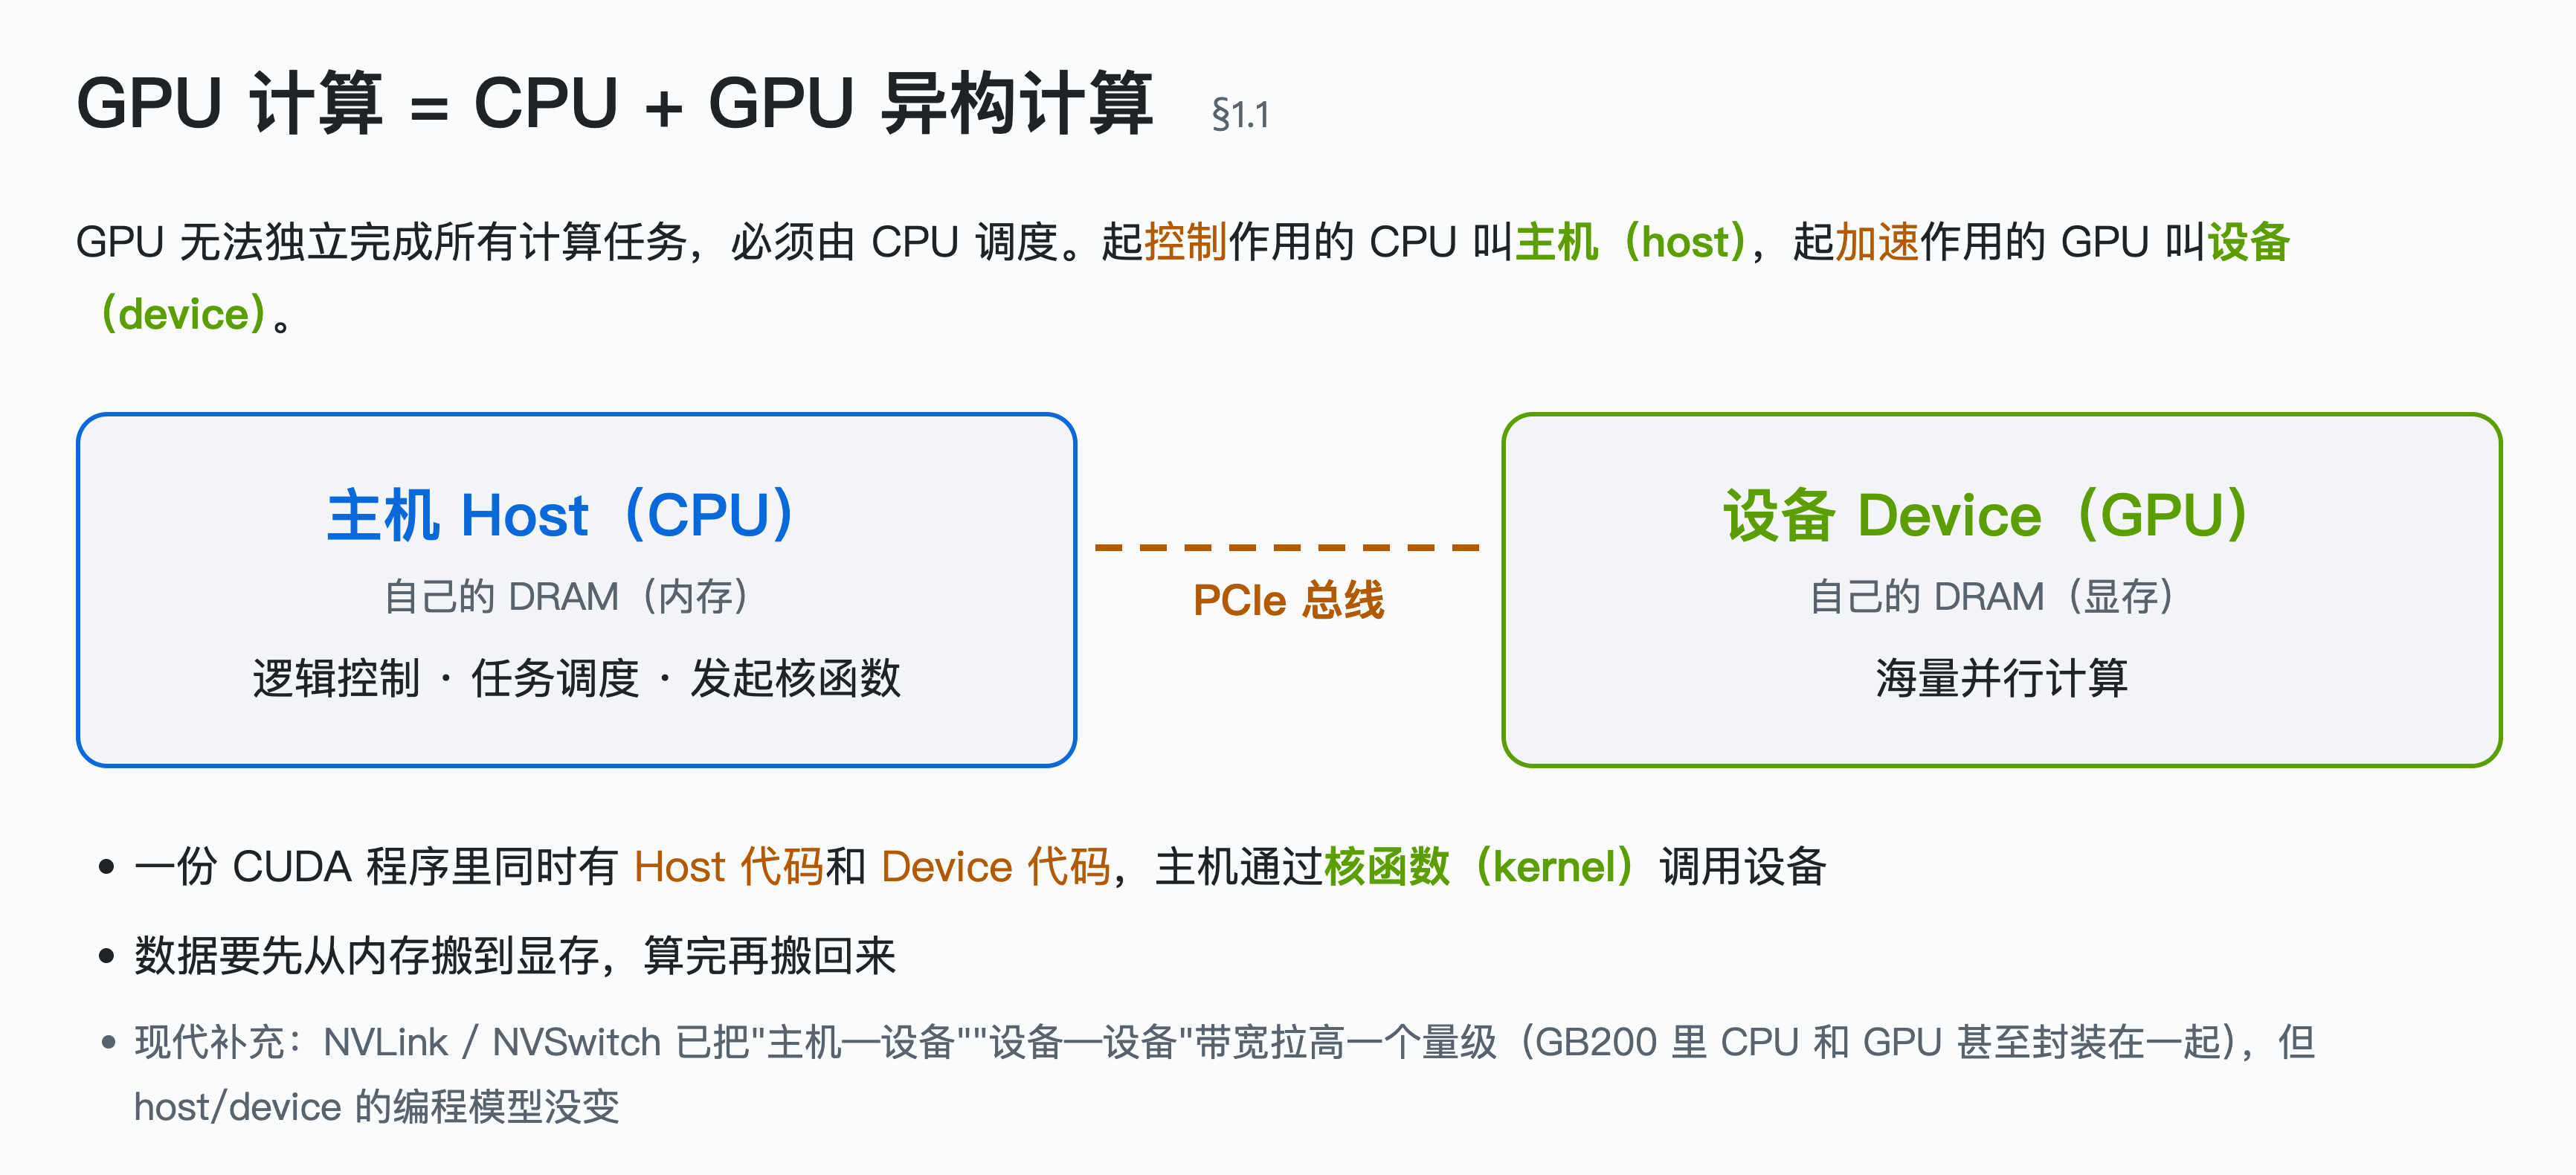
CUDA 编程模型是基于 CPU + GPU 的异构计算系统。与 CPU 直连的内存被称为主机内存 host memory,与 GPU 直连的内存称为设备内存 device memory。
CUDA 程序会在 GPU 上执行部分代码,但整个程序的执行仍然始于 CPU。在 CPU 上运行的代码称为 host 代码,在 GPU 上运行的代码称为 device 代码。host 代码可以使用 CUDA API 在主机内存和设备内存之间传输数据,启动在 GPU 上的代码执行,并等待数据传输或 GPU 代码的完成。
CPU 和 GPU 可以同时执行代码,以获得最佳性能。
GPU 硬件结构
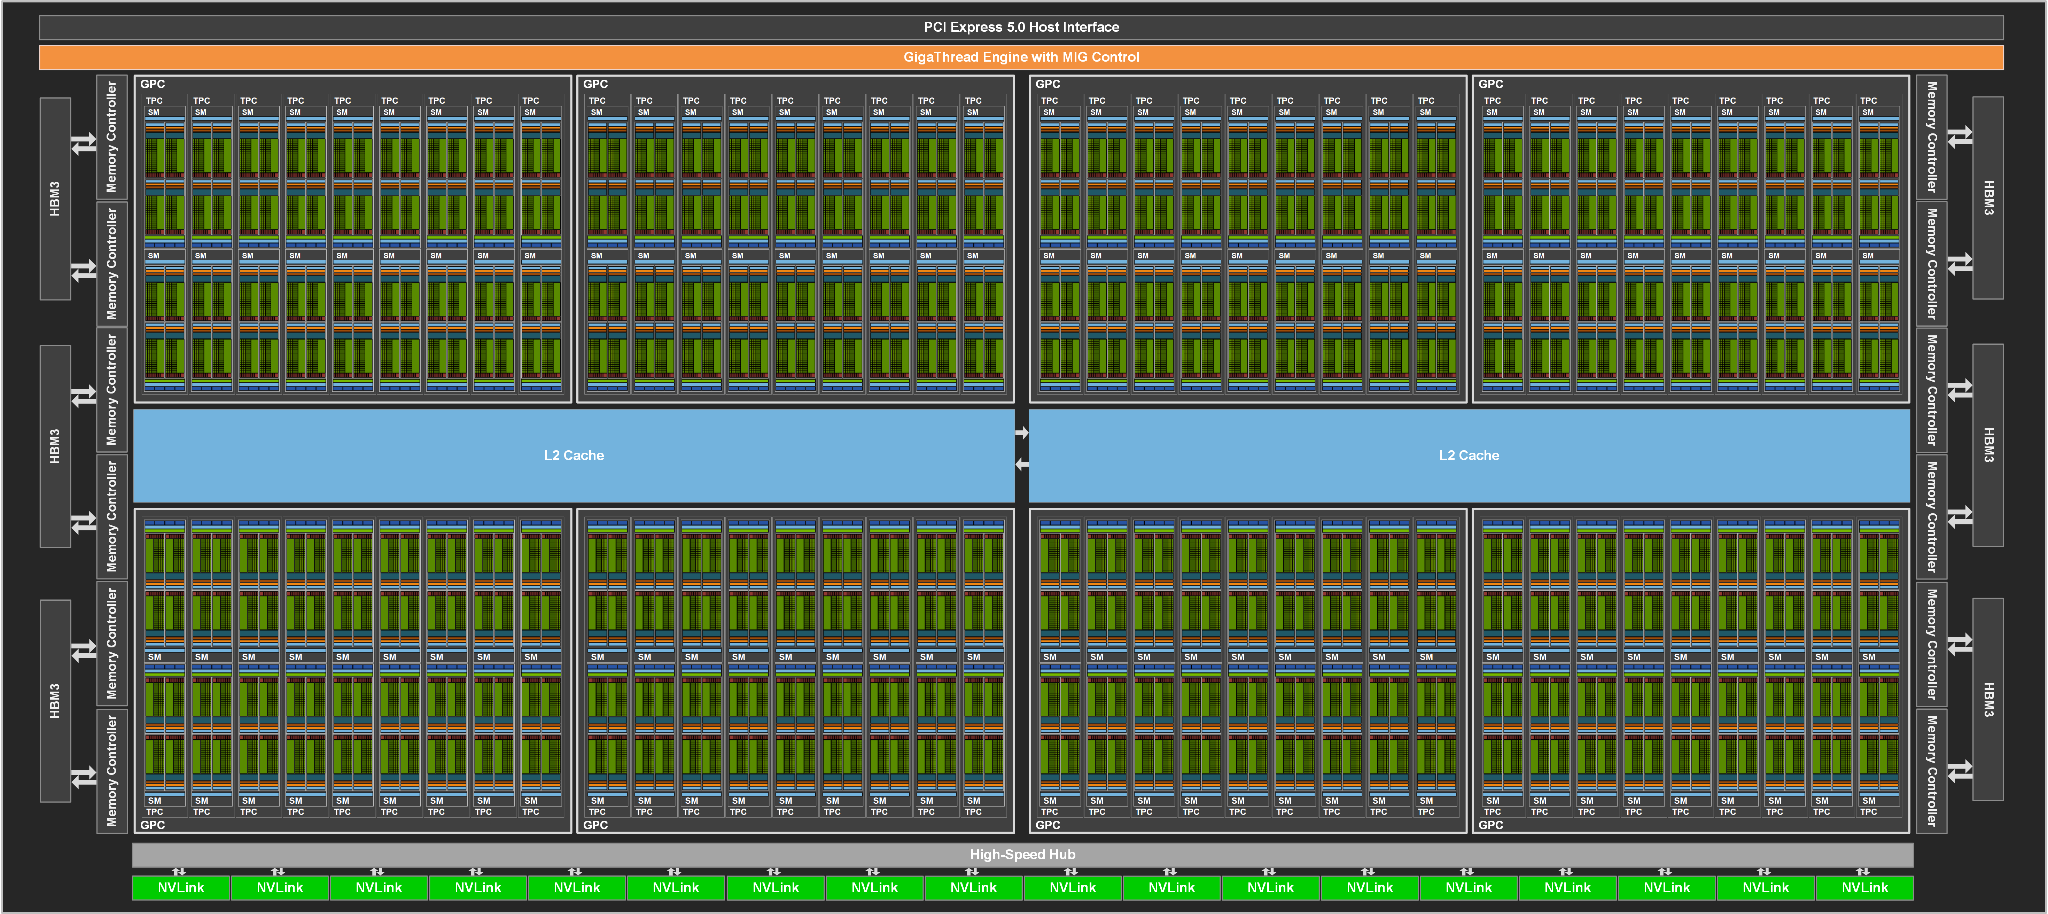
这是一张 NVIDIA GH100 GPU 的架构图,来源于《NVIDIA H100 白皮书》中的 Figure 6。从上而下的,依次查看 GPU 中的硬件构成。
GPU 硬件架构总览
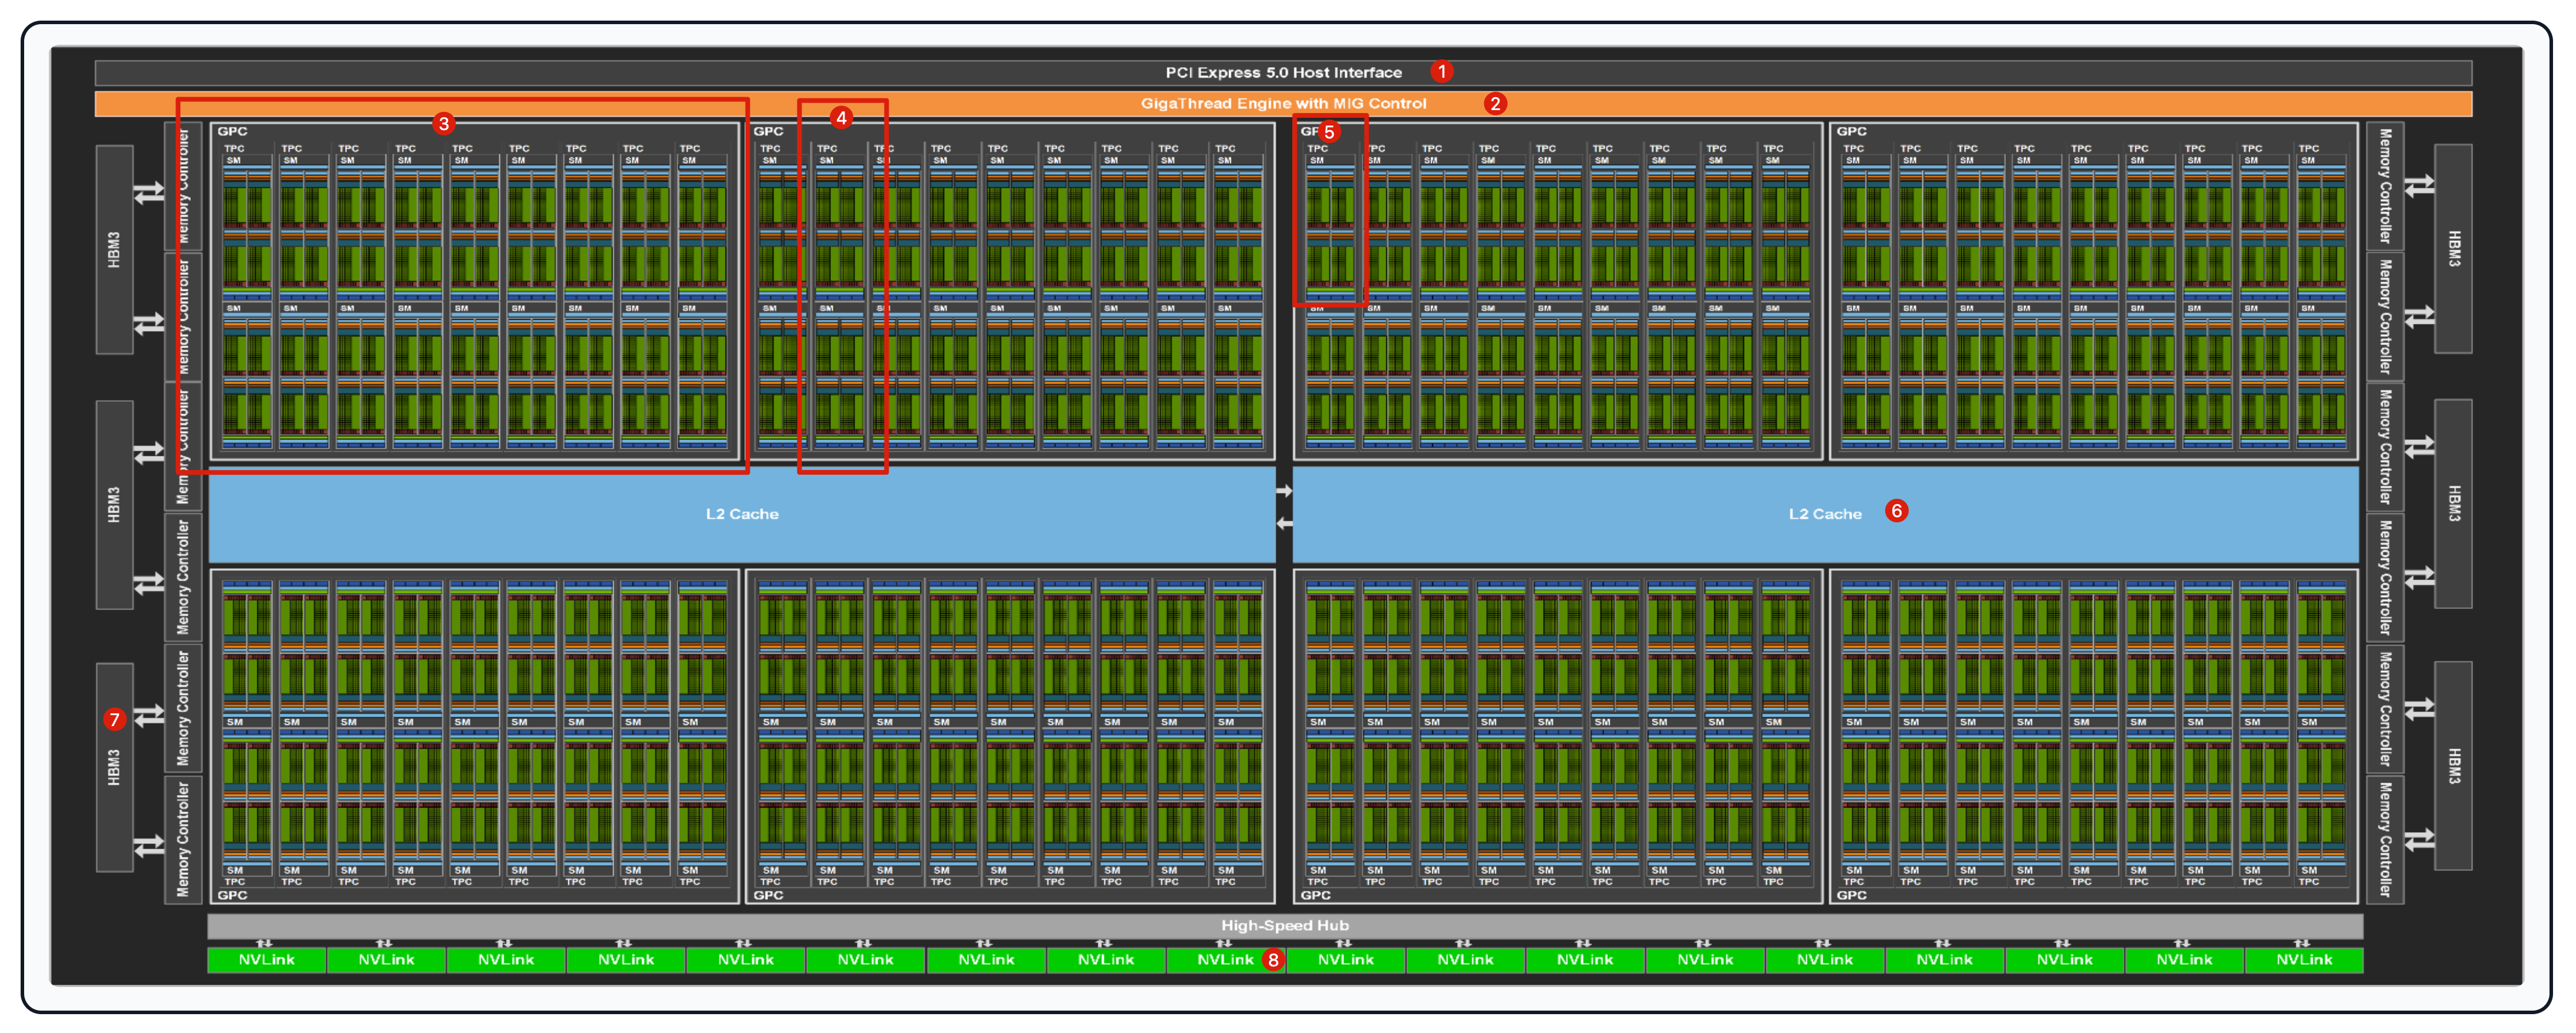
| 图中序号 | 硬件 | 作用 | 备注 |
|---|---|---|---|
| ① | PCI Express 5.0 | 主机接口。CPU 通过它把数据和 kernel 启动命令送进 GPU,也是 cudaMemcpy 的路径。 | 最顶部深灰条 |
| ② | GigaThread Engine | 全局调度器。kernel«<grid, block»> 启动后,GigaThread Engine 将 grid 中的 block 分发至各个空闲 SM。 它是两级调度体系的第一级:芯片级由它把 block 发到 SM,SM 级再由各自的 Warp Scheduler 把 warp 发到执行单元。 MIG Control:MIG(Multi-Instance GPU)把整卡切成多个互相隔离的 GPU 实例(具体数量因卡而异,有的卡不支持 MIG),供多租户共用一张卡。用 nvidia-smi mig 命令预先划分。 二者是先划分、后调度的关系:MIG 划定边界,GigaThread 只在边界内派发 block。 开启 MIG 后 kernel 只能用到本实例的 SM 与显存带宽,跨不到其它实例。不开 MIG 时整卡即一个实例,GigaThread 面向全部 132 个 SM 调度。 |
顶部橙色长条 |
| ③ | GPC | Thread Block Cluster 对应的硬件层级。Graphics Processing Cluster,一组物理位置相邻的 SM。 一个 cluster 必须整个装进一个 GPC,因为簇内跨 SM 通信走的是 GPC 内部的专用互联。 | 中间 8 个大方框 |
| ④ | TPC | Texture Processing Cluster,GPC 与 SM 之间的一层封装。在 CUDA 编程模型中完全不可见。 换算整卡 SM 总数:8 GPC × 9 TPC × 2 SM = 144 SM |
GPC 内的小分组 |
| ⑤ | SM | Thread Block 实际执行的地方。Streaming Multiprocessor,执行线程的单元,数量决定整卡算力规模。 | GPC 里一格格小竖条 |
| ⑥ | L2 Cache | 全卡所有 SM 共享的二级缓存。图上分为左右两半,中间有互联相通。 完整访存层次为 L1(每 SM 私有)→ L2 缓存(全卡共享)→ HBM3 显存,越靠外容量越大、延迟越高,命中 L2 缓存即无需访问 HBM3。 |
正中间蓝色大条 |
| ⑦ | HBM3 | 全局内存(显存),即 cudaMalloc 分配的地方。High Bandwidth Memory,堆叠式显存。 Memory Controller 是访存控制器,负责实际收发这些请求。 |
左右两侧竖条 |
| ⑧ | NVLink | 卡间高速互联,用于多卡训练时 GPU 直接交换数据,不必绕经 CPU 和 PCIe。上方 High-Speed Hub 是它的汇聚点。 | 最底部绿色条 |
SM 架构
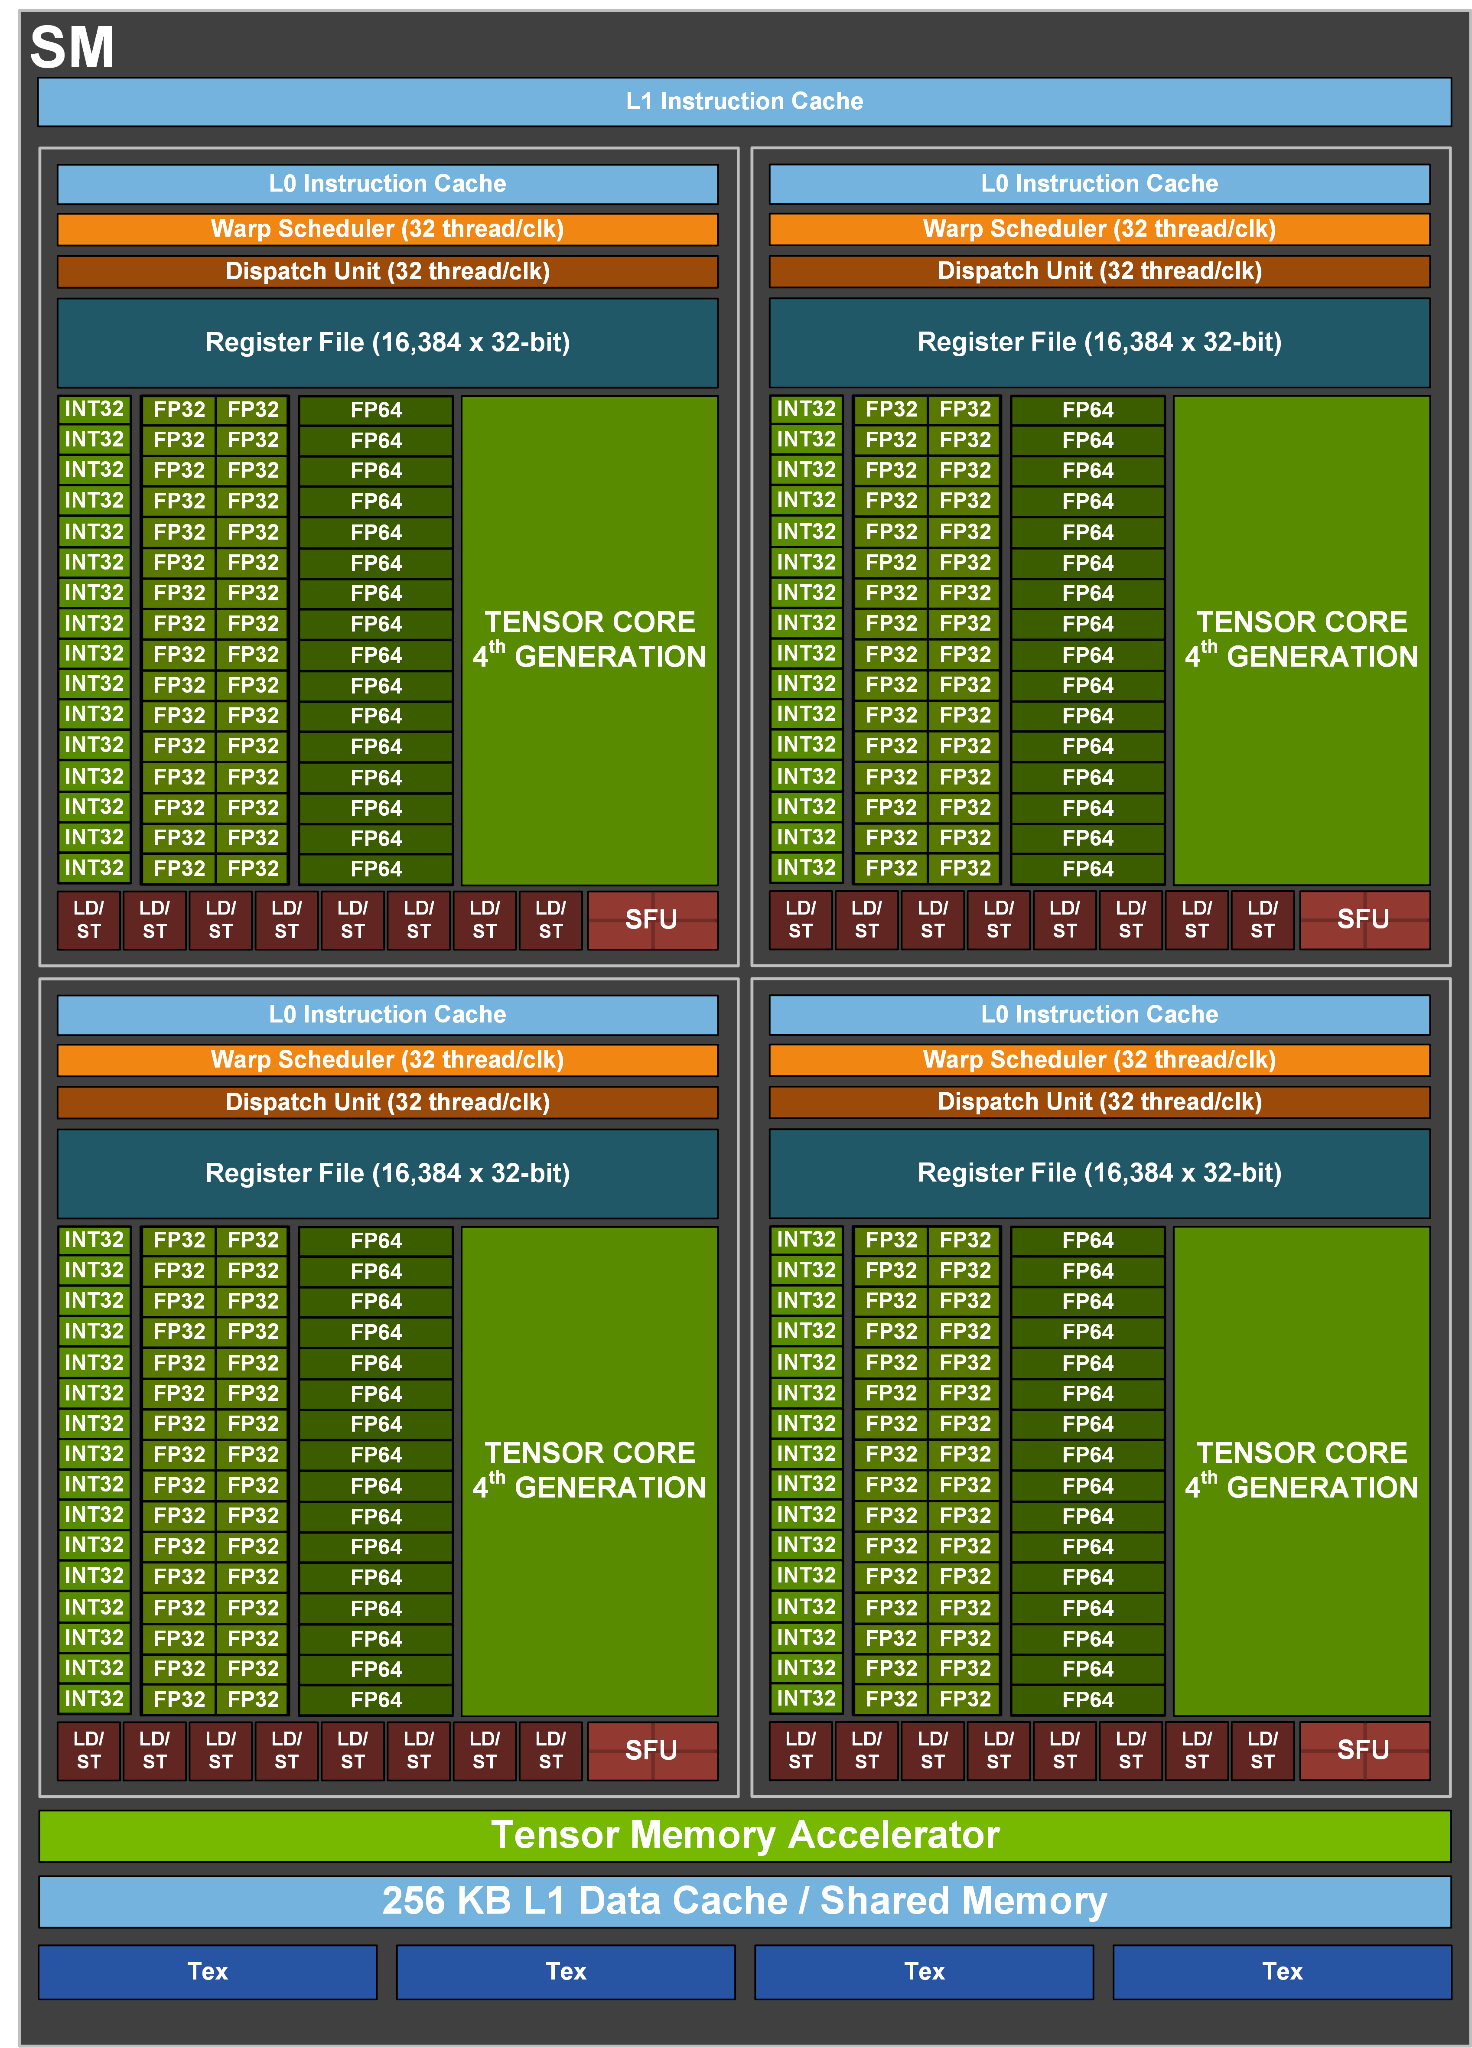
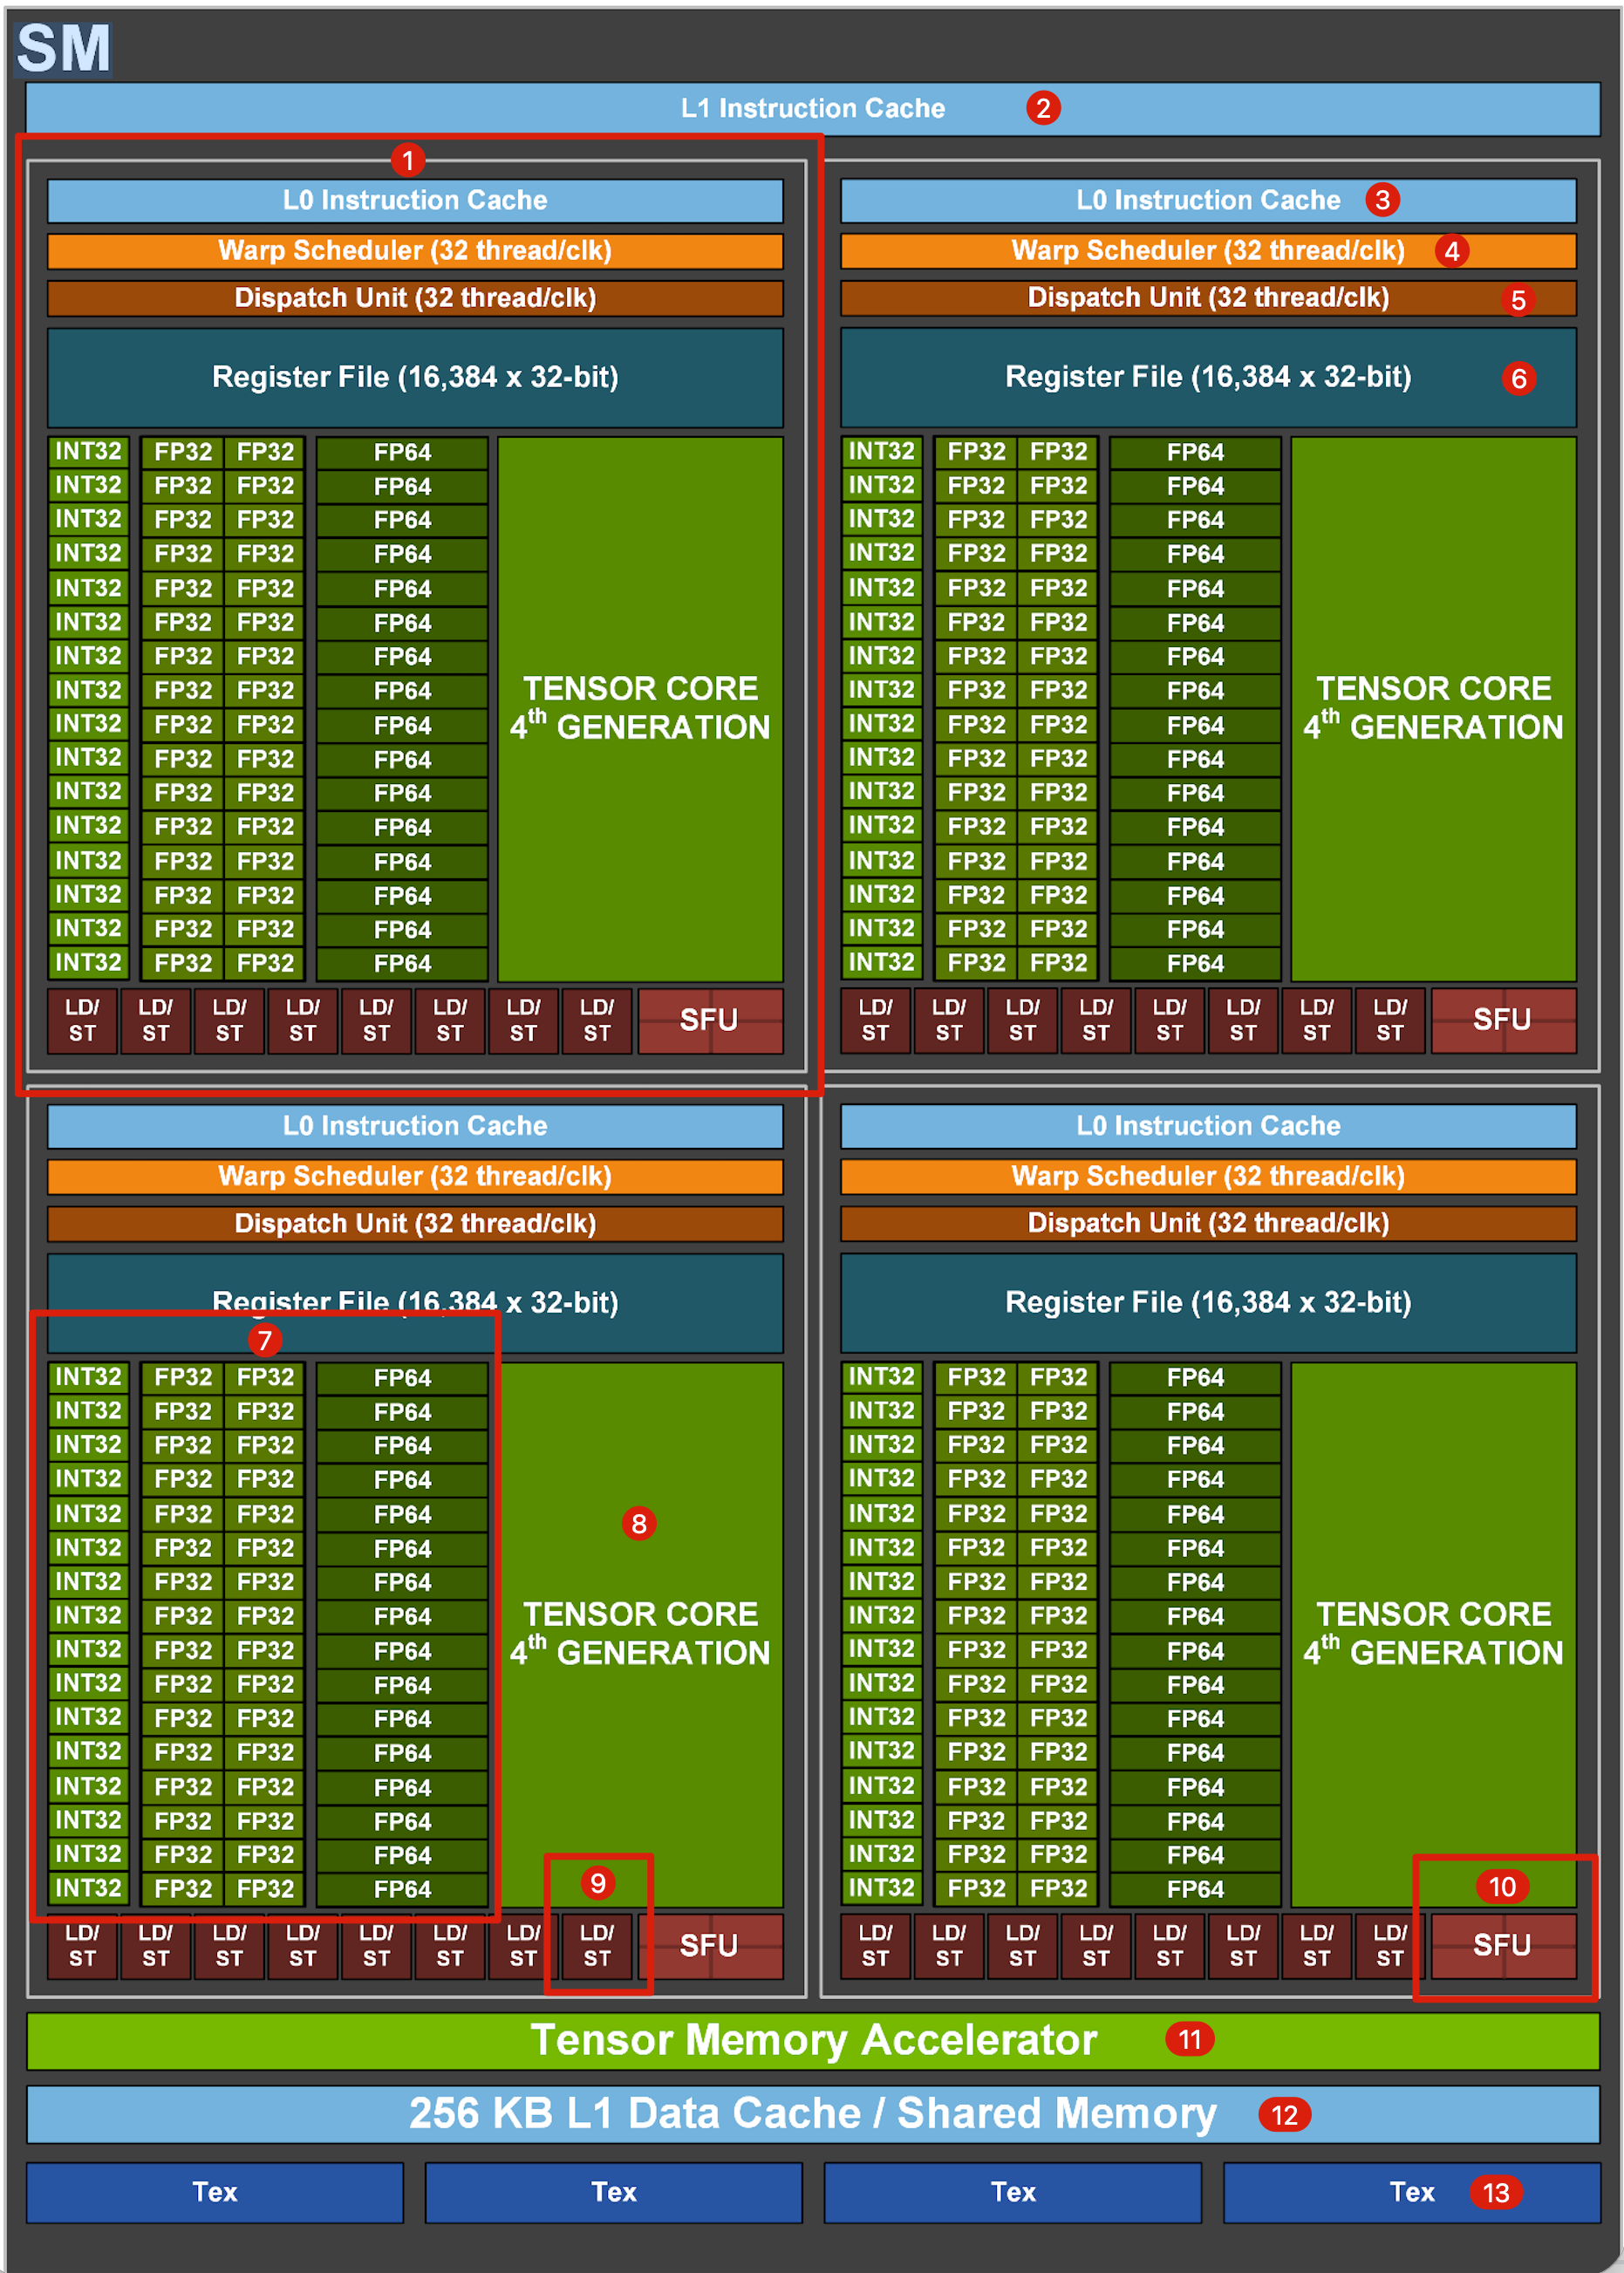
这是一个 SM 内部的硬件架构示意图,来源于《NVIDIA H100 白皮书》中的 Figure 7。从上而下的,依次查看 SM 中的硬件构成。
| 图中序号 | 硬件 | 作用 | 备注 |
|---|---|---|---|
| ① | Processing Block | 处理块 / 分区。H100 的一个 SM 被切成 4 份(绝大多数是 4,因卡而异)。 每份自带独立的调度器、寄存器堆和运算单元。 |
图中 4 个大方块 |
| ② | L1 Instruction Cache | 指令缓存,非数据缓存。kernel 编译后的机器指令存放于显存,取指令同样存在延迟,因此在片上缓存。此项由 4 个 Processing Block 共用。 | 最顶部蓝条(整 SM 一条) |
| ③ | L0 Instruction Cache | 容量小于 L1、速度更快,每个 Processing block 私有。取指令路径为 显存 → L1 Instruction Cache → L0 → 调度器,越靠近执行单元延迟越低。 | 每个方块内的顶部蓝条 |
| ④ | Warp Scheduler | warp 的调度者,每个 Processing Block 1 个、整 SM 共 4 个(因卡而异)。 在数十个驻留 warp 中选择处于就绪态的发射指令。warp 因访存阻塞时立即切换至其它 warp,切换不引入额外开销,以此掩盖访存延迟。 clk:clock cycle(时钟周期),硬件最小节拍。32 thread/clk,一个时钟周期可以发射 32 个线程,正好是一个完整 warp。 |
橙色条,标 32 thread/clk |
| ⑤ | Dispatch Unit | 分发单元。调度器选定 warp 后,由其将指令发送至对应的执行单元:浮点运算送 FP32,访存操作送 LD/ST。 调度器决定发射哪个 warp,分发单元决定送往哪类单元。 |
深橙色条,32 thread/clk |
| ⑥ | Register File | 线程私有变量的存储位置,也是 GPU 上访问最快的存储层级。 每个 Processing Block 16,384 个 32 位寄存器,4 × 16,384 = 65,536(64K)个 / SM = 256 KB。 单线程占用越多,SM 可同时驻留的线程数越少,直接决定占有率。 |
深蓝色条,16,384 × 32-bit |
| ⑦ | FP32 / INT32 / FP64 | CUDA core(早期叫 SP),真正做算术的单元。 每个 Processing Block 包含:2 列 FP32 × 16 = 32 个 FP32、1 列 INT32 = 16 个、1 列 FP64 = 16 个。 CUDA core 总数的计算,只包括 FP32。即 32 个 FP32 × 4 个 Processing Block = 128 个 FP32/SM,再 × 132 个 SM = 16,896 个 CUDA core CUDA 核心数 ≠ 运算单元总数 |
成列的绿色小格 |
| ⑧ | Tensor Core | 矩阵乘加专用单元,与 CUDA core 并列但功能不同。CUDA core 单条指令处理一个标量,Tensor Core 单条指令完成一个小矩阵的乘加,吞吐高出一至两个数量级。 卷积与 Attention 的核心计算均为矩阵乘,因此 Tensor Core 的吞吐决定训练和推理性能,支持 FP8/FP16/BF16/TF32 等精度。 普通 CUDA 代码不会自动使用,需经 cuBLAS 等接口调用。 |
大块亮绿部分,每个 Processing Block 1 个 |
| ⑨ | LD/ST | LD:Load(读),ST:Store(写),合称访存单元。 线程读写共享内存或显存的请求都由它执行,并将一个 warp 的 32 个地址合并(coalescing)为尽可能少的内存事务。 合并访存优化作用于此环节。 |
底部暗红小格,每个 Processing Block 8 个,因卡而异 |
| ⑩ | SFU | Special Function Unit(特殊函数单元),用硬件直接算 sin / cos / exp / log / 平方根 / 倒数。 数量远少于 FP32 单元,此类函数密集时构成瓶颈。 |
底部暗红方块,每个 Processing Block 1 个 |
| ⑪ | Tensor Memory Accelerator | 简称 TMA。用于在显存与共享内存之间异步传输大块数据,传输期间计算单元继续执行,线程无需等待。通常配合 Tensor Core 使用。 | 底部亮绿长条(整 SM 一条) |
| ⑫ | 256 KB L1 Data Cache / Shared Memory | 共享内存与 L1 数据缓存所在地,整个 SM 共用一块,也是同一 block 内线程共享数据的物理载体。L1 数据缓存与共享内存为同一块物理 SRAM,按比例划分。 二者的区别在于由谁管理: 共享内存( __shared__)由程序显式分配、读写与同步L1 数据缓存由硬件自动管理,访问全局内存时自动缓存,代码中无对应语法,可通过访存局部性提高命中率,或用 cudaFuncSetAttribute 调整两者的划分比例。 注意与 L1 / L0 Instruction Cache 区分,那是指令缓存,与此处的数据缓存相互独立。 |
最底部蓝色长条(整 SM 一条) |
| ⑬ | Tex | 纹理单元,图形渲染中用于贴图采样。通用计算中仅在使用纹理内存(texture memory,提供硬件插值与边界处理)时涉及。 常规 CUDA 代码不使用。 |
最底部蓝色小格 |
此外,我们常说的片上、片下,指的是整块 GPU 硅片。「片上」是 on-chip 的中文译法,指在 GPU 芯片内部,与之相对的是 off-chip「片外」,分界线是显存 HBM3。
- 片上 on-chip:L1/L0 指令缓存、共享内存、L1 数据缓存、寄存器、L2 缓存,都刻在同一块硅片上
- 片外 off-chip:HBM3 显存,是独立的存储芯片,通过封装基板与 GPU 相连
访存延迟
| 访问位置 | 延迟(周期) | 说明 |
|---|---|---|
| 寄存器 | ~1 | 线程私有,最快 |
| 共享内存 / L1 | ~20–30 | 片上,SM 内 |
| L2 缓存 | ~200 | 片上,全卡共享 |
| HBM3 显存 | ~400–600 | 一次访存 ≈ 几百条算术指令的时间 |
一次显存访问的时间,够执行几百条算术指令。如果一个 warp 发出访存请求后就一直等待,那这几百个周期里执行单元完全闲置。
CPU 通过完善的控制逻辑来应对访存延迟,如大容量缓存、分支预测、乱序执行、预取等,减少访存次数并避免停顿。而 GPU 则通过海量 warp 轮转来掩盖访存延迟,当某个 warp 因访存阻塞时,SM 的 Warp Scheduler 立刻转向下一个就绪的 warp。GPU 掩盖访存延时依赖于 warp 切换的零开销。
CPU 线程切换要保存或恢复寄存器上下文,代价上千周期。而 GPU 上,每个 warp 的寄存器是一直独占的、不搬走的。这正是每个 SM 中 64 K 寄存器的用途,64 个 warp 的上下文全部常驻在寄存器堆里。切换只是调度器换一个索引,不涉及任何数据搬运,因此不花周期。
SM 的 warp 约束
寄存器容量约束
为了 GPU 线程切换的零开销,每个线程的上下文必须常驻在寄存器中。而数据一旦常驻,寄存器的容量就成为约束。
每个 SM 上可驻留的线程数 = 每个 SM 的寄存器总个数 / 每线程占用寄存器个数 = 每个 SM 的寄存器总容量 / 每线程占用寄存器容量
以 H100 举例,每个 SM 的寄存器个数为 16384 * 4 = 65536 个,寄存器总容量为 64KB * 4 = 256 KB。
如果每线程占用 32 个寄存器,每线程占用寄存器容量 32 * 32 b = 0.125 KB,则每个 SM 上可驻留的线程数 = 64K / 32 = 256 KB / 0.125 KB = 2048 个,换算成 warp 为 2048 / 32 = 64 个。
共享内存容量约束
SM 细节图中的「256 KB L1 Data Cache / Shared Memory」(序号 ⑫)部分,是共享内存(程序显式分配)与 L1 数据缓存(硬件自动管理)所在地。共享内存是同一 block 内线程共享数据的物理载体。
共享内存的生命周期等于 block 的生命周期,从 block 被调度到 SM,直到 block 执行结束,这块内存一直分配给该 block,期间不能被换出或让给其他 block。这与寄存器同理,为保证 warp 切换零开销,驻留对象的状态必须常驻片上,因此共享内存的容量也成为驻留数量的约束。
以 H100 举例,SRAM 总共 256KB,其中共享内存最多可配置到 228KB,划分比例可使用 cudaFuncSetAttribute 调整。
需注意 CUDA 默认每个 block 最多能占用 48KB 共享内存,超过 48KB 必须使用动态分配(extern __shared__ + 启动参数)并通过 cudaFuncSetAttribute 显式 opt-in,否则 kernel 启动失败。
假设声明每个 block 占用的共享内存大小为 114KB,每个 SM 上最多可驻留 228KB / 114KB = 2 个 block。实际驻留的线程数还取决于 block 大小,假设每个 block 含 256 个线程,即最多可驻留 512 个线程,换算成 warp 为 512 / 32 = 16 个。warp 占有率 = 实际驻留的 warp 数 / 硬件上限 = 16 / 64 = 25%。
block 槽位约束
每个 SM 要同时管理多个驻留 block,需要给每个 block 分配一套管理资源,如 block 索引、同步屏障计数器、共享内存基址寄存器等。这些管理槽位的数量在芯片设计时就已经确定。block 槽位就是一个 SM 能同时「记住」多少个 block 的位置数。与寄存器、共享内存不同,它不是「容量 / 每线程占用量」算出来的,而是硬件的记账位数上限。
以 H100 为例,每个 SM 最大的 block 槽位是 32 个,即同一时刻最多有 32 个 block 驻留在同一个 SM 上。
总结
| 约束 | 本质 | H100 为例 |
|---|---|---|
| 寄存器 | 容量 / 每线程占用量 | 65536 个 |
| 共享内存 | 容量 / 每线程占用量 | ≤ 228 KB |
| block 槽位 | 硬件固定的管理位数 | 32 个 |
CUDA 编程模型
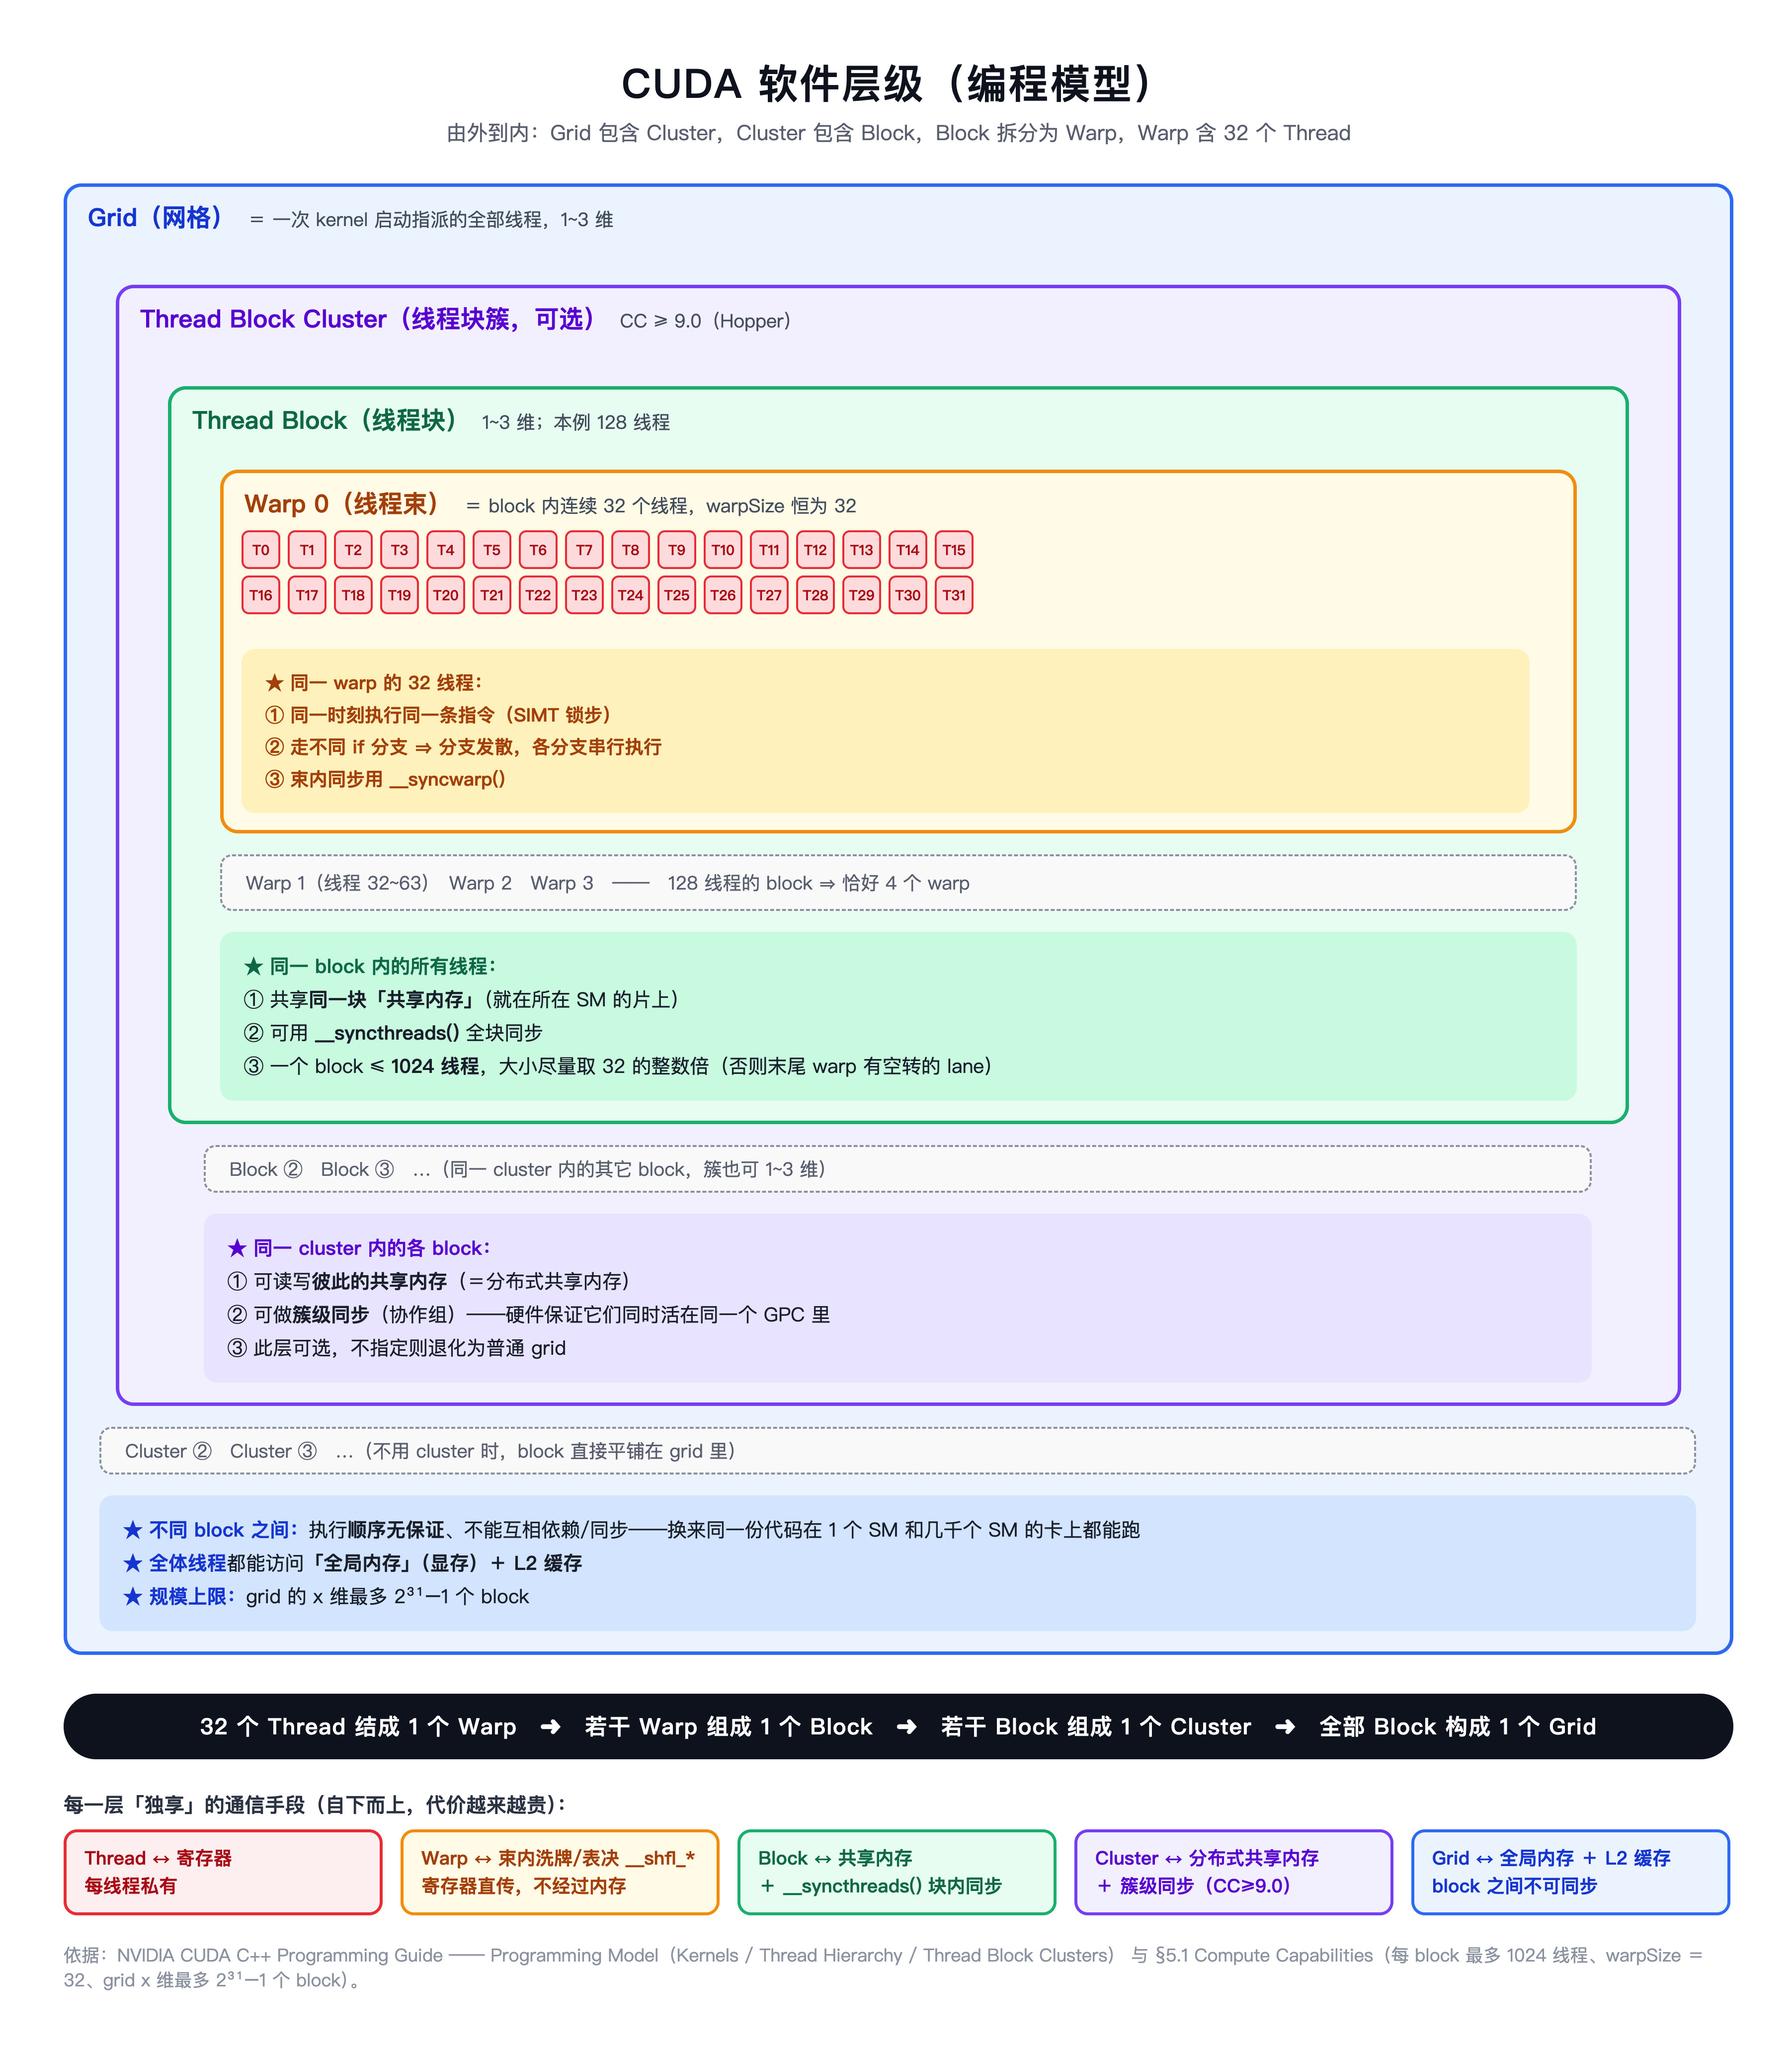
| 概念 | 作用 | 数据交换/同步范围 | 速度 | 备注 |
|---|---|---|---|---|
| Thread 线程 |
计算逻辑的最小执行单位。kernel 代码就是一个线程的视角,靠下标区分各自处理哪份数据(SIMT)。 | 仅自己可见,每个线程的私有变量,存放于寄存器中 | - | - |
| Warp 线程束 |
硬件调度的最小单位。32 线程锁步执行同一条指令,走不同分支会串行执行各分支(分支发散)。故 block 大小应取 32 的整数倍。 | 同一 warp 内的线程 可通过硬件指令寄存器直传(shuffle)从寄存器直接获取其他线程的私有变量。 |
1 周期 | 32 线程 |
| Thread Block 线程块 |
资源分配与同步的基本单位。整块落在一个 SM 上,绝不拆分、不迁移,跑完为止。一个 SM 可同时驻留多个 block。其大小直接决定占有率。 | 同一 block 内的全部线程 1. 共享内存(片上,SM 内) 2. __syncthreads() 块内屏障(barrier)同步 |
约 20~30 周期 | ≤ 1024 线程 |
| Thread Block Cluster 线程块簇 |
把数据复用的范围从 1 个 SM 扩大到 1 个 GPC。硬件保证同簇 block 并发驻留于同一 GPC,交换数据比绕全局内存快约 7 倍。不使用则退化为传统四层。 | 同一簇内的所有 block 1. DSMEM(分布式共享内存),经过 GPC 内的 SM-to-SM 互联网络,可直接对其它 SM 的共享内存做 load/store/atomic 2. 簇级屏障同步 |
约 60~100 周期,介于共享内存和全局内存之间 | ≤ 8 block |
| Grid 网格 |
一次 kernel 启动的作用域。block 间的独立性换来了可扩展性,同一份代码在 SM 少的卡和 SM 多的卡上都能运行,SM 越多吞吐越高。 | 同一 grid 内的所有线程 1. 都能访问全局内存(HBM 显存),对全局内存的访问统一经过全卡共享的 L2 缓存 2. block 之间不可同步 3. 跨 block 只能靠全局内存交换数据,且执行顺序无保证 |
约 400~600 周期 | 一次 kernel 启动的全部线程,≤ 2³¹−1 个 block |
SIMT
SIMT:Single Instruction, Multiple Threads(单指令多线程),NVIDIA 给 GPU 执行模型起的名字。
SIMD:Single Instruction, Multiple Data(单指令多数据),CPU 的向量指令,一条指令同时对多个数据做同样的运算。
SIMT 的核心在于,一条指令同时驱动一个 warp 的 32 个线程执行,每个线程处理不同的数据。
SIMT 的三个特点
- 指令是共享的,数据是各自的
- 写代码时是单线程视角
- 线程之间靠下标区分
锁步
锁步(lock-step),SIMT 的执行方式。而 warp 是 SIMT 的作用单位。
由于一个 warp 只有一套取指和译码逻辑,因此需要一个 warp 的 32 个线程像被锁在一起一样,同进同退,同一时刻执行同一条指令。
分支发散
分支发散,SIMT 的代价。
由于一个 warp 的 32 个线程只有一套取指和调度逻辑,同一时刻只能执行一条指令。所以当同一 warp 内的 32 个线程要走不同分支时,硬件没法做到让它们真正同时跑,只能分多趟。
if (threadIdx.x % 2 == 0) {
    A();     // 偶数号线程走这里
} else {
    B();     // 奇数号线程走这里
}
例如上面的 cuda 代码,让一个 warp 里 16 个线程走 A、16 个走 B。
硬件的做法是,第一趟:执行 A。16 个偶数线程正常计算,16 个奇数线程被屏蔽(lane 空转,什么也不做)。第二趟:执行 B。16 个偶数线程被屏蔽,16 个奇数线程正常计算。总耗时 = A 的时间 + B 的时间,而不是 max(A, B),即便每一趟都有一半线程在闲着。
分支发散只发生在 warp 内部,不同 warp 走不同分支完全没有代价,因为它们本来就是独立调度的。这也是优化分支发散的核心思路,让分支条件以 warp 为粒度对齐,而不是以线程为粒度。常见写法是把条件改成 (idx / warpSize) % 2 == 0。
Thread、Lane、CUDA Core 的区别
| 名词 | 属于 | 含义 |
|---|---|---|
| Thread | 编程模型 | CUDA 程序创建的执行实体,有 threadIdx |
| Lane | Warp 内部结构 | 0~31 的槽位编号,threadIdx.x % 32 |
| 执行单元 | 物理硬件 | 实际执行运算的电路,按指令类型分工、数量各不相同。SM 中包含的执行单元有 FP32、INT32、FP64、LD/ST、SFU、Tensor Core。 |
| CUDA Core | 物理硬件 | 执行单元中的一类。官方口径专指 FP32 单元,早期叫 SP |
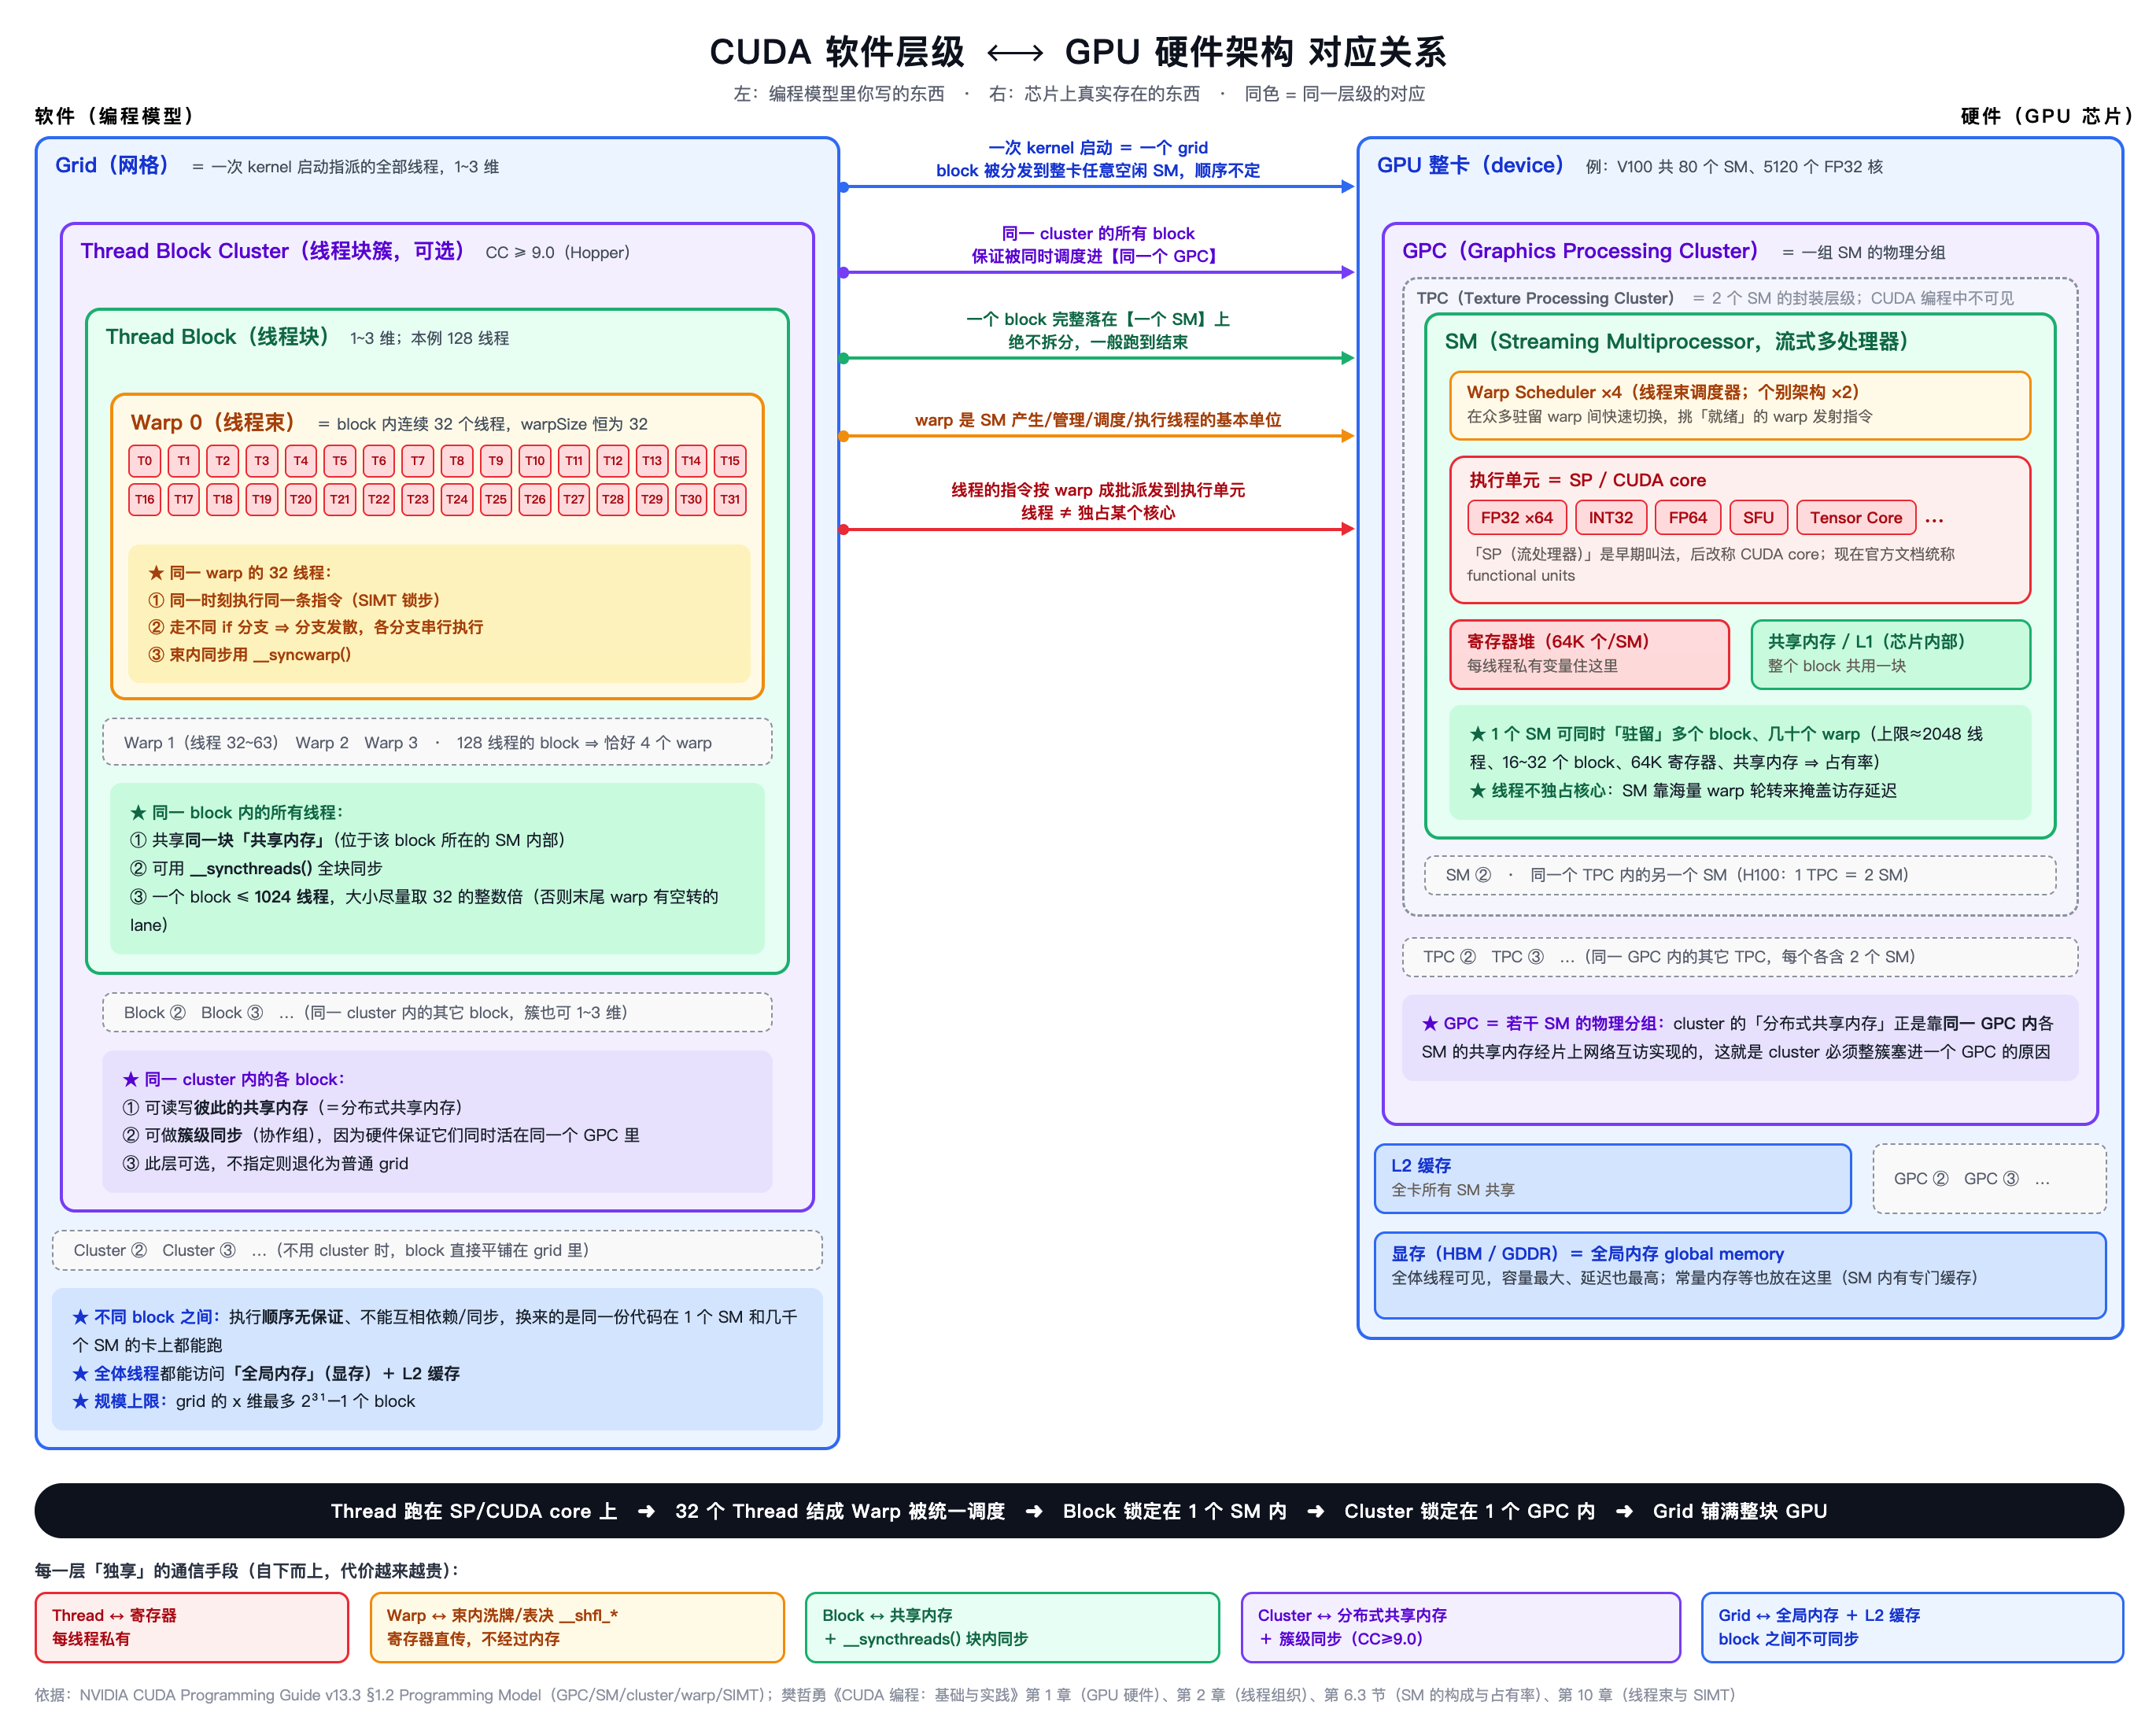
CUDA 软件层级与 GPU 硬件架构的对应关系
| 软件概念 | 硬件架构 | 说明 |
|---|---|---|
| Grid | GPU | 一次 kernel 启动对应一个 grid,一个 grid 下的所有 block 会被分发到一张 GPU 上,由 GigaThread 引擎分批派发,SM 一空出位置就补入下一个 block。 1. 不同 block 之间,执行顺序无保证、不能相互依赖/同步 2. 同一 grid 内的所有线程都能访问全局内存和 L2 缓存 |
| Thread Block Cluster | GPC | 同一 cluster 的所有 block 保证被并发调度到同一个 GPC,若不指定 cluster,则退化为普通 grid。 同一 cluster 内的各 block 1. 可读写彼此的共享内存 DSMEM,通过 GPC 内的 SM-to-SM 互联网络 2. 可做簇内同步 |
| Thread Block | SM | 一个 block 完整落在一个 SM 上,不拆分、不迁移,直到执行结束。反之,一个 SM 可同时驻留多个 block。 同一 block 内的所有线程 1. 共享该 block 独占的那块共享内存 2. 可用 __syncthreads() 全块同步 3. 一个 block ≤ 1024 线程,大小尽量取 32 的整倍数 |
| Warp | 无独立实体 由硬件按 32 线程自动切分,在 Warp Scheduler 中调度 |
同一 Warp 的 32 个线程 1. SIMT 锁步,同一时刻执行同一条指令 2. 分支发散时,各分支串行执行 3. Warp 内的线程同步,使用 __syncwarp() |
| Thread | CUDA Core | 线程不独占 CUDA Core,是临时占用执行单元的使用关系。线程执行的指令,按 Warp 成批派发到执行单元 |
附件
- CUDA C++ Programming Guide
- 《NVIDIA H100 Tensor Core GPU Architecture Whitepaper》:本文 GPU 硬件结构与 SM 架构两节的 Figure 6、Figure 7 均出自该白皮书